
 TRAE-AI编程

TRAE 自动补全不准,多半不是模型不行,而是配置没喂对。先给结论:补全质量主要由四个配置项决定——上下文范围、触发时机、模型选择、忽略规则;按顺序把这四个调一遍,八成的「答非所问」能立刻好转。很多人一不准就换模型,结果换了一圈还是老样子,其实卡在上下文根本没包含关键文件。下面按「先看上下文范围 → 再调触发时机 → 然后选对模型 → 最后设忽略规则」的顺序讲清每个配置项的用法与边界,照着调能少踩坑,也能学会什么时候该信补全、什么时候要自己写。
先看结论
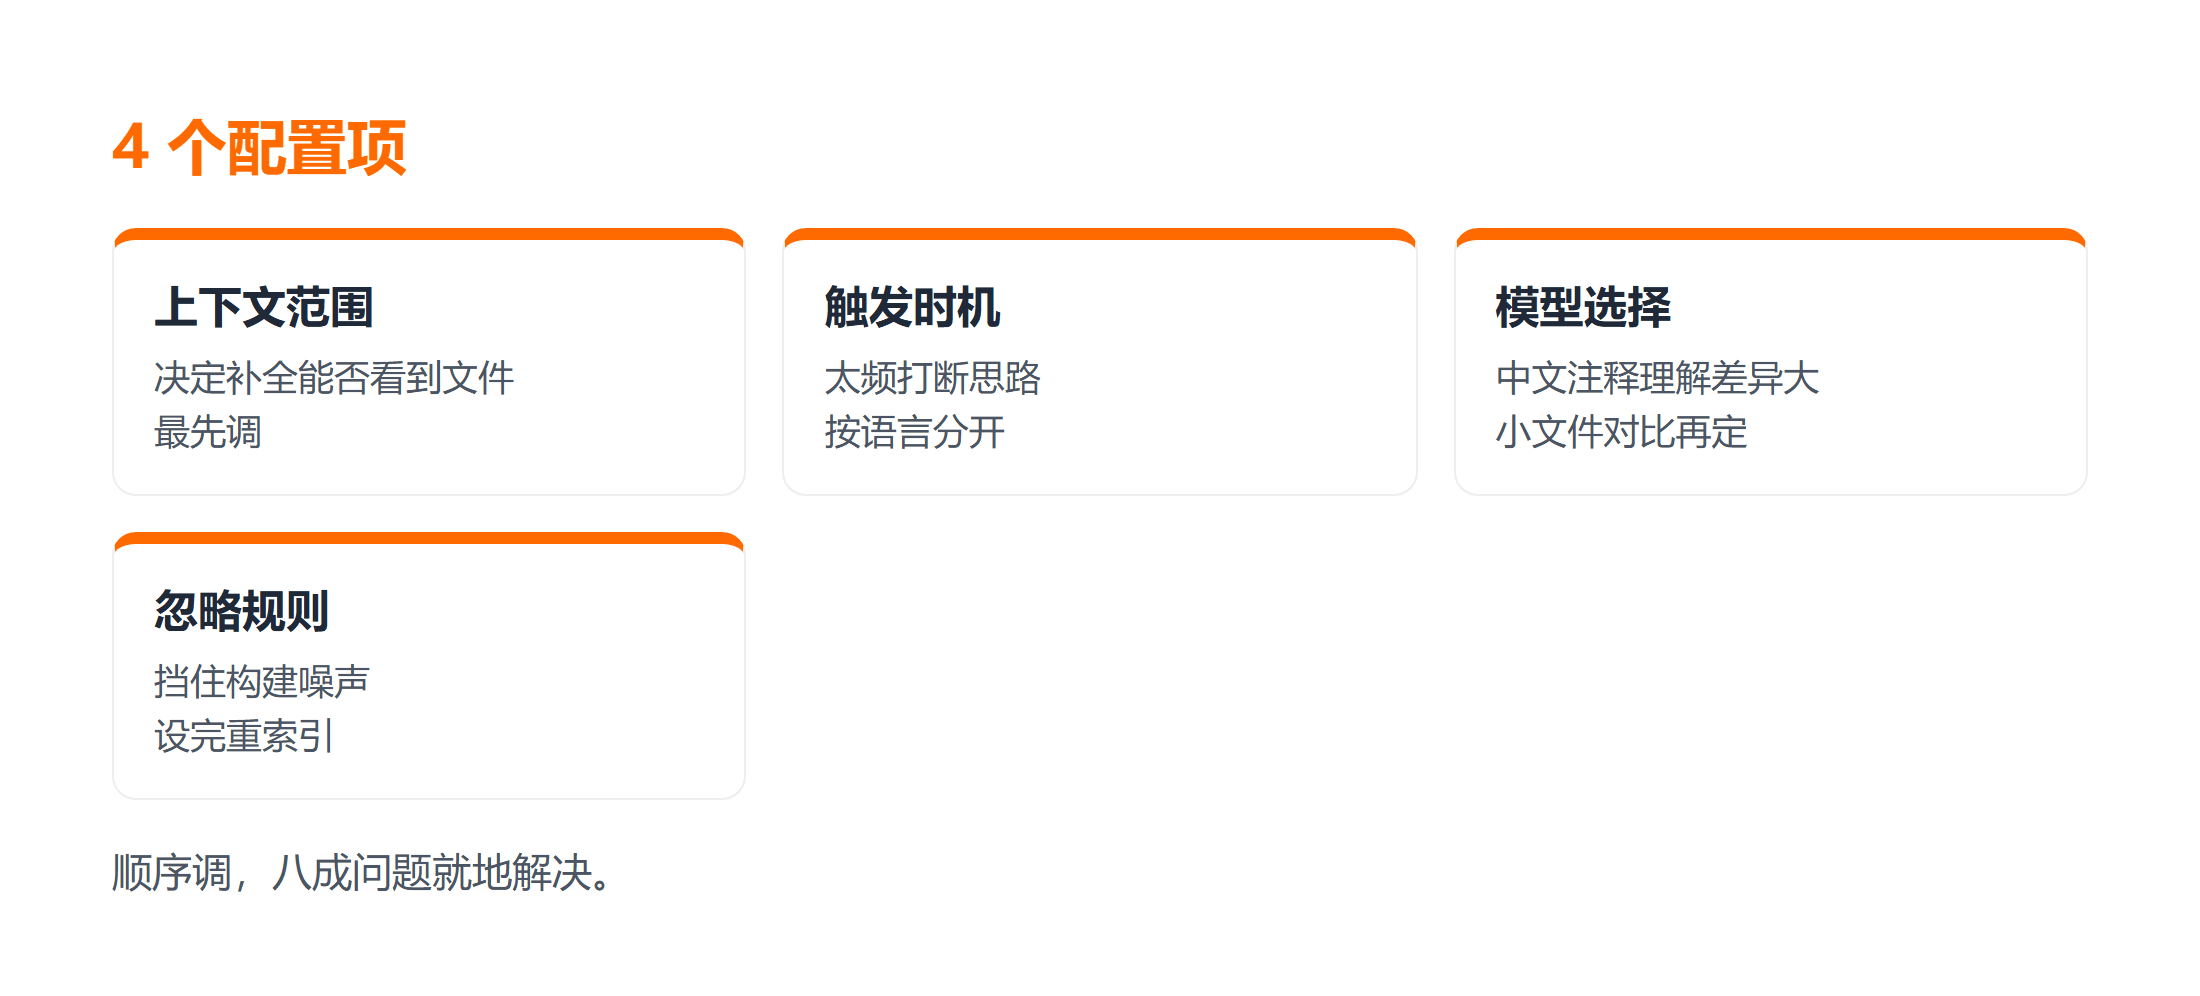
- 上下文范围:决定补全能不能看到关键文件,是最先要调的。
- 触发时机:太频繁会打断思路,太迟钝又跟不上,需按习惯设。
- 模型选择:不同模型对中文注释和项目类型的理解差异明显。
- 忽略规则:把无关生成物排除掉,补全才不会被噪声带偏。
一、先看上下文范围
上下文范围是补全准不准的第一杠杆。TRAE 默认只索引当前打开的工作区,如果你常用的定义在另一个没打开的文件里,补全会「看不见」从而瞎猜。解决方法是把关键目录显式纳入上下文,或者至少把被频繁引用的文件保持打开。
一个快速自检:让 TRAE 补全一个只定义在别处的函数名,看它能不能给出正确签名。如果不行,八成是上下文没覆盖。可以在设置里把相关目录加进索引:
{
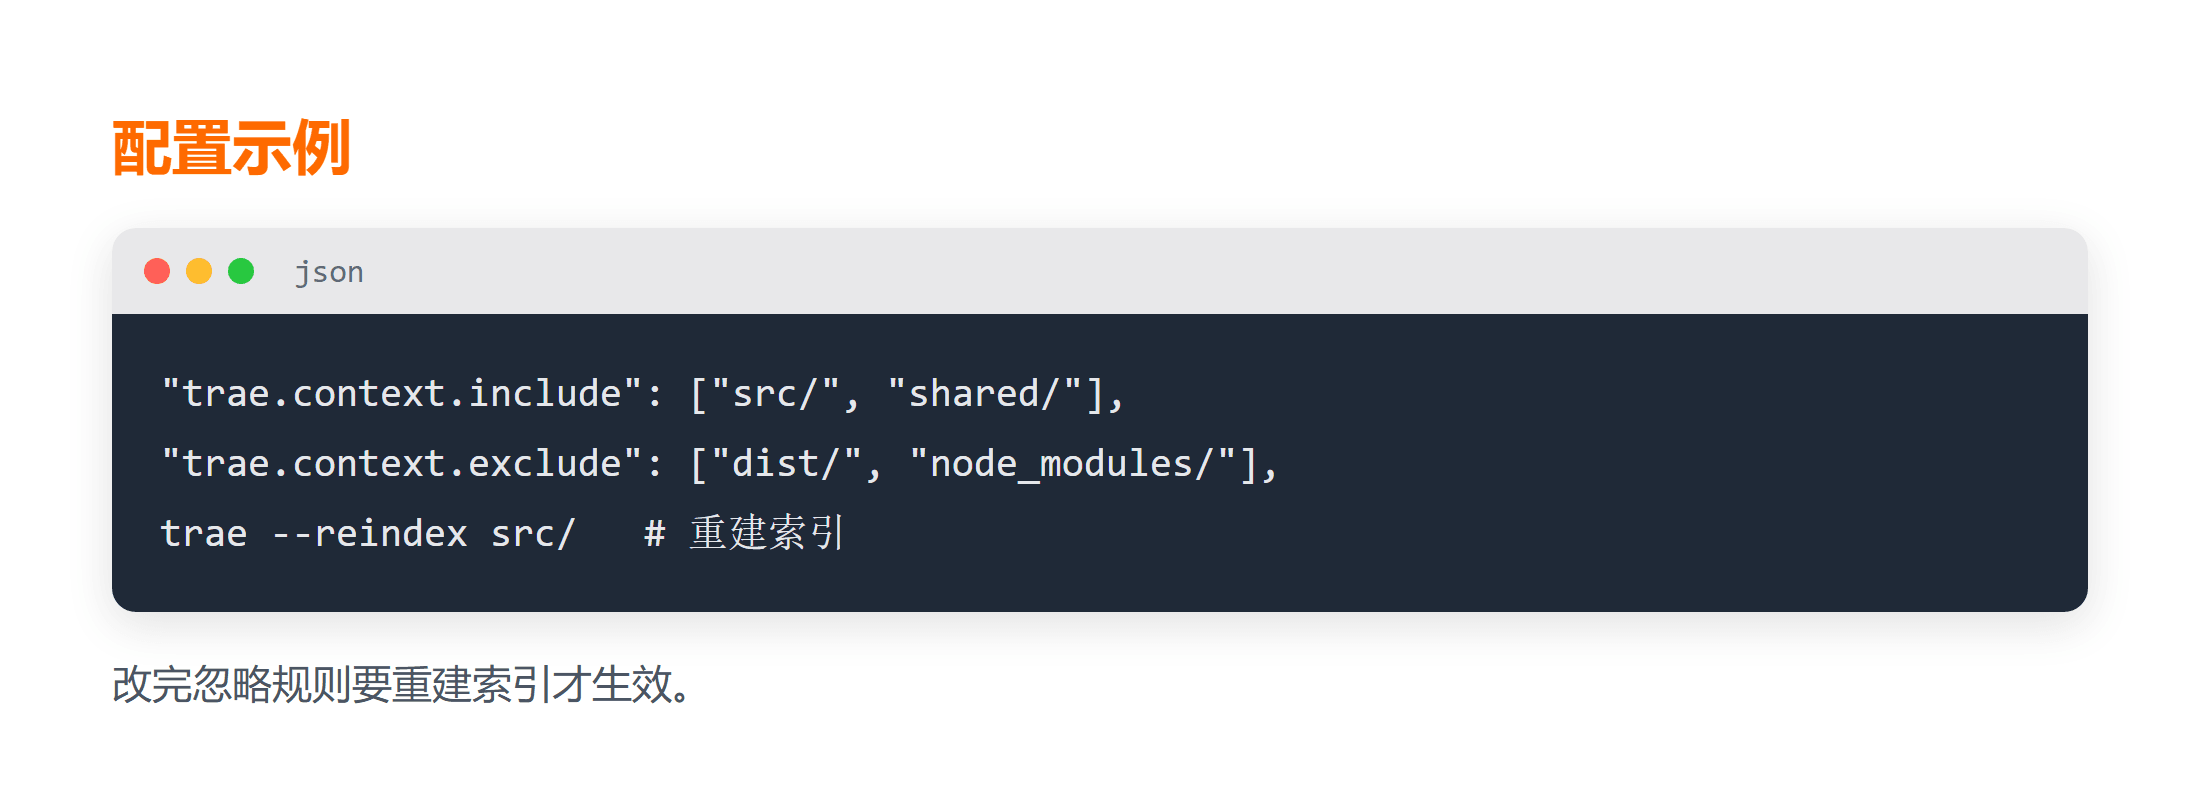
  "trae.context.include": ["src/", "shared/"],
  "trae.context.exclude": ["dist/", "node_modules/"]
}
上面这段把 src 和 shared 纳入、把构建产物排除,让补全聚焦源码。改完记得重新建立索引再试。对 TRAE 的整体能力想补基础,可以先过一遍 TRAE 编程中文教程,把配置入口摸熟。
配置好上下文范围后,建议先安装对应语言的索引插件,并运行一次全量索引命令,确认关键目录都已被纳入。运行结束后去检查状态面板,看有没有文件被意外排除;如果预期该出现的源码没进索引,多半是 exclude 规则写宽了,需要修复路径再重建。这一遍自检能提前消灭八成的「看不到关键文件」类不准。
二、再调触发时机
触发时机决定补全出现的节奏。默认是输入时实时建议,但在写注释或字符串时频繁弹窗会很烦,也容易被无关建议带偏。可以按语言把「行内补全」和「块级补全」分开:注释里关掉实时建议,代码区保留。
# 部分版本支持用命令行刷新补全索引
trae --reindex src/   # 重建索引后触发时机更跟手
这段命令在改了大批文件后特别有用:索引过期会导致补全基于旧代码,调了触发时机也没用。想看同类工具怎么组织上下文,可以翻 OpenClaw 中文教程,它的上下文管理思路有对照价值。
触发时机还和团队习惯强相关。如果你们习惯先写注释再补实现,就把注释区的实时建议关掉,避免补全在你说清楚意图前就跳出来打断;代码区保留块级补全,配合运行时报错反查更高效。改完配置不要急着下结论,先故意制造一个常见失败场景(比如引用一个未定义变量),看补全是否在正确位置给出修复建议,确认行为符合预期再固定下来。
三、然后选对模型
模型选择被很多人忽略,但它对中文注释和项目类型的影响很大。同一段业务代码,有的模型更懂你的中文命名习惯,有的更擅长类型推导。如果一个模型在「补全中文函数名」上总是跑偏,换一个对中文更友好的往往立竿见影,不必怀疑自己写法。
适用边界:模型不是越新越好,要和你的语言栈匹配。前端项目看重 JSX/TS 类型,后端看重接口契约,选型时先在小文件上对比两次补全质量再定。对模型调用原理想深入,可看 DeepSeek 中文教程,理解上下文怎么影响生成。
模型选型的落地方式很简单:在配置里把候选模型列成清单,逐个运行一段你最常吃亏的中文注释补全,对比两次结果再定。不要只看官方宣传的「中文强」,要拿自己的项目代码做验证,否则切换后才发现对某些命名习惯仍然跑偏,又得回头改配置。
四、最后设忽略规则
忽略规则是过滤噪声的最后一道闸。构建产物、日志、第三方 SDK 的 min 文件如果被算进上下文,补全会被这些噪声带偏,给出过时或错误的片段。把 dist、coverage、vendor 这类目录系统性排除,质量会稳很多。
# 忽略规则示例(按项目调整)
dist/**
*.min.js
coverage/**
*.log
这段规则把最常见的噪声源挡在上下文之外。设完建议重新索引再观察几天,确认补全不再引用被排除的文件。遇到具体配置问题,也可参考 TRAE 问题排查,按现象逐项核对。
忽略规则定好后,同样要运行一次重建并验证生效:新建一个本该被排除的临时文件,看补全是否还会引用它;如果仍被引用,说明规则没生效,需要检查语法或重建索引。把「验证忽略规则」也固化成提交前的检查项,长期能挡掉大量噪声导致的误补全。还有一个容易踩的坑:忽略规则用的是 glob 语义,写错一个星号就会把不该排除的文件也挡在外面,或者反过来完全没生效。遇到补全突然变聪明或变蠢,第一反应应是去检查忽略规则是否和当前目录结构匹配,而不是怀疑模型。
总结
TRAE 自动补全不准,按「上下文范围 → 触发时机 → 模型选择 → 忽略规则」四个配置项顺序调,八成问题能就地解决,不必急着换模型。核心心法是:先保证补全「看得到」关键文件、再让它「节奏合适」、然后「选对大脑」、最后「挡住噪声」。调完记得重建索引再验证,确认同样的输入能给出稳定准确的建议。
常见问题
Q:换了模型还是不准,问题出在哪?
多半在上下文。模型再强也看不到没纳入索引的文件。先确认关键目录已加入 context.include 并重建索引,再判断是不是模型本身的问题,避免盲目换模型浪费时间。
Q:补全太频繁打断思路怎么办?
把注释和字符串区里的实时建议关掉,只在代码区保留。触发时机按语言分开设置,比全局开关更贴合真实写法。
Q:忽略规则设了为什么还引用被排除的文件?
通常是索引没刷新。改完忽略规则要手动重建索引(如 trae --reindex),否则旧索引仍在生效,规则不会立刻起作用。
延伸学习
- TRAE AI 开发 Python Django 后台管理系统(配套课程,把 TRAE 用进真实项目)
- 让 AI 写注释怎么写提示词:用最小示例讲清用法与边界(笔记,补全与提示词写法可对照看)
- Python代码格式化(在线工具,贴代码前先规范格式更利于补全理解)



