
 TRAE-AI编程

用 DeepSeek 写单元测试想靠谱,核心是先把五件事钉死:断言必须能失败、边界条件要补齐、测行为不测实现、谨慎 Mock 外部依赖、测试挂进 CI 自动跑。它确实快,但生成的测试常常「看着齐全、实则没用」:断言永远为真、只测了快乐路径、边界条件一个没覆盖、Mock 乱飞导致测了个寂寞。这些坑不提前想清楚,上线后照样出 bug。本文先把结论讲透,再逐坑拆解:该让 AI 怎么写、写错了怎么修,以及哪些测试用例必须自己补。
先看结论
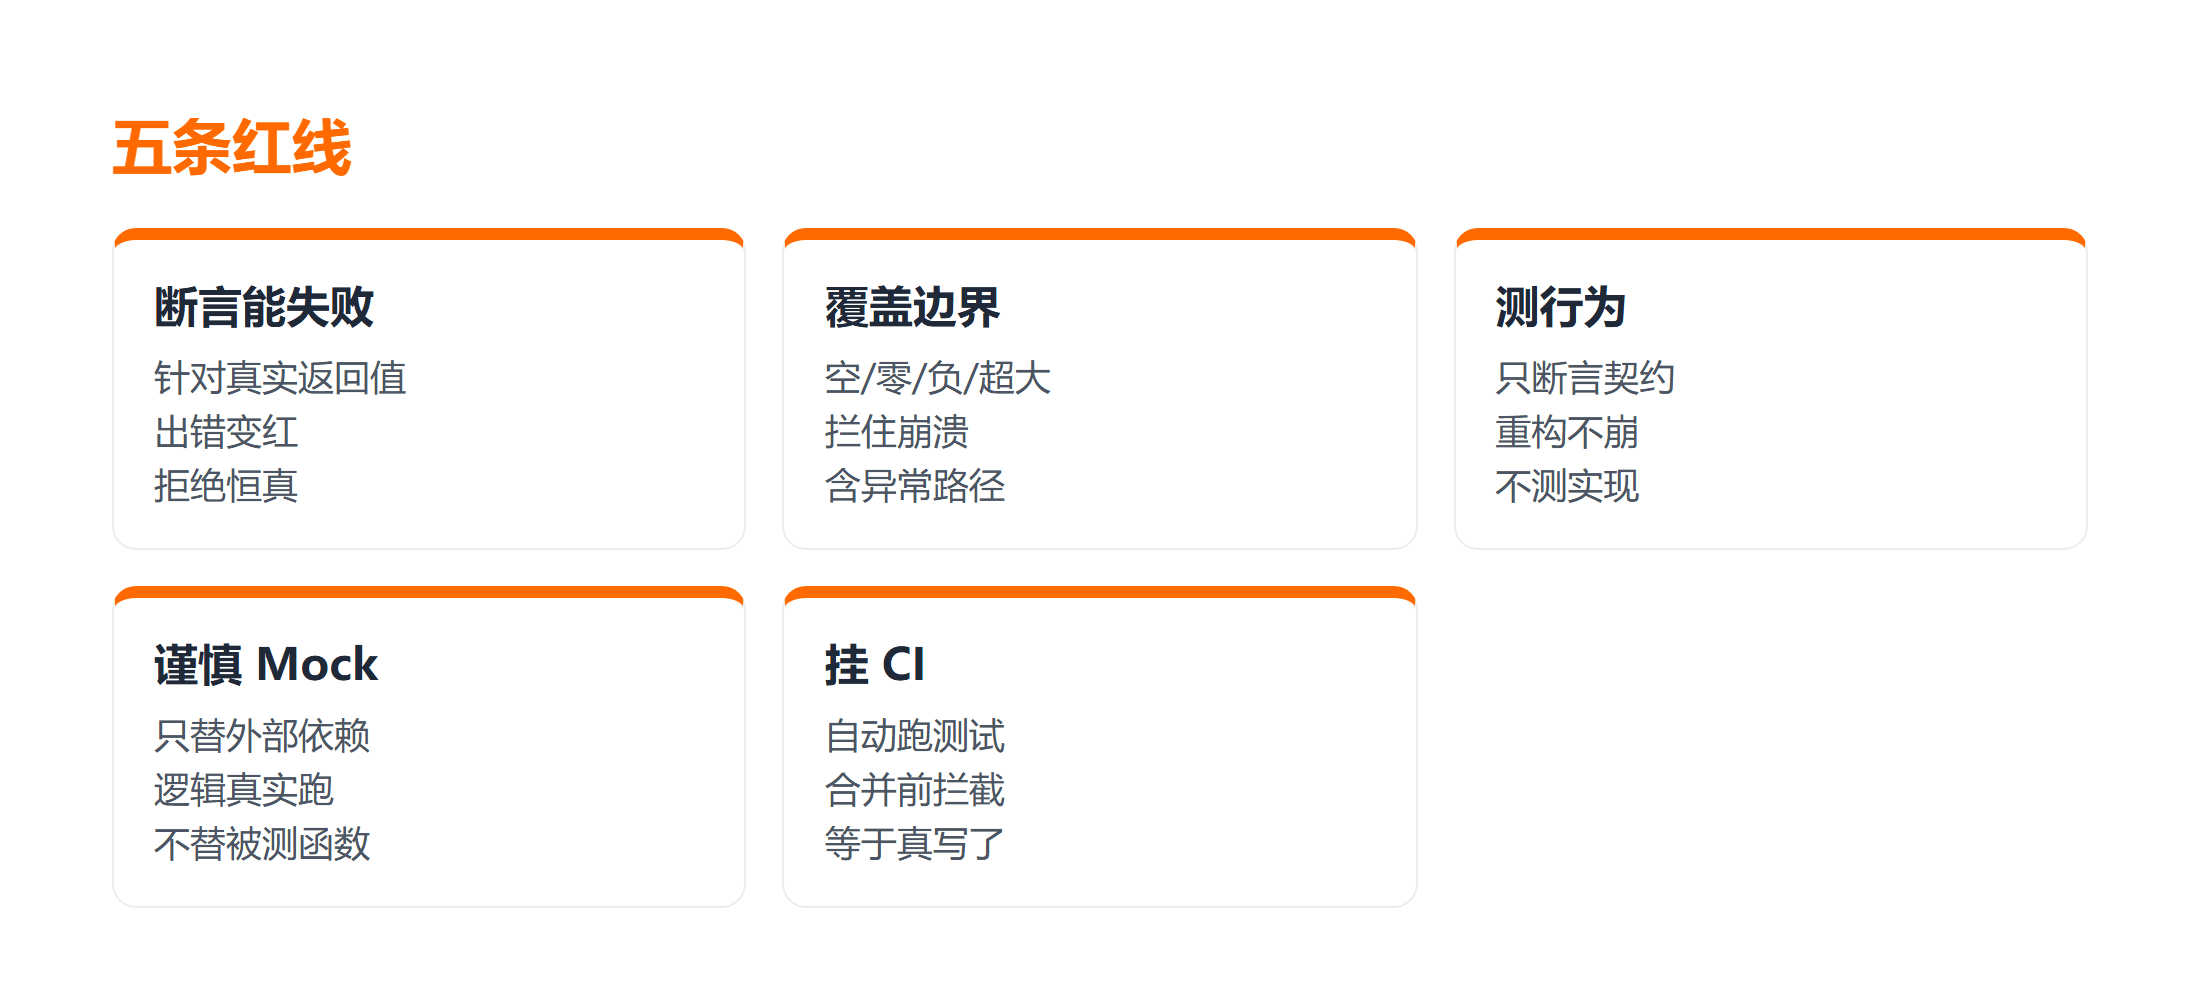
DeepSeek 写单元测试要靠谱,记住五个避坑点。第一,断言必须真能失败:拒绝「断言恒真」的假测试。第二,覆盖边界条件:空值、零、超大数、重复项一个都不能少。第三,测行为不测实现:别把内部变量当断言对象,重构就崩。第四,谨慎 Mock:只替掉外部依赖,别把被测函数也 Mock 了。第五,跑通 CI:测试不挂流水线等于没写。这五点想清楚,AI 产出的测试才是真护城河。
适用边界:本文以 Python + pytest 为例,思路同样适用于 JUnit、Go test 等。不涉及端到端测试与性能压测,聚焦函数级单元测试。系统学习可看 软件测试教程。
一、坑一:断言恒真,测试永远绿
最隐蔽的坑是 DeepSeek 写单元测试时给你一个永远通过的断言,比如先调用再 assert True:
# 危险写法:断言恒真,等于没测
def test_add():
    result = add(1, 2)
    assert True  # 永远通过,测了个寂寞
正确断言应当针对真实返回值:
# 正确写法:断言具体结果
def test_add():
    assert add(1, 2) == 3
    assert add(-1, 1) == 0
预期结果(未在本机执行):pytest 跑出 passed,且当 add 返回错误值时会立刻变红。失败处理:若测试全绿但你改坏函数却没报警,第一反应就是查断言是不是恒真。想系统了解断言写法,DeepSeek 中文教程 里有相关说明。
二、坑二:只测快乐路径,边界条件全空
快乐路径只能证明「正常时可用」,却证明不了「异常时不崩」。边界条件包括空值、零、负数、超大数、重复项,这些才是生产环境最容易炸的地方。AI 默认爱写「正常输入」的用例,对边界条件视而不见。真实 bug 往往藏在异常输入里:
import pytest

def test_divide_boundaries():
    # 快乐路径
    assert divide(10, 2) == 5
    # 边界:除零必须抛异常
    with pytest.raises(ZeroDivisionError):
        divide(10, 0)
    # 边界:负数与零分子
    assert divide(0, 5) == 0
assert divide(-10, 2) == -5关于边界与异常测试的完整清单,Python 速查手册 可当随手参考。性能取舍:多写几条边界用例成本极低,却能拦住大多数线上崩溃,性价比极高。
一个常见误判是认为「主流程过了就安全」。曾有团队让 AI 生成支付对账测试,只覆盖了正常入账,结果上线后遇到一笔「冲正后又入账」的边界交易,金额直接翻倍却没有任何测试报警。补上这条异常路径后,对账差异才被及时发现。可见边界用例不是锦上添花,而是主流程测试的必需补充,漏掉它等于把最易炸的生产场景留给了用户。
三、坑三:Mock 乱飞,测了个寂寞
Mock 用错比不用更糟。常见错误是把被测函数自己也 Mock 了,或者 Mock 了不该替的内部逻辑:
# 错误:Mock 了被测对象本身,等于没测
def test_fetch(mocker):
    mocker.patch("myapp.fetch_user", return_value={"id": 1})
    assert fetch_user(1) == {"id": 1}  # 永远成立,毫无意义
正确做法是只 Mock 外部依赖(如数据库、网络),让真实逻辑跑起来:
# 正确:只替掉外部 DB,业务逻辑真实执行
def test_fetch(mocker):
    mocker.patch("myapp.db.get", return_value={"id": 1, "name": "tom"})
    assert fetch_user(1)["name"] == "tom"
先想清楚的五个问题
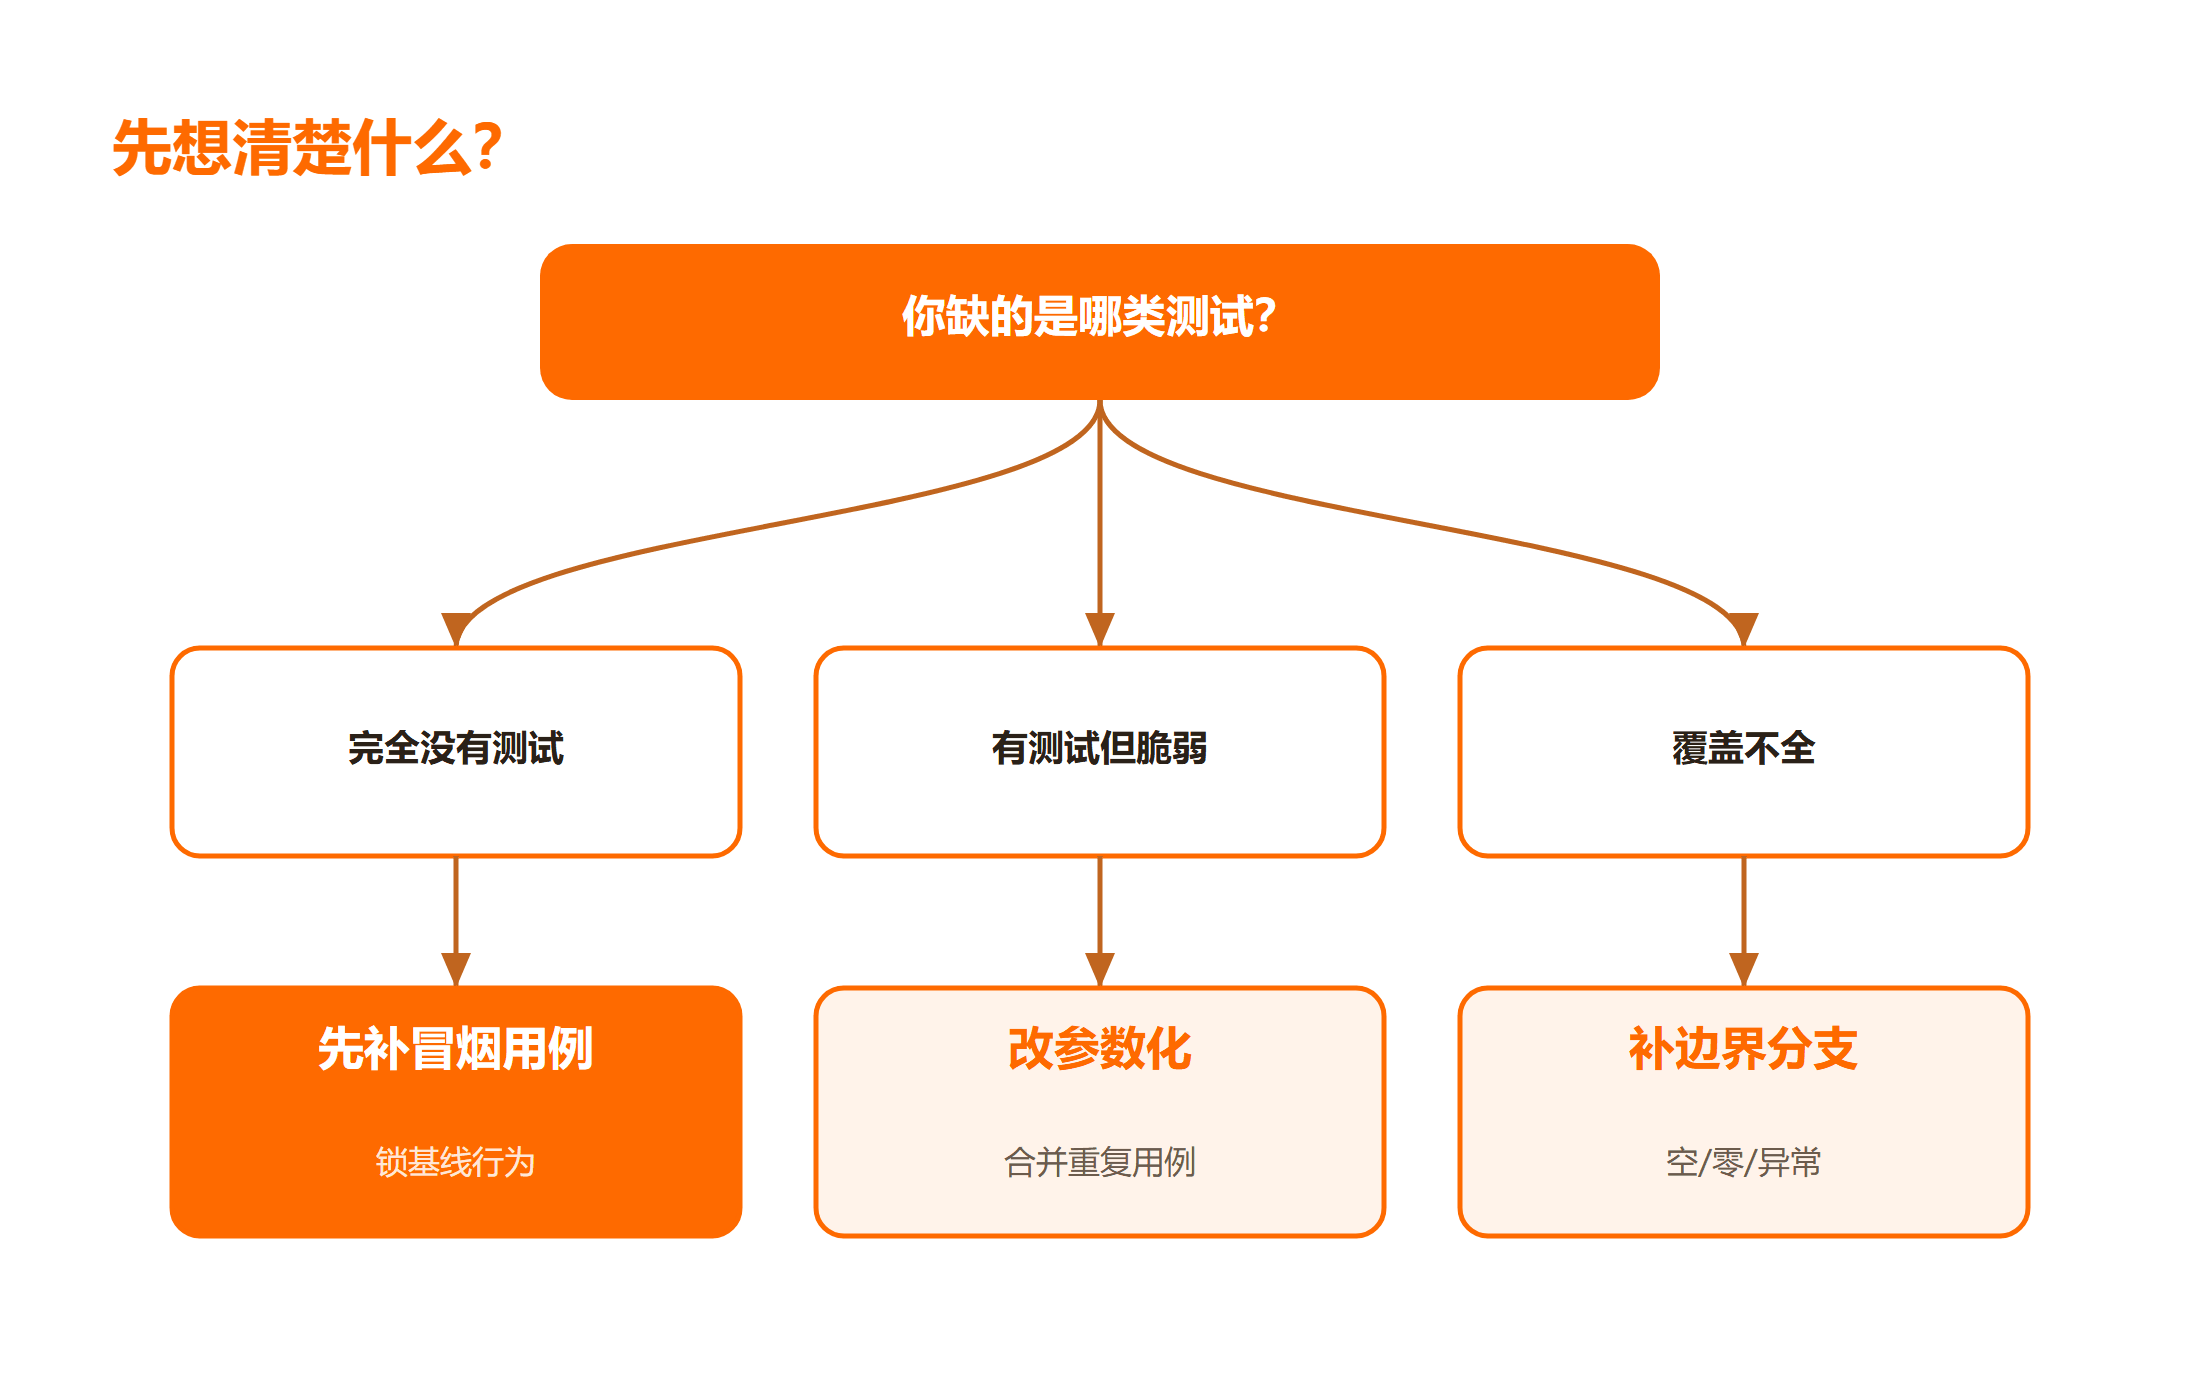
真正用好 DeepSeek 写单元测试,关键是提问前先自问五句。第一,我的断言能不能在出错时变红?第二,边界条件(空、零、负、超大、重复)覆盖了吗?第三,我测的是行为还是内部实现?第四,Mock 是不是只替了外部依赖?第五,这套测试会挂进 CI 自动跑吗?把五个问题写进提示词,AI 给的测试用例从第一版就接近可用。
还有个容易忽略的点:AI 爱复制粘贴相似测试,导致用例冗余又难维护。拿到生成结果后,把重复的用例合并成参数化测试(pytest 的 @pytest.mark.parametrize),既精简又覆盖更全。把这套顺序记牢,基本能避开绝大多数「测试齐全却拦不住 bug」的尴尬。
想验证 DeepSeek 给你的测试是否真有用,最朴素的做法是本地运行一遍:pytest tests/ -q。先检查输出确认全部 passed,预期拿到全绿;接着故意改坏一处函数实现再跑一次,它应当立刻变红——验证失败能被报警,才算测试真正生效。如果改坏了还绿,说明断言或配置有问题,需要回退重写这一组用例,而不是带着假绿灯上线。
一个细节:别把实现细节当断言
如果你断言「函数内部调用了某私有方法」,一旦重构改名,测试就崩,可行为其实没变。断言应当针对「输入输出契约」,而不是「怎么实现的」。让 DeepSeek 写单元测试时明确要求「只断言公开返回值与副作用」,能避免这类脆弱测试。
常见问题
Q:AI 生成的测试全绿,但线上还是出 bug,为什么?
多半是边界条件和异常分支没覆盖,或者断言恒真。回看测试是否包含空值、零、超大数据、异常路径,并确认每个断言都针对真实返回值而非 assert True。
Q:Mock 到底该替掉什么?
只替掉你控制不了、又慢又易变的外部依赖:数据库、网络请求、第三方 API、时间函数。被测函数自身的逻辑必须真实执行,否则你测的只是 Mock 的返回值。
Q:测试用例太多会不会拖慢 CI?
会,但值得。用参数化合并重复用例、给慢测试打标记单独跑、必要时并行执行,能在覆盖率和速度间取平衡。比起漏测导致的线上事故,这点耗时微不足道。
总结
用 DeepSeek 写单元测试想不踩坑,本质是先把五件事想清楚:断言必须能失败、边界条件要补齐、测行为不测实现、谨慎 Mock 外部依赖、测试挂进 CI 自动跑。记住五个坑——断言恒真、只测快乐路径、Mock 乱飞、测实现不测行为、不挂流水线,基本就能让 AI 产出的测试成为真正的护城河,而不是 green 的假象。
读者任务链(前置 / 操作 / 验证 / 失败处理)
- 前置:确认项目已装好测试框架(如 pytest)并能本地运行;若完全没有测试,先补覆盖核心路径的冒烟用例作为基线。
- 操作:让 DeepSeek 写单元测试时,明确要求「断言针对真实返回值、覆盖空/零/负/异常边界、只 Mock 外部依赖」,并拒绝任何
assert True式的恒真断言。 - 验证:把生成的用例跑一遍,确认全部通过;再故意改坏一处实现,确认至少有一条测试变红,证明断言真的能拦错。
- 失败处理:若测试全绿却拦不住 bug,优先查断言是否恒真、边界是否缺失、是否 Mock 了被测函数本身;逐项修正后重新运行。



