 免费 AI IDE

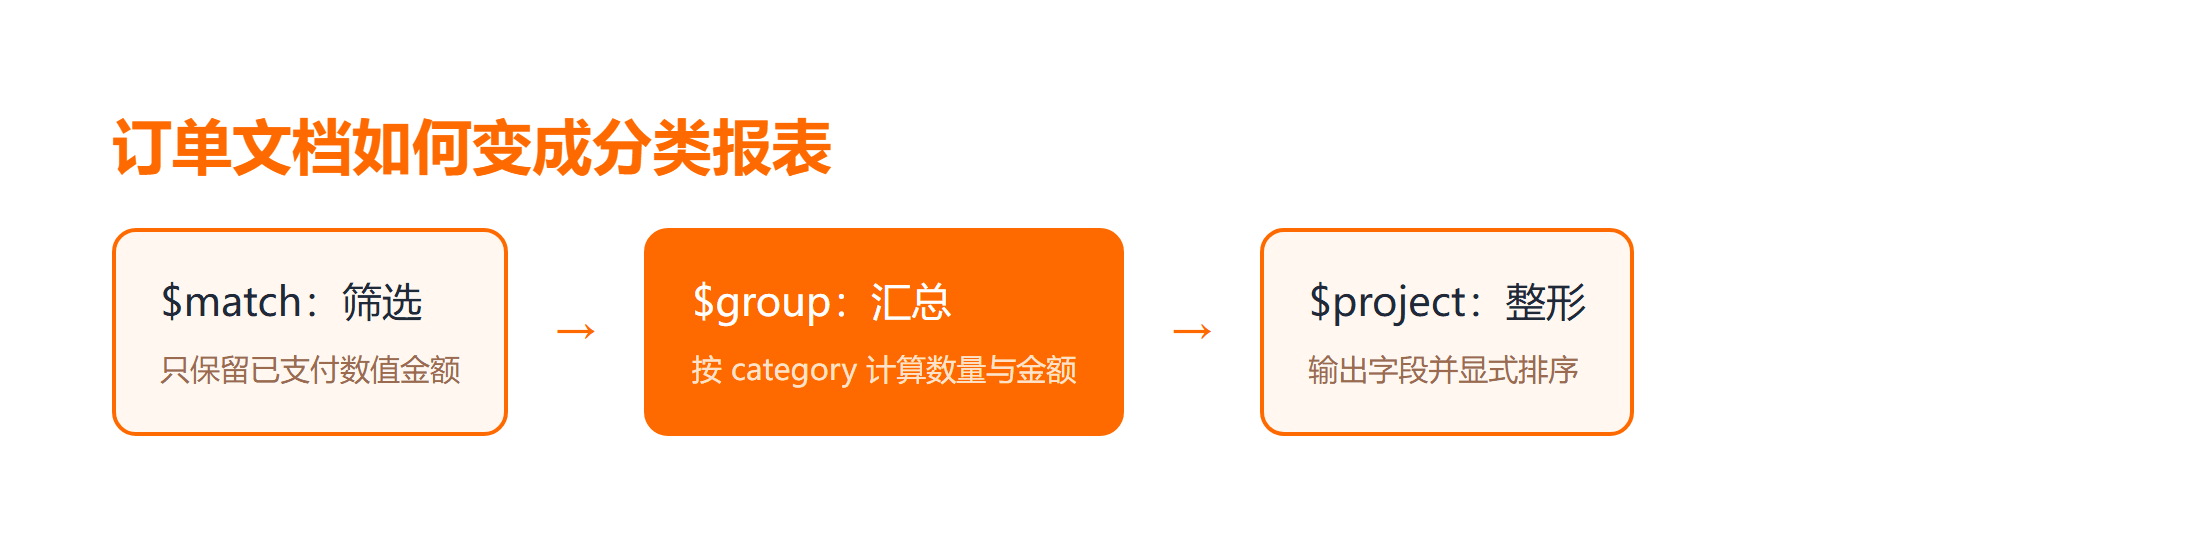
MongoDB 聚合查询可以先用 $match 缩小数据,再用 $group 分组计算,最后用 $project 整理字段;顺序清楚后,复杂报表就变成逐阶段转换。
你会写 find,却在统计“已支付订单按分类汇总销售额”时卡住:条件、分组键、求和和字段改名全挤在一起,任何一个字段写错都只得到空结果。聚合管道更像流水线,每一阶段接收上一阶段的文档再交给下一阶段。本文用 6 条订单数据完成一份可复制的报表,并解释索引、字段类型和内存边界。本机没有 mongosh,示例依据 MongoDB 官方文档,结果标为预期结果(未在本机执行)。
一、先看结论:三阶段管道各做什么
| 阶段 | 作用 | 类似 SQL | 关键注意点 |
|---|---|---|---|
$match |
筛选文档 | WHERE |
放前面,可利用索引 |
$group |
分组计算 | GROUP BY |
阻塞阶段,关注内存 |
$project |
整理字段 | SELECT |
可改名、计算、排除 _id |
$sort |
排序 | ORDER BY |
$group 不保证顺序,需显式排序 |
一句话:先筛选、再分组、最后整形;每增加一个阶段就检查一次输入输出。
二、准备一组能暴露边界的订单数据
先创建 orders 集合。数据故意包含已支付、待支付和字符串金额三种情况,方便观察类型错误。
// 删除旧集合,确保测试数据干净
db.orders.drop();

// 插入 6 条订单数据
db.orders.insertMany([
  { orderId: 1, category: "book", status: "paid", amount: 39 },
  { orderId: 2, category: "book", status: "paid", amount: 59 },
  { orderId: 3, category: "course", status: "paid", amount: 199 },
  { orderId: 4, category: "course", status: "pending", amount: 99 },
  { orderId: 5, category: "tool", status: "paid", amount: 20 },
  { orderId: 6, category: "tool", status: "paid", amount: "30" } // 字符串金额,失败样例
]);
MongoDB 聚合查询由多个阶段组成,数组中的每个对象就是一个阶段。刚接触文档数据库时,可以先过一遍 MongoDB 基础教程,把集合、文档和字段路径理解清楚。
⚠️ 注意:
amount同时出现数字和字符串不是推荐设计,而是一个失败样例。聚合运算依赖字段类型,业务入口应尽量保证数据结构一致。
| 订单 | 分类 | 状态 | 金额 | 是否参与聚合 |
|---|---|---|---|---|
| 1 | book | paid | 39 | 是 |
| 2 | book | paid | 59 | 是 |
| 3 | course | paid | 199 | 是 |
| 4 | course | pending | 99 | 否,状态不符 |
| 5 | tool | paid | 20 | 是 |
| 6 | tool | paid | "30" | 否,类型不符 |
三、先用 $match 把无关文档挡在前面
$match 的作用类似 SQL 的 WHERE。把它放在管道前部,可以减少后续阶段处理的数据量;当条件适合并且 $match 位于前部时,还可能使用索引。
db.orders.aggregate([
  {
    $match: {
      status: "paid",                  // 只保留已支付订单
      amount: { $type: "number" }      // 只保留金额为数字的订单
    }
  }
]);
预期结果(未在本机执行)包含订单 1、2、3、5,待支付订单 4 和字符串金额订单 6 被排除。
| 错误写法 | 后果 | 正确写法 |
|---|---|---|
status: paid |
paid 被当变量,报引用错误 |
status: "paid" |
state: "paid" |
字段名不存在,得到空结果 | status: "paid" |
不写 $type |
字符串金额可能参与运算 | amount: { $type: "number" } |
对于正式数据,应在 status 上建立索引并用 explain 检查:
// 在 status 字段上建立升序索引
db.orders.createIndex({ status: 1 });

// 用 explain 查看聚合执行计划
db.orders.explain("executionStats").aggregate([
  { $match: { status: "paid" } },
  { $group: { _id: "$category", total: { $sum: "$amount" } } }
]);
检查 winningPlan 中是否出现 IXSCAN,并比较 totalDocsExamined 与 nReturned。数据量很小时使用集合扫描不一定有问题,索引价值要结合选择性和查询频率判断。
| explain 字段 | 含义 | 关注点 |
|---|---|---|
winningPlan |
最终执行计划 | 是否出现 IXSCAN |
totalDocsExamined |
扫描文档数 | 越少越好 |
nReturned |
返回文档数 | 与扫描数差距 |
executionTimeMillis |
执行时间 | 结合数据量判断 |
四、用 $group 同时计算订单数和总金额
$group 通过 _id 指定分组键。每个分类输出一条文档,再用累加器计算 count 与 totalAmount。
db.orders.aggregate([
  // 第一阶段:筛选已支付且金额为数字的订单
  { $match: { status: "paid", amount: { $type: "number" } } },

  // 第二阶段:按分类分组,计算订单数和总金额
  {
    $group: {
      _id: "$category",              // 分组键:分类
      orderCount: { $sum: 1 },       // 每一条文档计 1
      totalAmount: { $sum: "$amount" } // 累加金额
    }
  },

  // 第三阶段:按总金额降序排序
  { $sort: { totalAmount: -1 } }
]);
预期结果(未在本机执行):
| 分类 | 订单数 | 总金额 |
|---|---|---|
| course | 1 | 199 |
| book | 2 | 98 |
| tool | 1 | 20 |
$group 不保证输出顺序,所以报表需要显式 $sort。
$group 是阻塞阶段,需要拿到分组所需数据后再继续输出。官方文档提醒,大数据集的分组可能消耗较多内存;复杂报表要关注 allowDiskUse、索引和进入 $group 前的文档数量。
| 累加器 | 作用 | 示例 |
|---|---|---|
$sum: 1 |
计数 | orderCount |
$sum: "$amount" |
求和 | totalAmount |
$avg: "$amount" |
平均值 | 平均金额 |
$first / $last |
取第一个/最后一个 | 保留代表值 |
$push |
收集为数组 | 保留明细列表 |
五、用 $project 把内部字段整理成报表字段
$project 类似 SQL SELECT,但不仅选择字段,也能改名、计算和排除 _id。把它放在分组之后,可以让 API 输出更清楚。
db.orders.aggregate([
  // 筛选已支付且金额为数字的订单
  { $match: { status: "paid", amount: { $type: "number" } } },

  // 按分类分组,计算订单数和总金额
  {
    $group: {
      _id: "$category",
      orderCount: { $sum: 1 },
      totalAmount: { $sum: "$amount" }
    }
  },

  // 整理输出字段:排除 _id,改名,计算平均金额
  {
    $project: {
      _id: 0,                                      // 不输出默认 _id
      category: "$_id",                            // 把 _id 改名为 category
      orderCount: 1,                               // 保留订单数
      totalAmount: 1,                              // 保留总金额
      averageAmount: {                             // 计算平均金额
        $round: [{ $divide: ["$totalAmount", "$orderCount"] }, 2]
      }
    }
  },

  // 按总金额降序排序
  { $sort: { totalAmount: -1 } }
]);
预期输出(未在本机执行)中不再出现 _id,并新增 averageAmount。
| 字段 | 来源 | 说明 |
|---|---|---|
category |
$_id |
改名后输出 |
orderCount |
$group |
保留 |
totalAmount |
$group |
保留 |
averageAmount |
$divide + $round |
计算字段 |
_id |
排除 | _id: 0 |
若在 $group 后还想读取原订单的 status 或 orderId,必须在分组阶段通过累加器保留;$group 没输出的字段已经离开管道,后续 $project 无法找回。
熟悉 SQL 的读者可以结合 SQL 基础教程 对照:$match 对应 WHERE,$group 对应 GROUP BY,$project 对应 SELECT。映射只帮助理解,不能把关系数据库的表连接和事务假设原样套到 MongoDB。
六、MongoDB 聚合查询的失败排查顺序
管道没有结果或金额不对时,不要一次改完整数组。按阶段逐个增加最可靠:
| 步骤 | 操作 | 检查内容 |
|---|---|---|
| 1 | 只运行 $match |
筛选数量和字段类型 |
| 2 | 加入 $group |
暂时只保留 _id 与一个 $sum |
| 3 | 加入 $project |
字段改名和 _id 排除 |
| 4 | 增加 $sort、$limit 与复杂表达式 |
排序和分页 |
| 5 | 用 explain 观察 |
索引、扫描文档数与执行时间 |
字符串金额应在写入入口修正。历史数据确实混杂时,可以用 $convert 并提供 onError / onNull,但转换规则要和业务确认,不能把非法金额静默当成 0。
// 用 $convert 清洗字符串金额,转换失败时设为 null
db.orders.aggregate([
  {
    $project: {
      amountNumber: {
        $convert: {
          input: "$amount",
          to: "double",
          onError: null,   // 转换失败设为 null
          onNull: null     // 空值设为 null
        }
      }
    }
  }
]);
用阶段快照验证报表
前置条件是先保存一组固定测试数据,其中至少包含已支付、未支付、缺少金额和金额类型错误四类文档。执行每个阶段后都记录文档数量与一个代表性输出:
| 阶段 | 预期输出 | 验证目标 |
|---|---|---|
| 输入夹具 | 6 条订单 | 包含四类边界 |
$match 后 |
4 条已支付数字订单 | 状态和类型筛选正确 |
$group 后 |
每个分类一条结果 | 分组和求和正确 |
$project 后 |
字段名、平均值、_id 符合契约 |
输出结构正确 |
$sort 后 |
按总金额降序 | 顺序稳定 |
explain 后 |
计划含 IXSCAN |
索引生效 |
如果聚合在测试库正确、线上却很慢,先用 explain 检查 $match 是否使用索引以及进入 $group 的文档数;若出现内存限制,再评估是否能提前筛选、分批统计或允许磁盘使用。本文管道依据 MongoDB 阶段语义完成静态核对,但当前环境没有 mongosh,因此未伪造执行输出。实际交付应保留输入夹具、阶段快照、最终报表和 explain 结果,四项一致才算验证完成。
报表还应固定时间范围和时区,并与一组人工计算的小样本交叉核对;否则管道语法正确,也可能因为日期边界不同而得到错误业务结论。
总结
MongoDB 聚合查询最稳的写法是先筛选、再分组、最后整形。每增加一个阶段就检查一次输入输出,能把“整个报表不对”缩小成“某一阶段的数据不对”。
性能方面,把高选择性的 $match 放前面并检查索引;正确性方面,统一金额类型、显式排序,并记住 $group 会丢弃没有输出的字段。完成这些检查后,三阶段管道足以覆盖大量基础统计报表。
延伸学习
- 通过 MongoDB入门与案例分析 完成从查询到聚合的系统练习;
- 再读 MongoDB 聚合管道笔记,扩展更多阶段和性能思路;
- 用 NoSQL 与 MongoDB 关系笔记 补齐数据模型选择背景。
常见问题
Q:$project 一定要放在最后吗?
A:不一定。它可以在中间计算字段或减少字段,但优化器也可能调整部分阶段。初学时放在分组后整理输出,更容易观察数据变化。
Q:$group 为什么不能直接输出原文档字段?
A:分组后多条文档合成一条,原字段可能有多个值。必须用 $first、$max、$push 等累加器明确说明保留规则。
Q:$match 放在 $project 后面会怎样?
A:结果可能仍正确,但若筛选不依赖新计算字段,放前面通常能减少输入并使用索引。可用 explain 判断实际计划。
Q:金额字段是字符串时能直接 $sum 吗?
A:不应依赖隐式行为。最好在写入时保存为数值;清洗历史数据时用 $convert 明确失败和空值处理,再进行求和。