 TRAE-AI编程

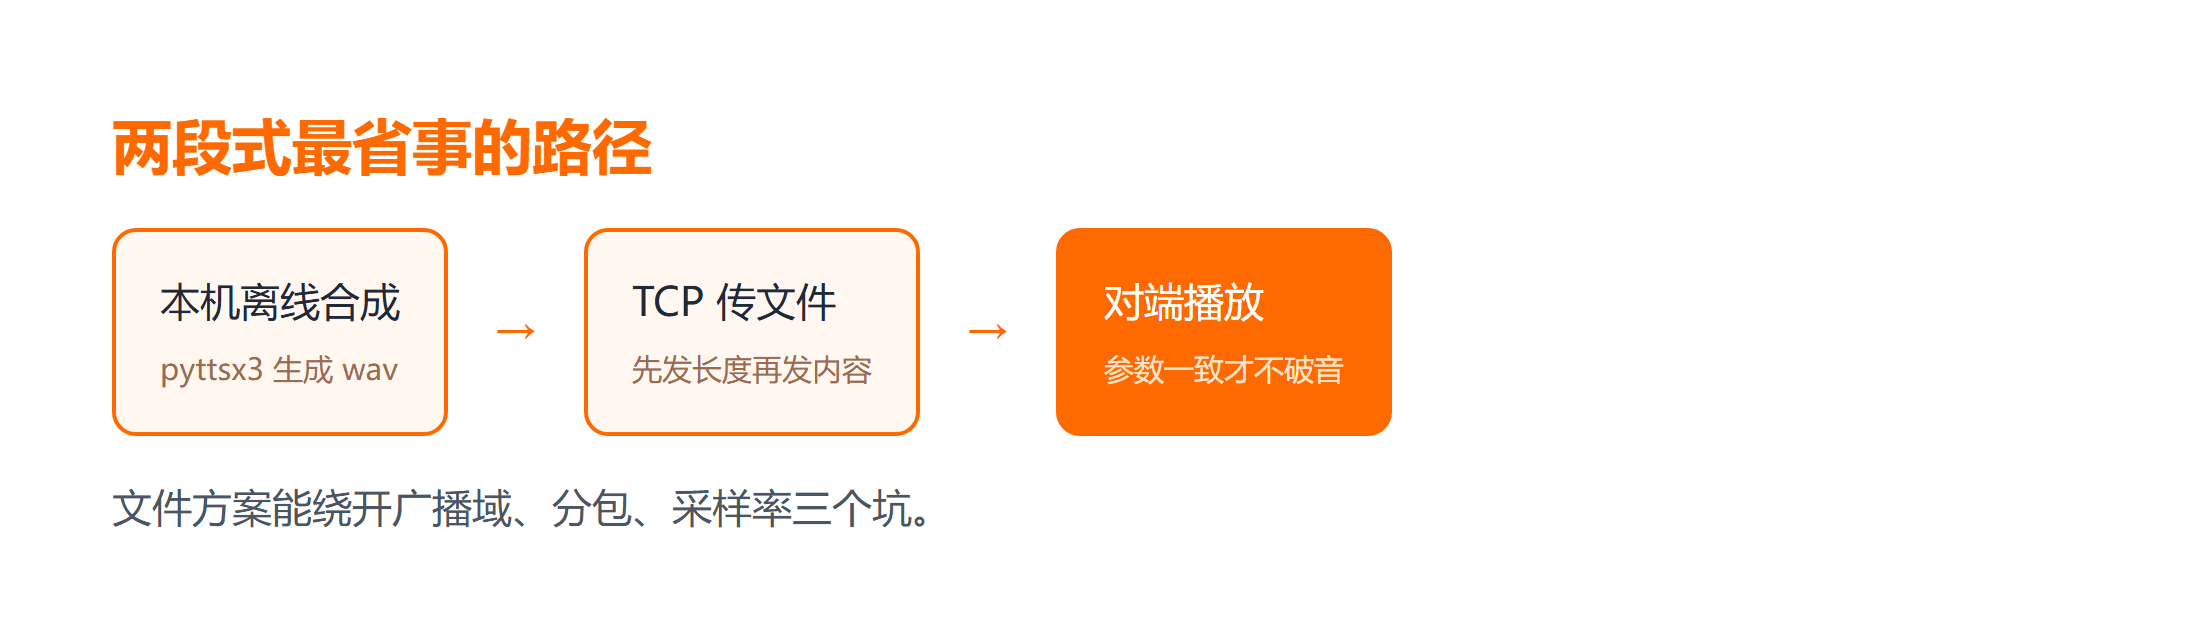
Python 在局域网里发语音,最稳的做法是两段式:先在本机把文字合成成音频文件,再用 socket 把文件传过去,对端收到后播放。不要一上来就做实时流,因为局域网里真正容易卡住你的三个坑——广播域不通、单包超过 MTU 被丢、两端采样率不一致——在文件方案里都能绕开。
很多初学者搜「Python 局域网发语音」,期望找到一段代码能直接对着麦克风喊话。实际落地的场景更朴素:一台机器定时播报提醒,另一台机器负责合成并推送。这类需求用文件传输完全够用,实时流反而带来一堆调试成本。
本文给出可运行的两段式实现,标注了每个步骤的预期结果,并单独列出三个坑的现象、原因与修复方式。今天这篇文章,编程狮就把这条链路讲透。
先看结论
局域网内传语音,建议按「合成 → 传文件 → 播放」三步走,而不是做实时音频流。三个坑分别是:广播地址写错或跨网段导致对端根本收不到;音频数据不分包,单个 UDP 包超过 MTU 被丢弃;两端采样率或声道数不一致,播出来是噪音。
判断顺序是先用 TCP 小文件验证连通性,再加大数据量,最后才考虑实时性。这个顺序能让你在每一步都知道问题出在哪。
网络这一层若不熟,可以先翻 Socket 教程 把 TCP 与 UDP 的差别过一遍,再回来看代码会轻松很多。
一、先确定「发语音」指的是哪一种
说法一样,实现差别很大。
1.1 三种常见需求
| 需求 | 推荐做法 | 实时性 | 复杂度 |
|---|---|---|---|
| 定时播报提醒 | 本机合成后传文件 | 秒级延迟可接受 | 低 |
| 对讲式喊话 | UDP 传 PCM 流 | 百毫秒级 | 中 |
| 多人会议 | 走现成媒体服务 | 高 | 高 |
局域网场景下,第一种占了绝大多数。它的好处是文件可重放、可本地核对,出问题能直接听那段音频判断是合成问题还是传输问题。
1.2 环境准备
合成语音用 pyttsx3,它是离线的,不依赖外网。安装命令如下,适用于 Windows、macOS、Linux 三端。
pip install pyttsx3上面这条命令做的是安装离线语音合成库。预期结果(未执行,依据官方文档的安装说明)是终端出现成功安装提示;Windows 上若报缺少语音引擎,需要先确认系统已安装 SAPI5 语音包。不同版本的行为有差异,安装前先看一眼库的版本要求,装错版本在初始化阶段就会报错。
💡 小提示:离线合成的好处是断网也能用,代价是音色选择少。对音色有要求时再考虑在线合成方案,但那样就要额外处理网络失败的情况。
二、最稳的做法:合成文件再传过去
先在本机把文字变成 wav 文件,这一步能独立验证,不牵扯网络。
2.1 合成一段音频
import pyttsx3

engine = pyttsx3.init()
engine.setProperty('rate', 160)
engine.setProperty('volume', 0.9)
engine.save_to_file('编程狮提醒你,该喝水了', 'notice.wav')
engine.runAndWait()
上面这段代码做的是初始化一个离线合成引擎,设置语速与音量,把一句中文存成 wav 文件。运行后会得到一个 notice.wav,先在本机播放确认有声音,再进入传输环节。
2.2 用 TCP 把文件发过去
import socket
import os

path = 'notice.wav'
size = os.path.getsize(path)
host, port = '192.168.1.20', 9000

with socket.create_connection((host, port), timeout=10) as s:
    s.sendall(str(size).encode() + b'\n')
    with open(path, 'rb') as f:
        s.sendall(f.read())
print('sent', size)
上面这段代码做的是:先建立 TCP 连接,把文件长度先发过去,再发送整个文件内容。先发长度是为了让接收端知道要收多少字节,这是文件传输里最基础也最容易漏的一步。
三、想实时一点:UDP 广播找人 + TCP 传流
如果你确实需要「一喊就响」,把发现环节和传输环节分开做。
3.1 用 UDP 广播发现对端
import socket

msg = b'who-is-online'
s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
s.setsockopt(socket.SOL_SOCKET, socket.SO_BROADCAST, 1)
s.sendto(msg, ('192.168.1.255', 9001))
s.settimeout(3)
try:
    data, addr = s.recvfrom(1024)
    print('found', addr, data)
except socket.timeout:
    print('no reply')
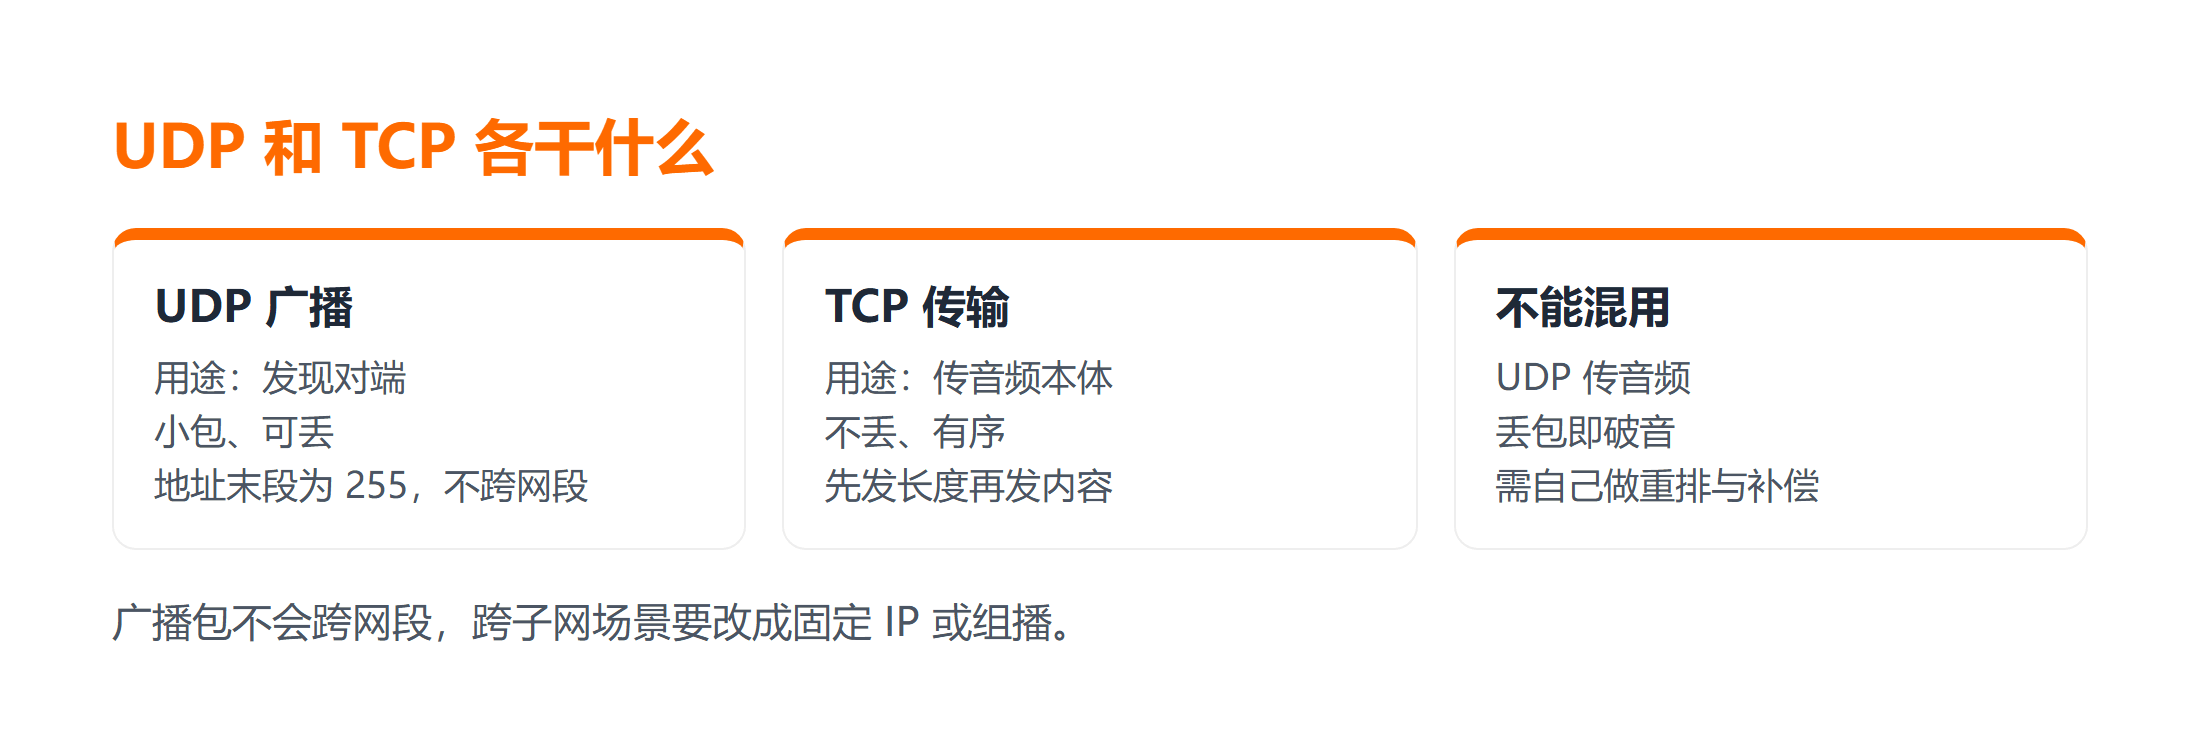
上面这段代码做的是向本网段的广播地址发一个探测包,等三秒看有没有人回。广播地址的最后一段是 255,写错成对端 IP 就退化成单播,这是最常见的失败原因。
3.2 真正的音频走 TCP
发现对端之后,音频数据仍然建议走 TCP。UDP 适合「找人」这种小包,不适合传音频流,因为丢包会造成破音,而你需要自己做重排。
⚠️ 注意:广播包不会跨网段。两台机器在不同子网(比如 192.168.1.x 与 192.168.2.x)时,广播发现必然失败,需要改成固定 IP 或走组播。
四、三个坑:现象、原因、修复
这三个坑覆盖了局域网语音项目里绝大多数「跑不起来」。
4.1 广播发了没人回
原因通常是广播地址写错、跨了网段,或者对端防火墙拦了入站。修复方式是先用固定 IP 直连验证,确认链路通了再改回广播。
4.2 数据一大就丢
UDP 单包超过 MTU(常见值 1500 字节)会被分片或丢弃。音频数据必须自己分包,每包控制在 1200 字节左右,接收端按序号重组。
4.3 播出来是噪音
多半是采样率或声道数不一致。合成端用的是 22050Hz 单声道,播放端按 44100Hz 立体声去解,听上去就是一片杂音。修复方式是在传输前把参数一起发过去,或者统一约定一套参数。这个坑的边界很清晰:只要两端参数一致,同一份音频数据的输出就一定一致,排查时先比参数再比数据。
总结
Python 在局域网里发语音,最省事的路径是离线合成加 TCP 传文件。实时性需求出现后再引入 UDP,但只让它承担广播发现,音频本体仍走 TCP。三个坑——广播域、分包、采样率——逐个确认,能省掉大量无谓调试。
要点带走:
- 先用小文件验证连通性,再谈实时性;
- UDP 只用来发现对端,音频数据交给 TCP;
- 采样率与声道数要一起传,参数对不上播出来就是噪音。
下一步建议在本机先跑通合成,再用两台同网段机器传一次文件,最后才加广播。Python 网络这块的细节可以顺着 TCP/IP 教程 往下补。
常见问题
Q:局域网发语音一定要用到麦克风吗?
A:不一定。定时播报、提醒类需求只需本机合成音频再传文件,不需要采集设备,复杂度低很多。
Q:UDP 广播为什么对端收不到?
A:先确认广播地址是否为本网段的 255 结尾地址,再确认两台机器是否同网段,最后检查对端防火墙是否拦了入站包。
Q:音频传过去播出来是噪音怎么办?
A:先核对采样率与声道数是否一致。参数不一致时,把参数随数据一起传过去,由播放端按实际参数解码。
Q:pyttsx3 在 Linux 上初始化失败怎么处理?
A:Linux 下依赖 espeak 后端,需要先安装系统级的语音引擎再装 Python 库,顺序反了会直接报初始化失败。
延伸学习
想把这块做扎实,可以按这个顺序来:
- 读一篇相关笔记 Python 语音对话实战,看语音这条线怎么往下走;
- 想动手练,Python 配套课程 把语法与标准库补齐;
- 基础不熟时,翻 Python3 教程 最快。