 TRAE-AI编程

RAG(Retrieval-Augmented Generation,即检索增强生成)让大模型的答案从"凭记忆猜"变成"看着你的资料答"。它先把你的问题拿去检索相关资料,再把检索内容连同问题一起喂给模型。你问"公司报销流程是什么",模型若没见过制度文档就会瞎编——这正是知识截止和没有私有数据的短板。RAG 专门补这个短板,让回答建立在有出处的事实上,而不是模型的临场发挥。想让 AI 真正"懂你家的资料",RAG 是当前最务实的入口。
先看结论
| 做法 | 优点 | 缺点 | 适合场景 |
|---|---|---|---|
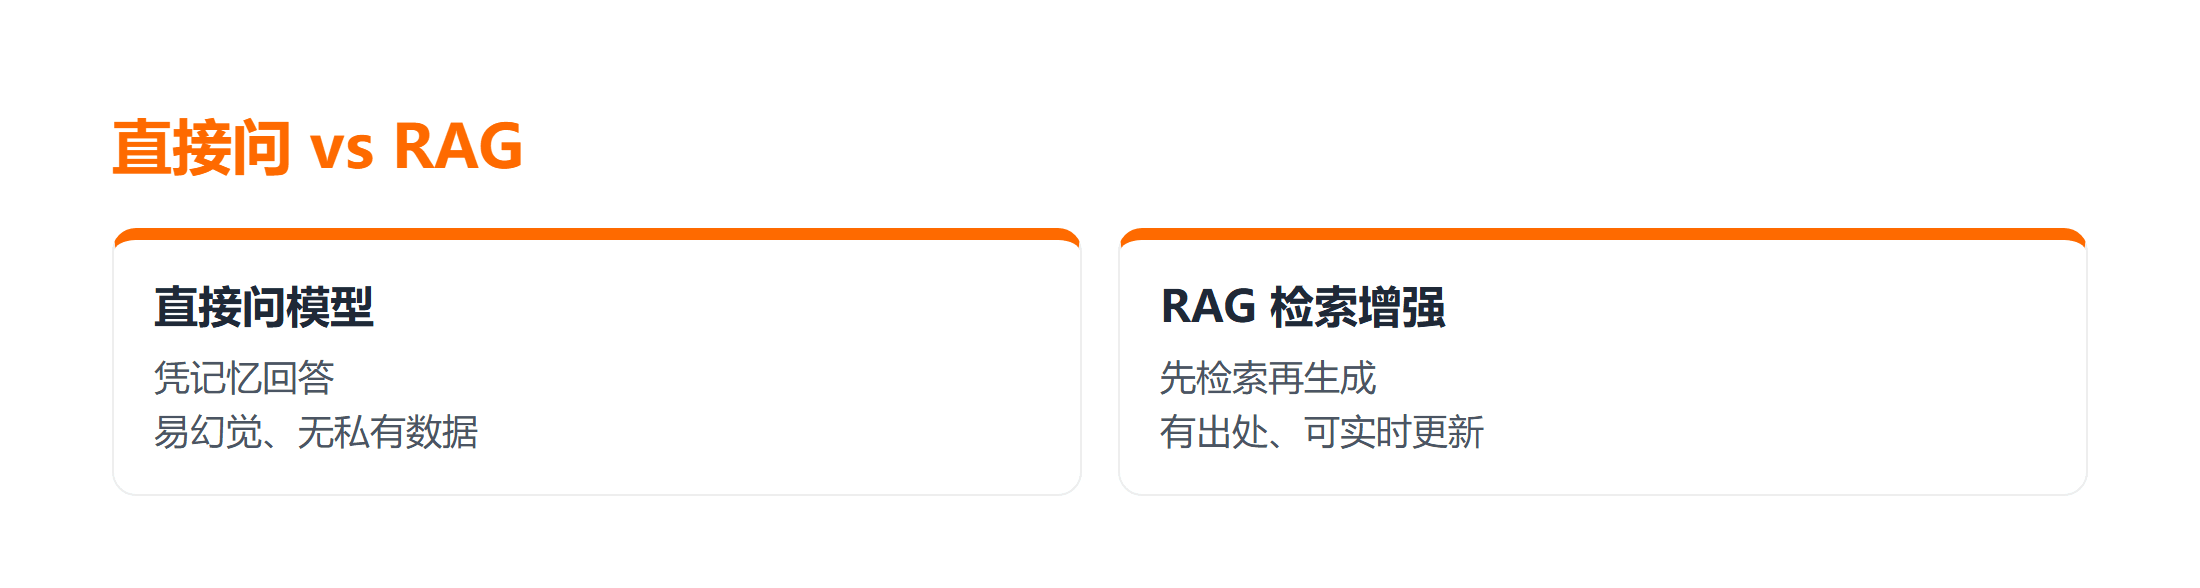
| 直接问模型 | 零配置、随问随答 | 答非所问、易幻觉、无私有数据 | 通用常识类问题 |
| 微调模型 | 风格稳定、可内化知识 | 成本高、数据更新要重训 | 大规模、长期固定的语料 |
| RAG 检索增强 | 数据可随时更新、有出处、成本低 | 检索质量决定上限 | 私有文档、最新资料问答 |
如果你的资料会频繁变动,或者想让答案"有据可查",RAG 通常是性价比最高的方案。
它解决了什么问题
大模型有两个绕不开的限制。一是知识截止:训练数据有时间边界,之后的事它不知道。二是没有私有数据:你公司的制度、你个人的笔记、内部知识库,模型都没见过。过去常见的"笨办法"是把整份文档贴进对话,但文档一长就超上下文,而且每次都要手动贴,既麻烦又容易泄密。想了解主流大模型怎么用,可看 AI 编程技能教程。
RAG 把"找资料"和"写答案"拆成两步:先根据用户问题去资料库里检索出最相关的片段,再让模型只基于这些片段作答。模型不再靠记忆硬编,而是看着检索来的真实内容组织语言,幻觉率显著下降,答案也天然带有可追溯的来源。
核心概念与三个角色
一套最小可用的 RAG 通常由这几部分构成:
- 向量库(Vector Store):存放资料"语义指纹"的数据库。普通搜索靠关键词匹配,向量库靠"意思相近"。它存的是每段文本的嵌入向量。
- 嵌入模型(Embedding Model):把一段文字变成一串数字(向量)的模型。意思越接近的文字,向量在空间里越靠近。
- 检索器(Retriever):用户提问时,把问题也变成向量,去向量库里找最相近的几段资料。
- 生成器(Generator):通常是大模型,拿到"问题 + 检索到的资料"后生成最终回答。
这四者串起来,就是"先检索、后生成"。其中嵌入模型和向量库决定了"能不能找到对的资料",是 RAG 效果的天花板。
一次问答是怎么发生的
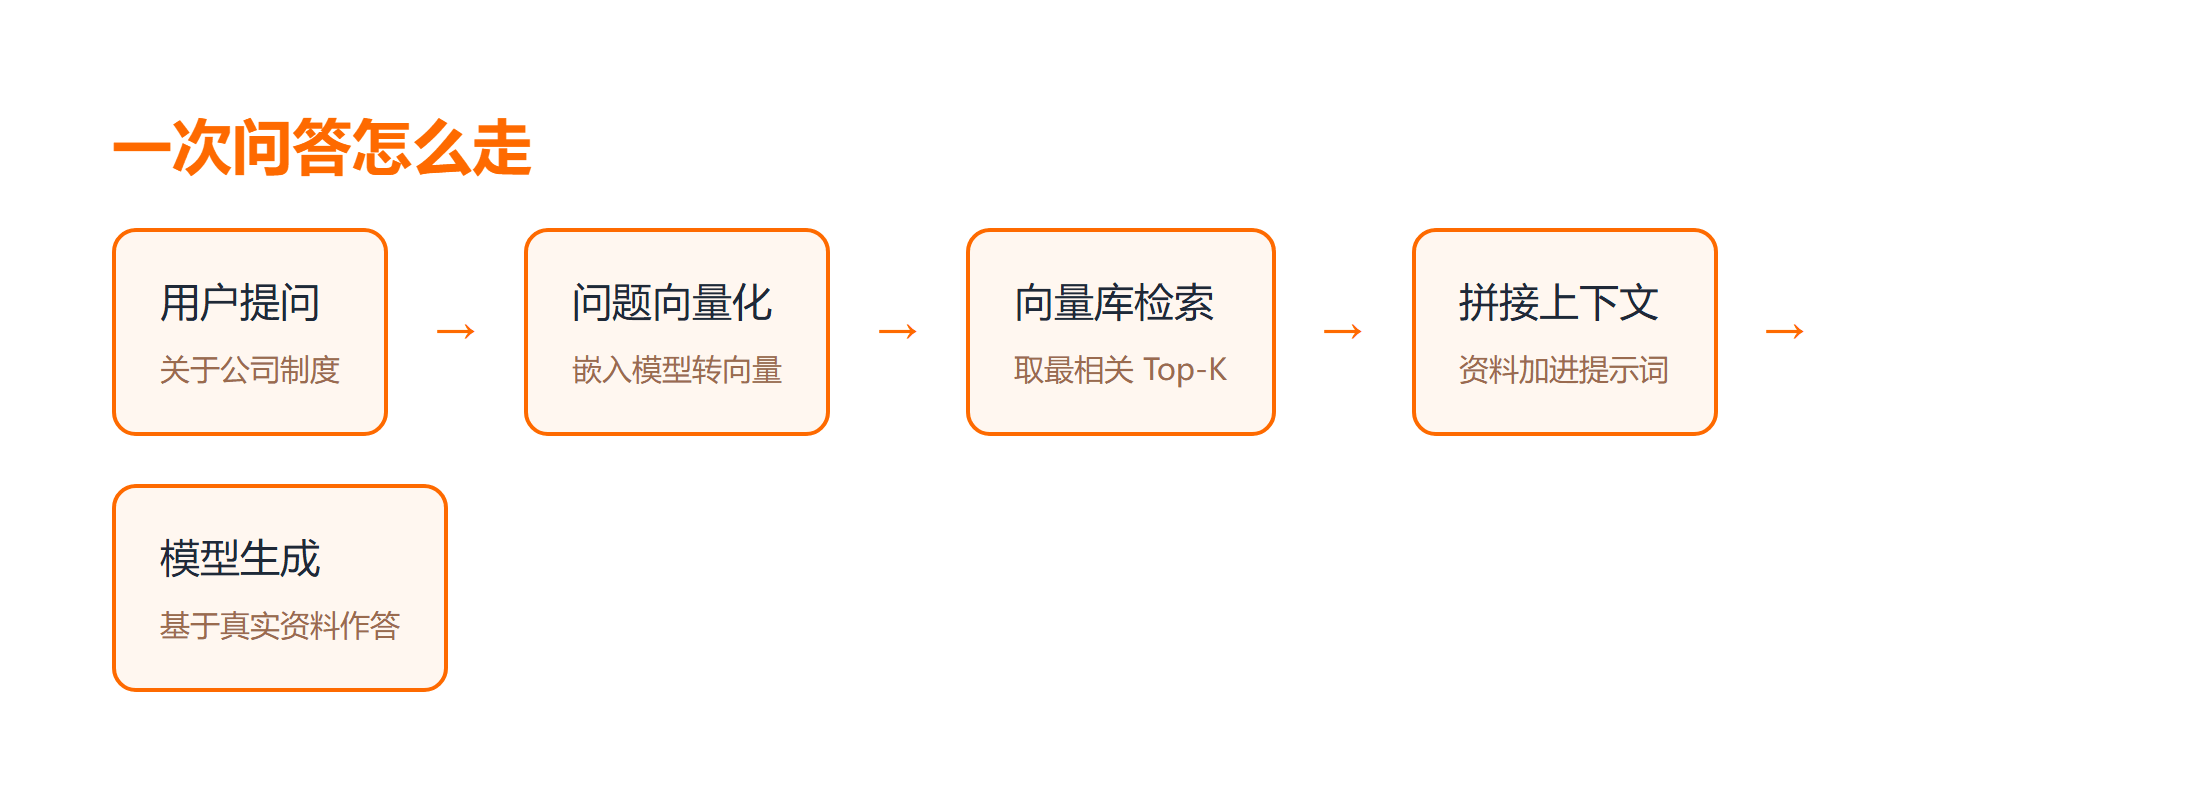
把上面四部分串起来,一次"用公司制度问答"的过程是这样:
- 建库(离线):把制度文档切成分段,每段用嵌入模型转成向量,存进向量库。这一步只需做一次,资料更新时增量补充即可。
- 提问(在线):用户提问,系统把问题也转成向量。
- 检索:去向量库里找与问题最相似的几段资料(Top-K),比如最相关的 3 段。
- 拼接:把问题和这 3 段资料拼成一个带上下文的提示词。
- 生成:模型基于这段真实资料作答,并尽量标注来源段落。
注意第 1 步的"切分"很关键:切太粗会带入无关内容、浪费上下文;切太细则检索容易漏。实务中常按语义或固定长度切,再带一点重叠,这直接影响 RAG 的检索质量。
怎么开始用
对个人或小团队,最快的 RAG 入门是先用现成的向量库把文档建成索引,再用一个支持 RAG 的客户端提问。以本地起一个向量库的思路为例(环境准备可参考 w3cschool 教程),核心步骤是:
# 1. 安装一个轻量向量库(示例:chromadb)
pip install chromadb
# 2. 用嵌入模型把文档分段写入
# 3. 提问时先检索 Top-K 再交给模型
落地 RAG 时记住两点:一是资料要切得干净,去掉页眉页脚等噪声;二是检索到的内容要带原文出处,方便你回查。不要为了省事把整本手册一次性塞进提示词,那样既贵又容易让模型抓不住重点。
配置好向量库后,先运行一次建库命令并跑检索验证:检查返回的 Top-K 是否贴合问题,预期能拿到最相关片段;若结果失败或偏离,调整切分长度再修复重试。(以下流程依据 RAG 主流实现与官方文档,按你的数据规模调整。)
总结
RAG 的本质是"给大模型外接一个可随时更新的资料库"。它不改变模型本身,而是通过在回答前先检索相关事实,让答案建立在你提供的真实资料之上。相比微调,它成本低、数据可实时更新、答案可追溯,是私有知识问答最务实的入口。
常见问题
Q:RAG 和微调该怎么选?
资料常变、要可追溯、预算有限,选 RAG;语料固定、追求稳定风格且量大,再考虑微调。很多生产系统两者并用。
Q:为什么有时候 RAG 也答错?
多半是检索没找对资料:切分太粗、嵌入模型不够好、或 Top-K 太小。先优化检索质量,再怀疑生成。
Q:我的文档安全吗?
取决于向量库部署在哪。本地或内网部署,数据不出域;用第三方托管服务则要确认其隐私条款。
Q:资料更新了要重来吗?
不用全量重来。多数向量库支持增量写入,只把新增或变更的段落补进去即可。
延伸学习
- DeepSeek 从入门到上手 — 想先搞懂主流大模型怎么用,这篇适合打底。
- TRAE AI 实战课 — 想用 AI 真做个项目,这门实战课合适。
- DeepSeek 中文教程 — 顺手补一下大模型使用基础。