
 TRAE-AI编程

AI 编程助手生成的代码,不能复制粘贴就上线。正确做法是先验收再合并:读懂、跑通、复查差异三步,把不可信的输出变成可上线的代码。本文给你一份能直接照做的验收清单,并标出最容易被忽略的安全与依赖风险。跟着做一遍,你就能在享受 AI 编程效率的同时,把踩坑概率压到最低。下面先看结论,再逐步拆开。哪怕只是改个函数,也值得花三分钟走完这三步,比上线后半夜排错划算得多。
先看结论
把 AI 代码验收拆成三步,缺一步都别合并:第一步读懂,让模型解释每段代码在做什么,确认没有偷偷调用未知接口或命令;第二步跑通,在隔离环境运行,用最小输入验证主路径和边界;第三步复查,git diff 逐行看改动范围,跑测试与 lint 确认无副作用。为什么不能直接用?因为模型会一本正经地编造不存在的函数、漏掉错误处理、甚至写出删库命令。验收不是不信任 AI,而是工程上必需的最后一道闸。
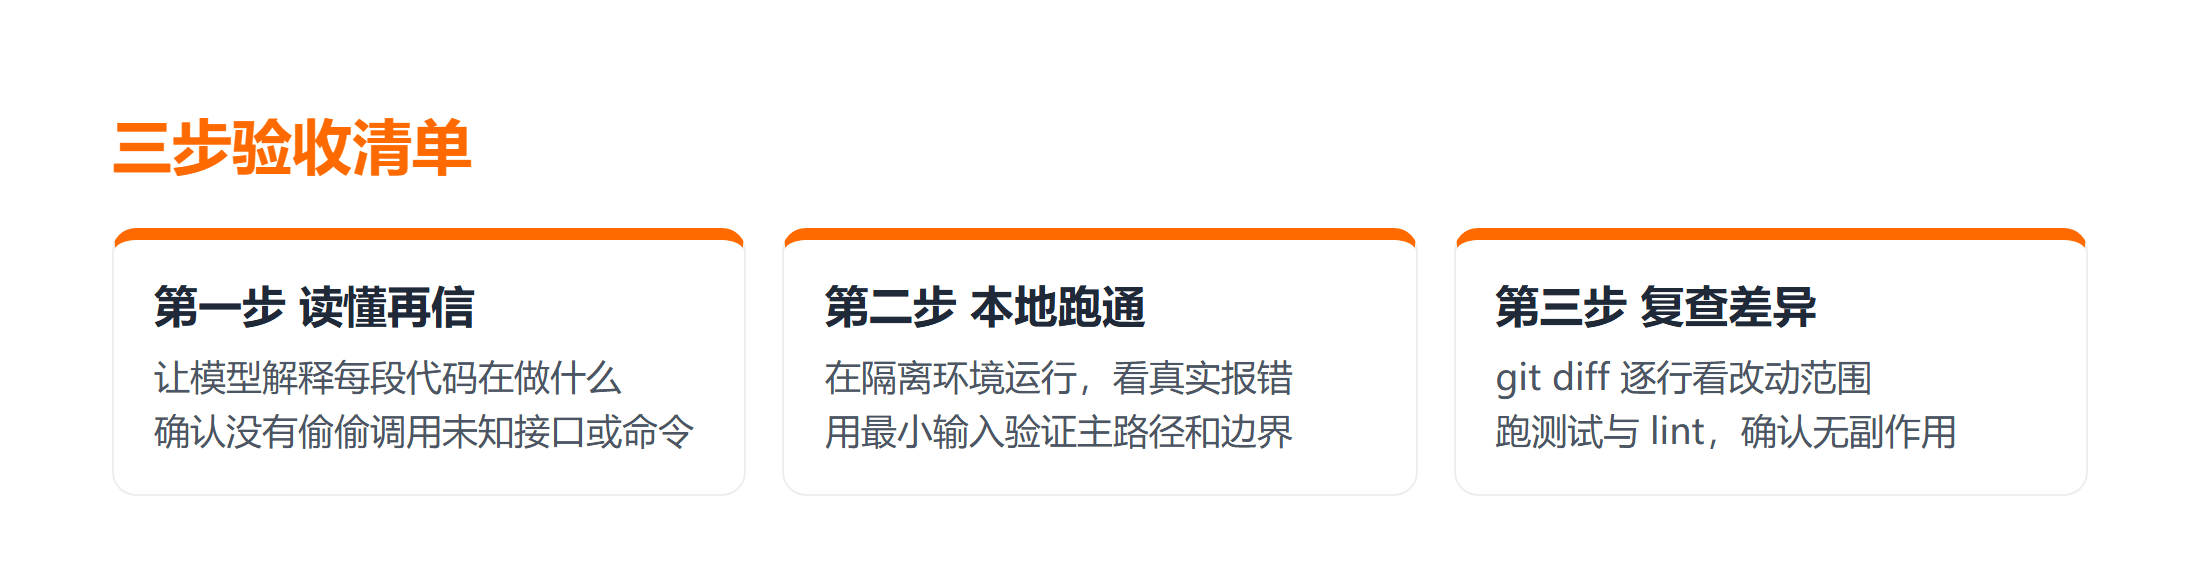
对照来看:小改动走完三步几分钟,大功能建议补一套自动化测试,把验收固化下来。下面把每一步展开。
第一步 读懂再信
拿到代码先别运行,先让它自己解释。最直接的方式是追问一句:「逐段说明这段代码在做什么,哪些地方依赖了外部库或系统命令?」如果模型说不清,或者你发现它在调用没见过的接口,就该警惕。
重点看三件事:一是有没有未定义的符号,模型常把想象中的 API 当真;二是有没有副作用,比如写文件、发请求、改环境;三是错误处理是否完整,纯 happy path 的代码一上线就崩。读懂这一步的成本极低,却能挡掉大部分低级错误。关于 AI 编程的整体边界,AI 人工智能教程 有更系统的说明,建议配合阅读。
第二步 本地跑通
读懂之后,在隔离环境里真跑一次。不要用生产目录,新建一个临时项目或虚拟环境,避免误改已有代码。用最小、最典型的输入验证主路径,再用空值、超大值、异常值碰边界。
# 新建隔离环境并安装依赖
python -m venv .venv
source .venv/bin/activate

# 跑单元测试
pytest -q

# 只跑受影响的测试文件
pytest tests/test_order.py -q
跑通时记录实际输出,和你的预期结果对一对。下面的风险表把常见雷点列成了检查项,照着勾一遍:
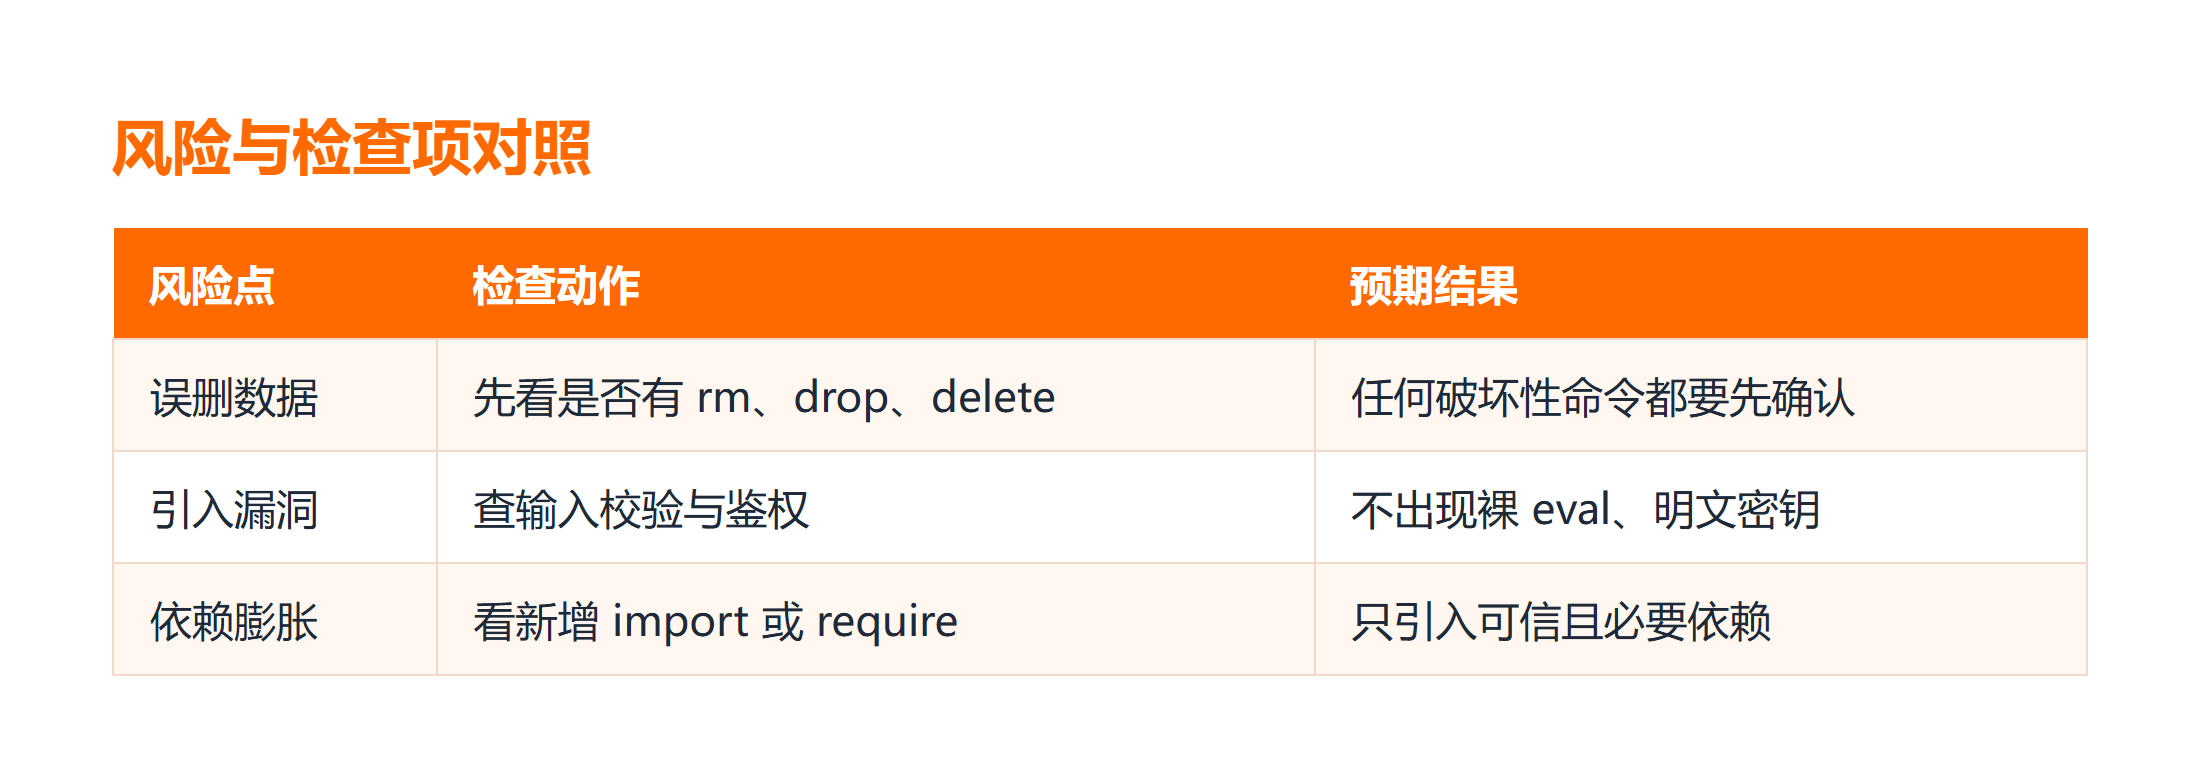
安全这一栏最容易被忽略。模型可能写出裸 eval、明文密钥、或带 rm、drop、delete 的破坏性语句。涉及自主执行与工具调用的智能体,风险更高,OpenClaw 文档 专门讲了权限与沙箱的最小化配置,做 AI 编程时值得参考。
第三步 复查差异
代码跑通不代表能合并。用 git diff 逐行看这次到底改了什么,范围是不是你预期的那么小。
# 看本次所有改动
git diff

# 看某个文件的具体改动
git diff src/order.py
复查时重点确认:有没有顺手改了不相关的文件,有没有把调试用的 print 留在线上,有没有引入新的第三方依赖。最后补一句 lint 和格式化,让风格和仓库一致。验收命令来自主流工程实践(根据文档整理),可直接套用;把它变成团队里的固定动作,比每次靠人肉检查稳得多。
新手常犯的验收误区
误区一:看着能跑就合并。现象是隔天报 bug;原因是只验了主路径、没碰边界;修复是先补边界用例再合并。检查边界是验收里最该坚持的一环。
误区二:直接在生产环境试。现象是误删数据或配置;原因是没隔离;修复是永远在临时环境先跑,确认无害再上。失败案例大多来自这一步的偷懒。
误区三:不问来源就信。现象是依赖了个不存在的库;原因是没核对 import;修复是本地运行前先列一遍依赖,只留可信且必要的。验证依赖来源,比事后排错省十倍时间。想深入 AI 辅助开发的完整流程,可以看 Cursor 文档 里的实战章节。
总结
AI 生成的代码不是不能用,而是不能盲用。记住三步:读懂再信、本地跑通、复查差异,每一步都对应一个真实会出错的点。安全与依赖是最高频的雷区,单独列检查项最划算。把这套验收清单固化成你的习惯,AI 编程的效率才真正落得了地。
常见问题
Q:小改动也要走三步吗?
看风险。改个文案、调个常量,扫一眼 diff 就够了;但凡动了逻辑、接口、依赖,就老老实实跑通加复查,别凭感觉。
Q:没有测试怎么办?
先手写一个最小单元测试用例覆盖主路径,跑通再说。能在几分钟内补的测试,远比上线后半夜救火划算,这也是代码验收的底线。
Q:模型说代码没问题,能信吗?
不能。模型的「没问题」只是它的自我判断,不等于通过运行验证。任何结论都要用实际运行和差异复查来佐证,别把解释当保证。
Q:团队协作怎么落地这套清单?
把三步写成 PR 模板的勾选框,把 pytest 与 lint 接进 CI,让机器替人盯住跑通与复查,人工只审逻辑与安全风险。



