
 TRAE-AI编程

你处理中文昵称、订单号或者一段长文本时,是不是经常要“从第几个字开始,拿前面几个字”?直接砍可能砍出乱码。PHP 字符串截取,最稳的做法是用 mb_substr 按字符数截取;遇到纯英文或字节场景才用 substr。本文用最小示例讲清三种写法的区别、怎么避免中文乱码,以及两个边界坑。看完你能根据场景选对函数,不再凭感觉写。今天这篇文章,编程狮就把这块讲透。无论你是要做昵称截断、订单号脱敏,还是长文本摘要,核心都是先想清楚“按字符还是按字节”,再选对函数。
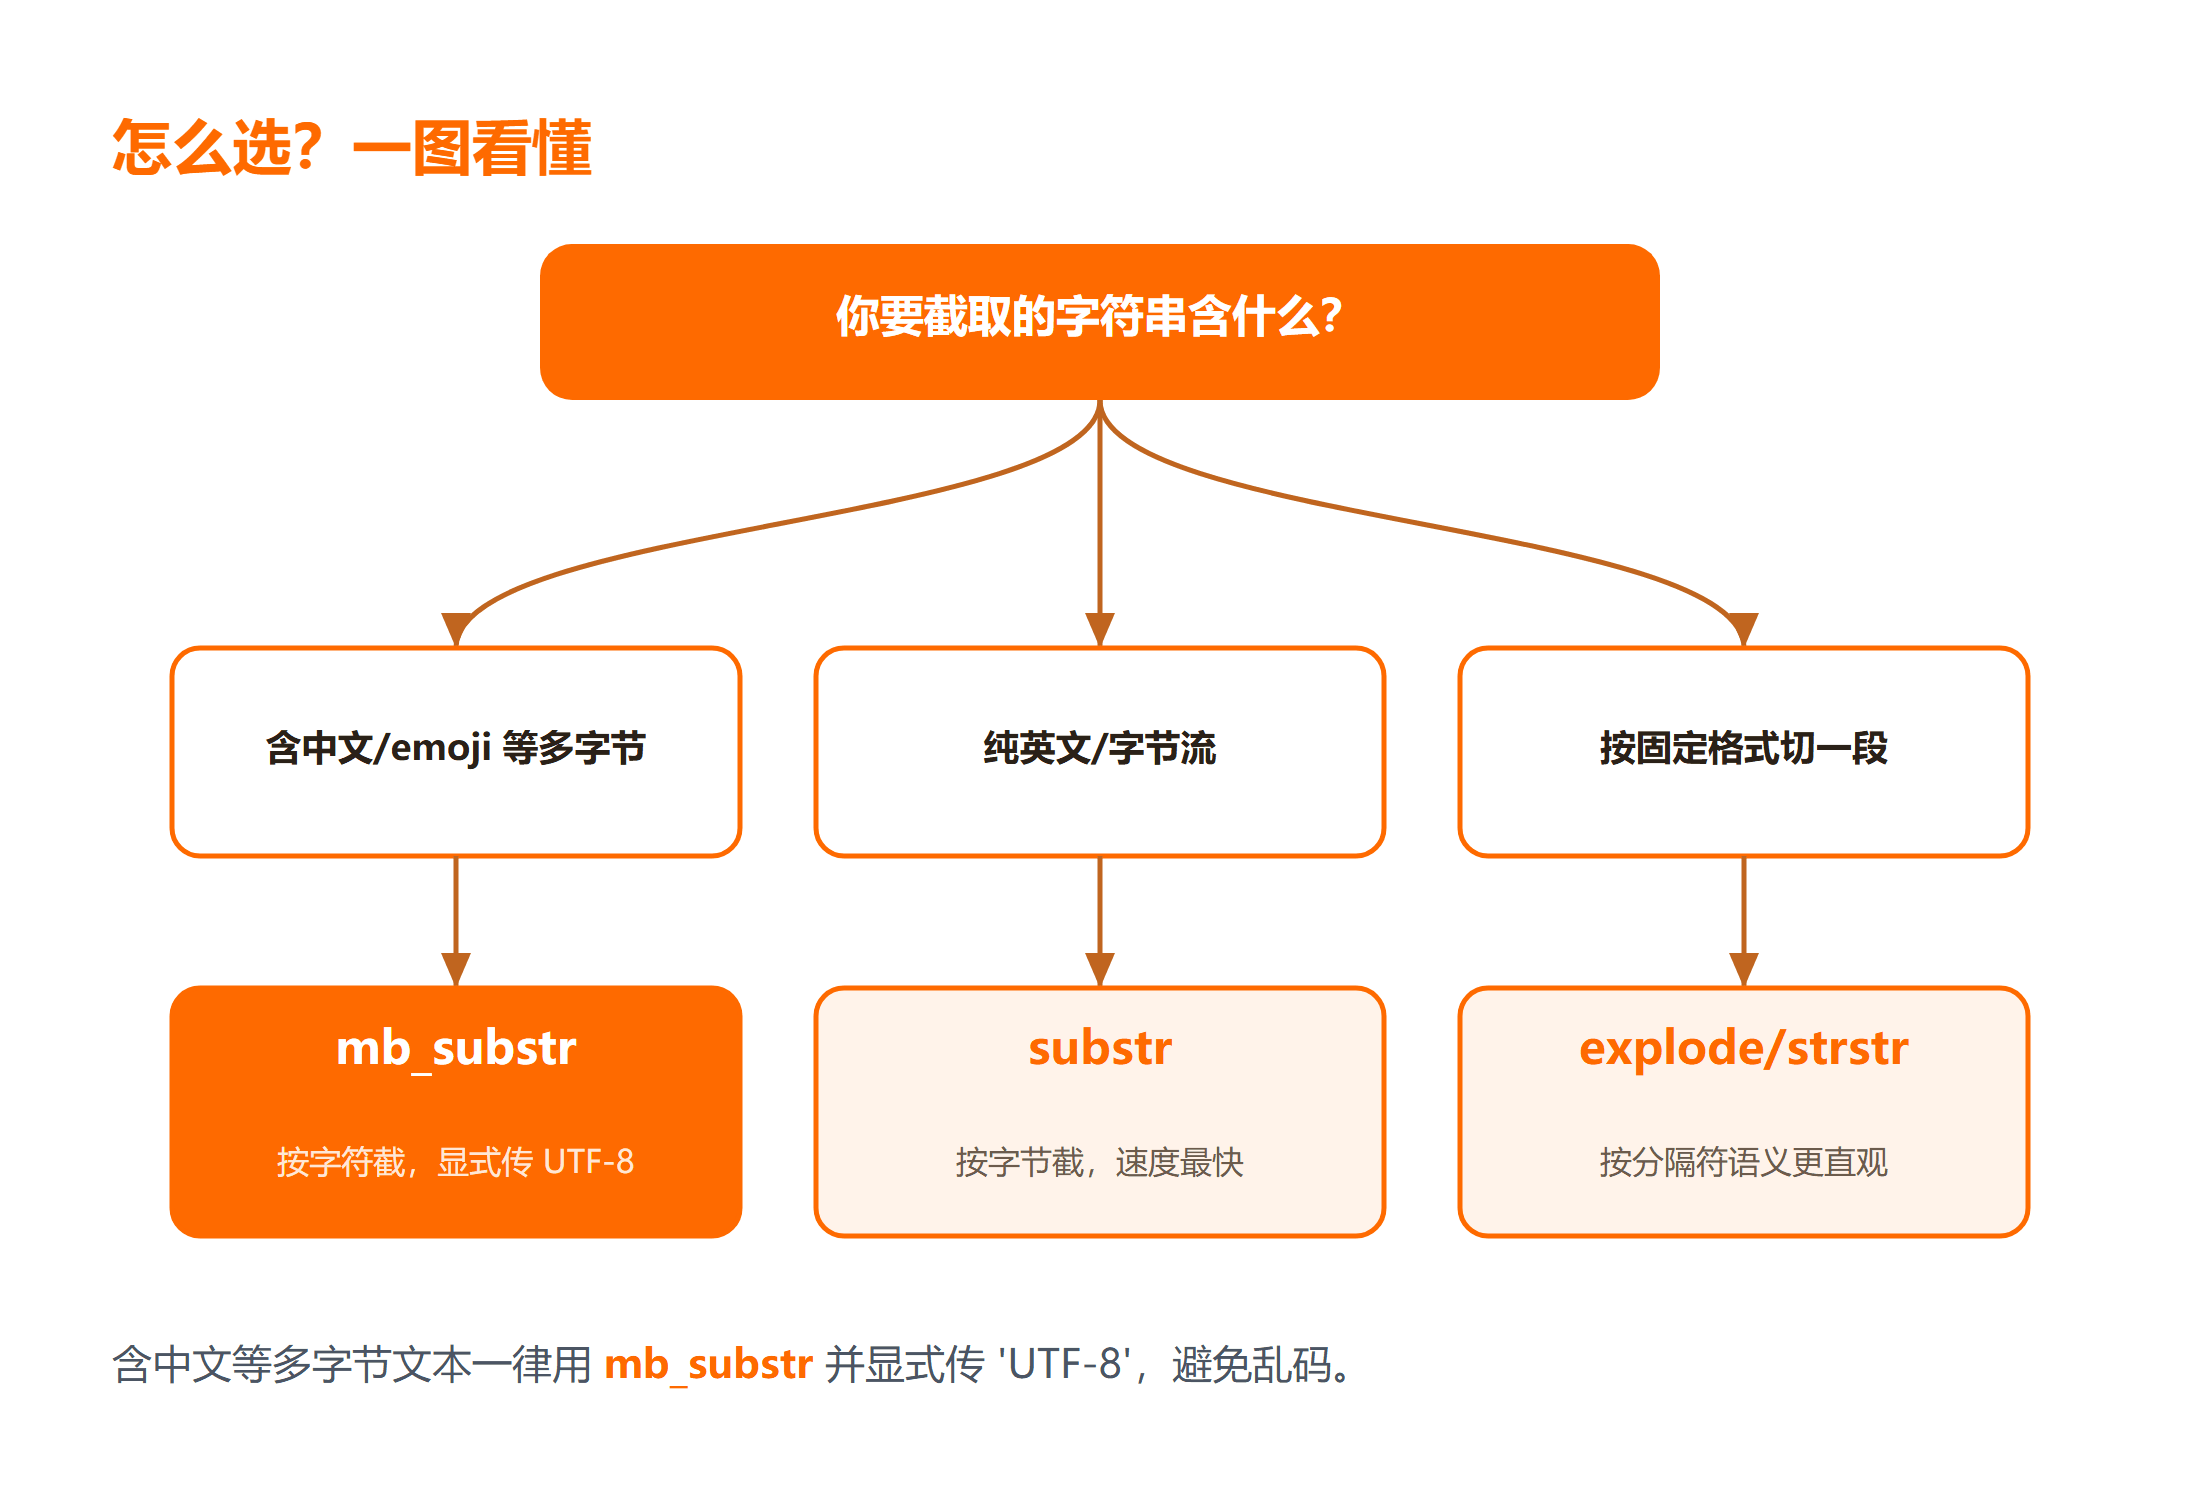
一、先看结论
| 你的场景 | 该用的函数 | 理由 |
|---|---|---|
| 含中文等多字节文本 | mb_substr($s, $start, $len, 'UTF-8') |
按“字符”数截,不乱码 |
| 纯 ASCII / 字节流 | substr($s, $start, $len) |
按“字节”截,最快 |
| 按分隔符切一段 | explode() 或 strstr() |
语义更清楚 |
二、为什么中文截取会乱码
PHP 里一个英文字母占 1 字节,而一个中文汉字在 UTF-8 下占 3 字节。substr 函数是按“字节”数截的,如果你让它从第 0 字节取 3 个字节,刚好截到一个汉字的中间,显示出来就是乱码(典型表现是一个问号或小方块)。mb_substr 则是按“字符”数截,一个汉字算 1 个字符,所以不会切坏。
一句话:含中文就用 mb_substr,并显式传编码 UTF-8。建议先过一遍 PHP 教程 的字符串章节,理解字节和字符的区别。
三、方法一:mb_substr 按字符截(最推荐)
<?php
// 演示:从“编程狮教程”里取前 2 个字符
$text = "编程狮教程";
// mb_substr(字符串, 起始位置, 长度, 编码)
$part = mb_substr($text, 0, 2, 'UTF-8');
echo $part;   // 预期输出:编程(不会乱码)
?>
上面这段做了什么:从位置 0 开始,取 2 个“字符”而不是 2 个“字节”,所以“编程”两个字被完整取出。只要编码写对,无论中英文混排都能正确截取。
四、方法二:substr 按字节截(仅纯英文)
<?php
// 演示:纯英文场景,substr 按字节截最快
$name = "w3cschool";
// substr(字符串, 起始位置, 长度)
echo substr($name, 0, 3);   // 预期输出:w3c
?>
上面这段做了什么:字符串全是 ASCII,substr 一个字节一个字符,取前 3 字节得到 "w3c"。但如果把 $name 换成中文,substr($text,0,3) 就会切到第一个汉字的中间,出现5 大语言对比。所以 substr 只用于你确定没有多字节字符的场合。
五、方法三与两个边界坑
<?php
// 演示:取邮箱 @ 之前的部分作为用户名
$email = "user@w3cschool.cn";
// explode 按分隔符切成数组,取第 0 段
$user = explode('@', $email)[0];
echo $user;   // 预期输出:user

// 另一种:取 @ 之后的域名部分
$domain = strstr($email, '@');   // 含 @ 及其后内容
echo $domain; // 预期输出:@w3cschool.cn
?>
上面这段做了什么:explode 按 @ 把字符串拆成数组,取第一段就是用户名;strstr 则返回从 @ 开始到结尾的部分。这种“按分隔符”的语义比数长度更直观,适合处理固定格式的文本。
两个最容易踩的边界坑
| 现象 | 原因 | 修复 |
|---|---|---|
| 中文截取出来是问号/方块 | 用了 substr 且没指定多字节处理 | 换成 mb_substr 并传 'UTF-8' |
| 截取长度超过邪修 PHP本身没报错 | PHP 会返回“能拿到的部分”,不抛异常 | 截取前用 mb_strlen 判断长度,避免逻辑误判 |
第一个坑是最常见的线上乱码来源,记住“中文必用 mb_substr”。第二个坑更隐蔽:你以为截了 10 个字符,实际字符串只有 3 个,PHP 不会报错而是返回全部 3 个,下游若按“截到了 10 个”做判断就会出错。稳妥做法是先用 mb_strlen($s, 'UTF-8') 确认长度。
在真实项目里,字符串截取最常见的坑其实不是“怎么调函数”,而是“你截的到底是字节还是字符”。UTF-8 编码下,一个英文字母占 1 个字节,而一个常用汉字占 3 个字节,emoji 更是可能占 4 个字节。PHP 的 substr 按“字节”切,所以 substr("编程狮", 0, 4) 会切出前 4 个字节,也就是一个“编”字加半个“程”字,输出必然是乱码。这正是 mb_substr 存在的意义:mb_substr 按“字符”切,同样写 mb_substr("编程狮", 0, 2) 能得到完整的两个字。一句话记住——只要字符串里可能出现中文、日文或 emoji,就一律用 mb_ 系列函数,substr 只适合纯 ASCII 场景。
顺带几个高频易错点。第一,mb_substr 的第四个参数是字符编码,强烈建议显式传 "UTF-8",而不是依赖 mb_internal_encoding() 的全局设置,否则换台服务器配置不同,结果就可能不一致。第二,判断字符串长度也要用 mb_strlen 而不是 strlen,后者统计的是字节数,中文里会虚高。第三,做“安全截断”时不要直接按长度切了事,更稳妥的做法是先 mb_substr 到目标长度,再判断是否被截断,被截断就补一个省略号;如果截的是一段话,最好按“词”或“句”边界切,避免把一个词劈成两半。第四,处理用户输入的昵称、标题时,先在入库前用 mb_substr 限长,既能省存储,也能避免超长字符串把页面布局撑破。
从性能角度看,mb_ 系列函数因为要做多字节解析,确实比 substr 稍慢一点,但在常规 Web 请求里这点开销可以忽略;为了不踩乱码坑,这点代价完全值得。如果你的业务真的是海量纯 ASCII 文本(比如日志行、哈希值),用 substr 没问题,但绝大多数业务场景都该默认 mb_。最后提醒一句:截取只是“展示层”的处理,原始数据尽量原样入库,展示时再按需截断,这样以后想换更长或更短的展示规则,都不用回刷历史数据。
除了上面三种写法,还有一个常被忽略的细节:截取位置和长度都从 0 开始计数,mb_substr($s, 0, 5) 取的是前 5 个字符而非第 5 个;如果起始位置写成负数,不同 PHP 版本行为不一致,建议始终用非负数并先用 mb_strlen 判断长度。另外,展示层截断后最好补省略号提示“内容已省略”,避免用户误以为数据缺失。
动手前先配置好 PHP 运行环境,把示例命令复制到本地运行,检查截取输出是否符合预期;若中文出现乱码,按“含多字节就用 mb_substr”的方向排查失败原因并修复。版本差异与边界情况下面根据 PHP 官方文档整理,未在本机逐版本执行。
总结
要点带走:
- 含中文等多字节文本,一律用 mb_substr 并显式写
'UTF-8',别用 substr; - 纯英文或字节流才用 substr,它按字节截、速度最快;
- 按固定格式(如邮箱、路径)截取,优先考虑 explode / strstr,语义更清楚;
- 截取前用
mb_strlen确认长度,别假设字符串够长。
下一步建议系统过一遍 PHP 教程,把字符串函数和数组函数一起练熟。
延伸学习
想把这块知识系统补齐,可以按这个顺序来:
- PHP 速查手册
- 在线工具推荐
- C 与 PHP 对比
常见问题
Q:substr 和 mb_substr 到底差在哪?
A:substr 按“字节”数截取,mb_substr 按“字符”数截取。中文在 UTF-8 下 1 个字占 3 字节,用 substr 容易切到汉字中间产生乱码;mb_substr 指定编码后按字截,不会乱。
Q:为什么一定要写 UTF-8 参数?
A:mb_substr 的编码参数不写会沿用 php.ini 的默认内部编码,不同服务器配置不同,可能仍是乱码。显式传 'UTF-8' 才能让行为稳定可预期。
Q:截取超出长度会报错吗?
A:不会。PHP 会返回“能取到的那部分”,不抛异常。所以如果你的业务逻辑依赖“确实截到了 N 个字符”,要先 mb_strlen 判断,不能只看截取结果。



