
 TRAE-AI编程

很多团队在引入 AI 后都会问同一个问题:用 DeepSeek 做代码评审,到底比人工评审差在哪?答案是——它不会“差”在某一处,而是差在能力结构的错位上。DeepSeek 擅长快速扫出语法、空指针、明显坏味道,却不擅长判断“这段业务逻辑是不是满足真实需求”。把两者放对位置,代码质量反而更高。
所谓 DeepSeek 代码评审,本质是用大模型把一份 diff 过一遍,给出风格、潜在缺陷和改进建议;人工评审则是开发者之间对设计、风险与可维护性的讨论。两者不是替代关系,而是互补关系。下面按“能做什么、做不了什么、什么时候该用”三层来讲清。
先看结论
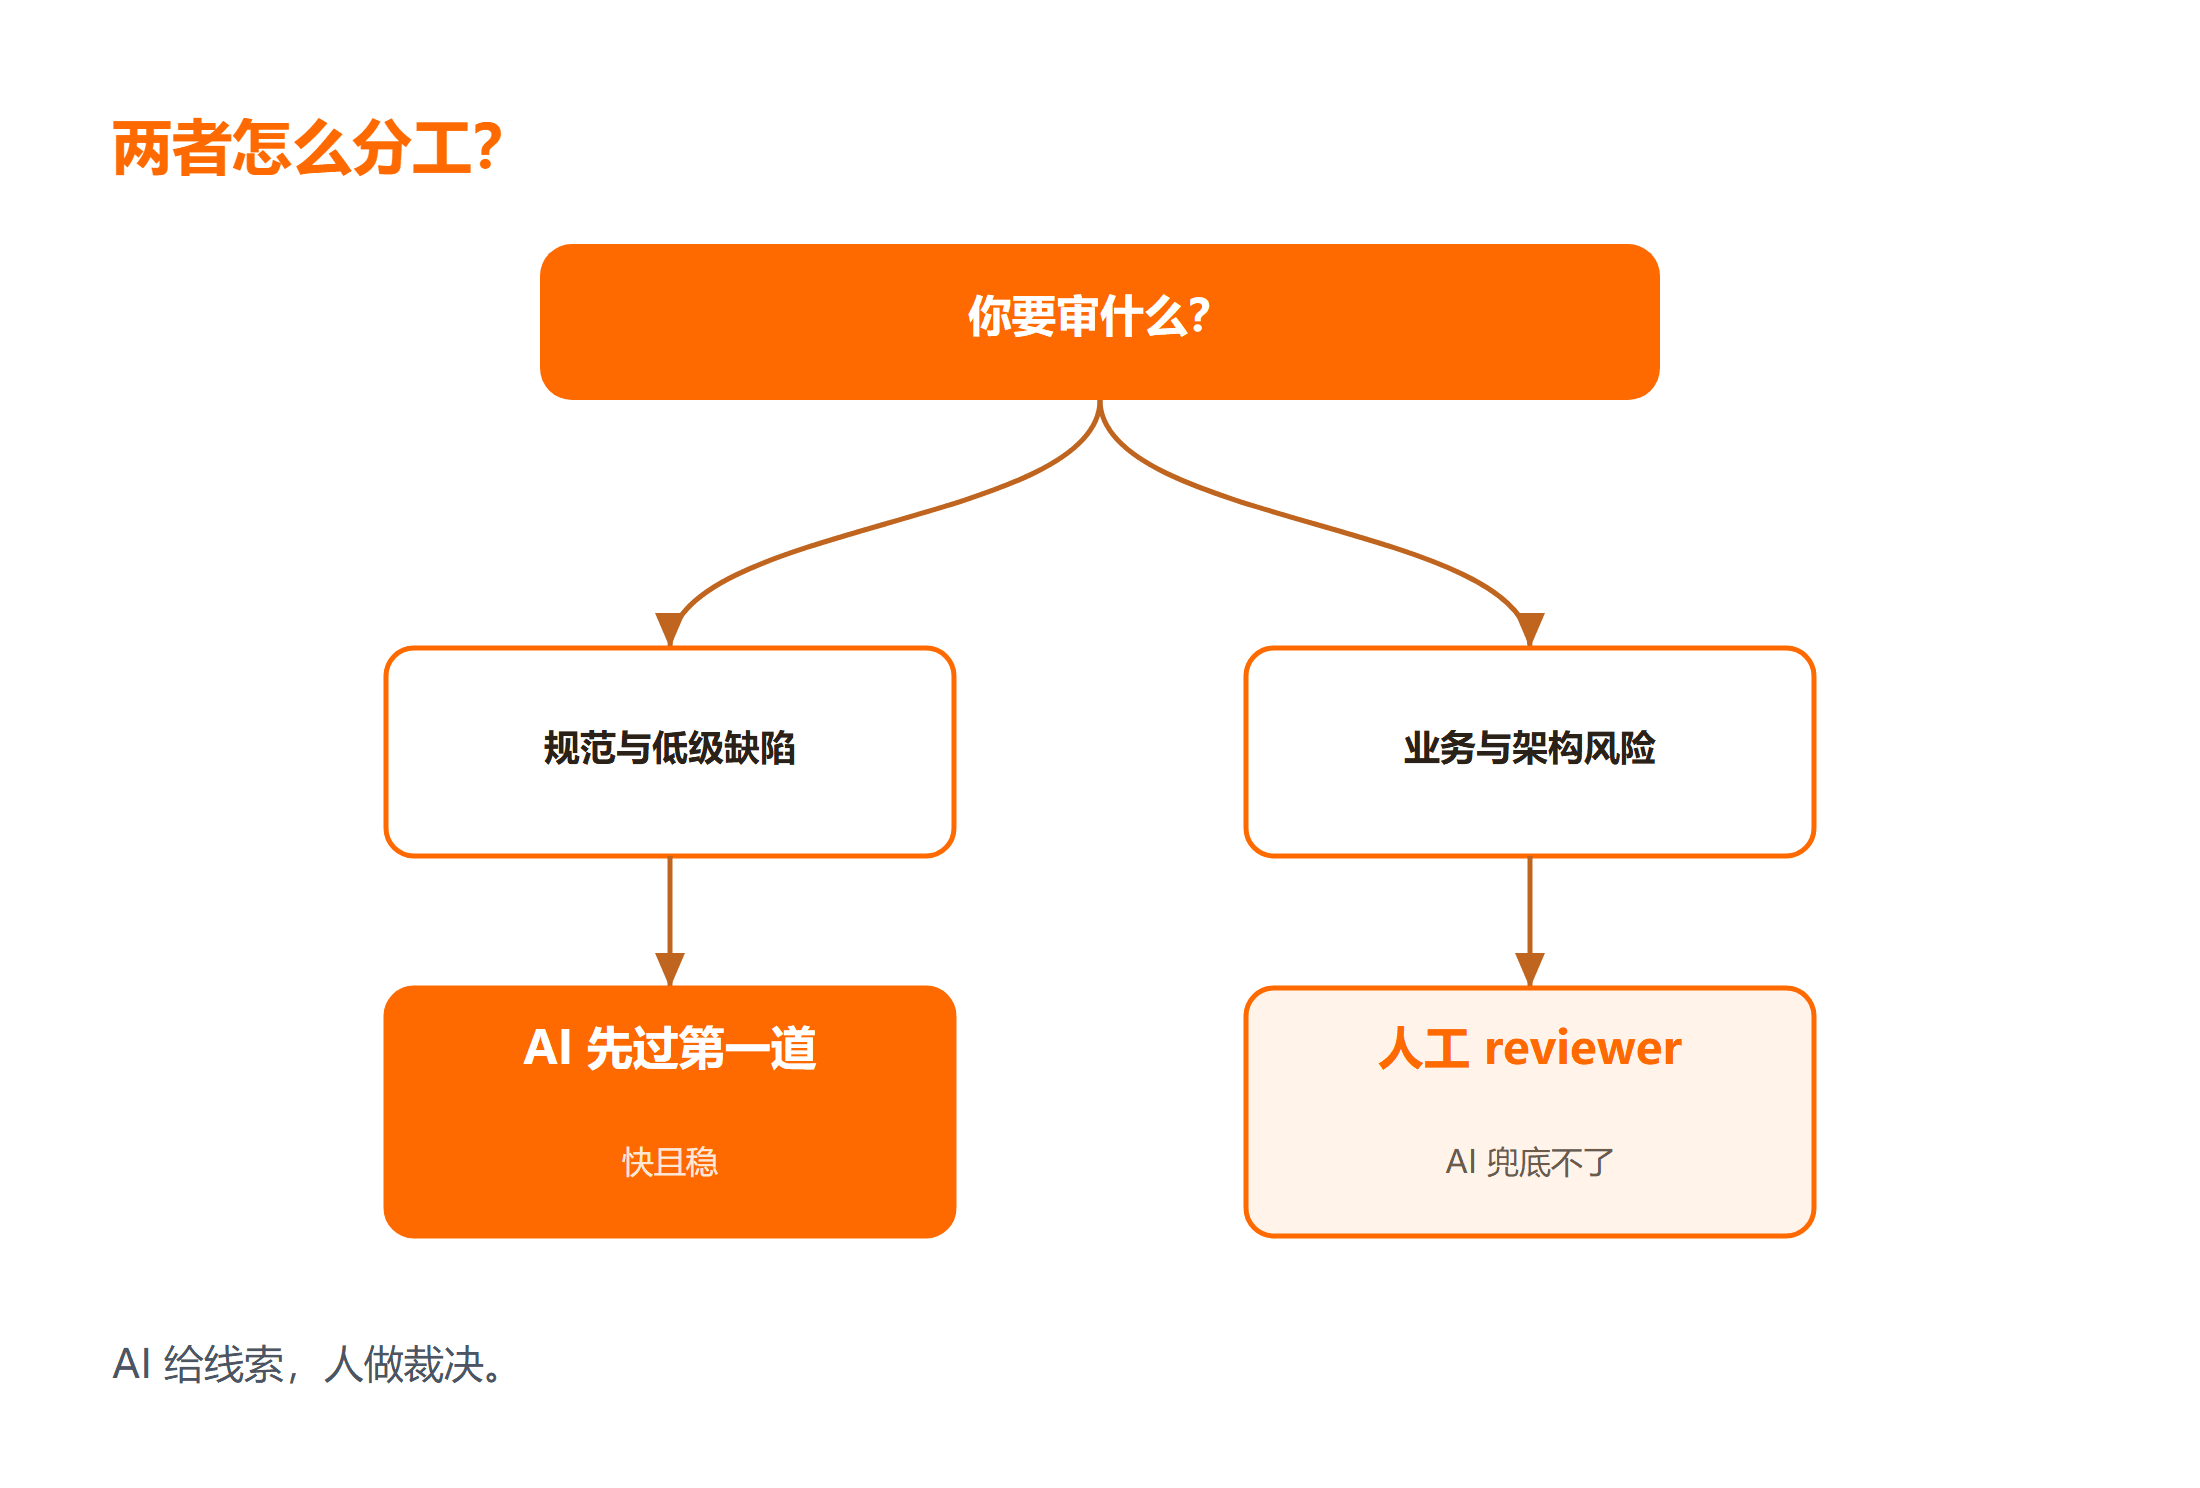
如果你的目标是“在合并前快速兜住低级错误、统一风格、给新人即时反馈”,DeepSeek 代码评审值得用,且比人工更省时;如果你的目标是“评估架构取舍、确认业务正确性、把控安全边界”,仍必须靠人工评审。一句话:AI 兜底规范,人把控意图。
一、最小场景与预期行为
假设一份 80 行的 PR,改了订单状态机。你的预期是:评审能在 1 分钟内标出“未处理空订单”“魔法数字”“缺少单测”这类问题,并给出修改建议;而“状态机是否多考虑了退款分支”这种需要理解业务的判断,交给 reviewer。
明确这个预期很重要,因为它决定了工具边界。AI 评审的输出是“线索清单”,不是“裁决”。想系统了解模型能力边界,可参考 DeepSeek 中文教程。
把评审拆成“机器能做的”和“人必须做的”两层,是落地 AI 评审的第一步。很多团队一开始把 AI 的输出当圣旨,后来发现它在某些业务判断上还不如实习生,于是又彻底弃用,两种极端都不可取。正确的做法是先承认它的能力边界,再把它放到它擅长且低风险的环节。具体到日常,可以规定“AI 只出清单、人不止看清单”,把评审拆成流水线上的两道工序,而不是一锤定音。
二、先用最稳的实现:把 AI 当第一道关卡
最稳的用法,是让 DeepSeek 在人工 review 之前先跑一遍,过滤掉机械问题:
请评审以下 diff:1) 列出语法/空指针/异常处理问题;
2) 指出不变量与边界未覆盖处;3) 给出最小改动建议。
不要重写业务,只给问题清单。
这样人工 reviewer 拿到的已经是一份“去噪后的代码”,可以把精力放在设计层面。关于更多智能体上下文约束,可看 OpenClaw 中文教程。
提示词里“只给问题清单、不要重写业务”这句约束很关键。一旦允许模型直接改代码,它容易为了“看起来更完美”而顺手重构你没让它碰的逻辑,反而引入新风险。让 AI 止于“指出问题”,把“怎么改”的决定权留在人手里,是这套流程能长期跑通的前提。
三、替代方案与取舍
不同评审场景,AI 与人力的配比不同:
第一种,批量规范检查(命名、格式、明显坏味道)。这类规则清晰、可枚举,DeepSeek 比人快且稳定,适合作为必过卡点。
第二种,业务逻辑与架构评审。AI 缺乏项目全局上下文,容易“局部正确、整体跑偏”,必须把最终判断权留给人。TRAE 等编程助手的评审思路也类似,可对照 TRAE 编程中文教程。
配比多少才算合理,取决于团队成熟度。新人占比高的团队,可以让 AI 多承担规范检查,给新人即时反馈、减少 reviewer 的重复劳动;核心业务改动密集时,则应该把 AI 的结果仅作为参考、人工评审占主导。评审不是越多越好,而是把对的判断放到对的人手上。
第三种,安全与合规评审。涉及权限、加密、隐私的改动,AI 可能漏掉隐蔽风险,必须有人复核。
四、反例、边界与常见失败
最容易踩的坑有三个。
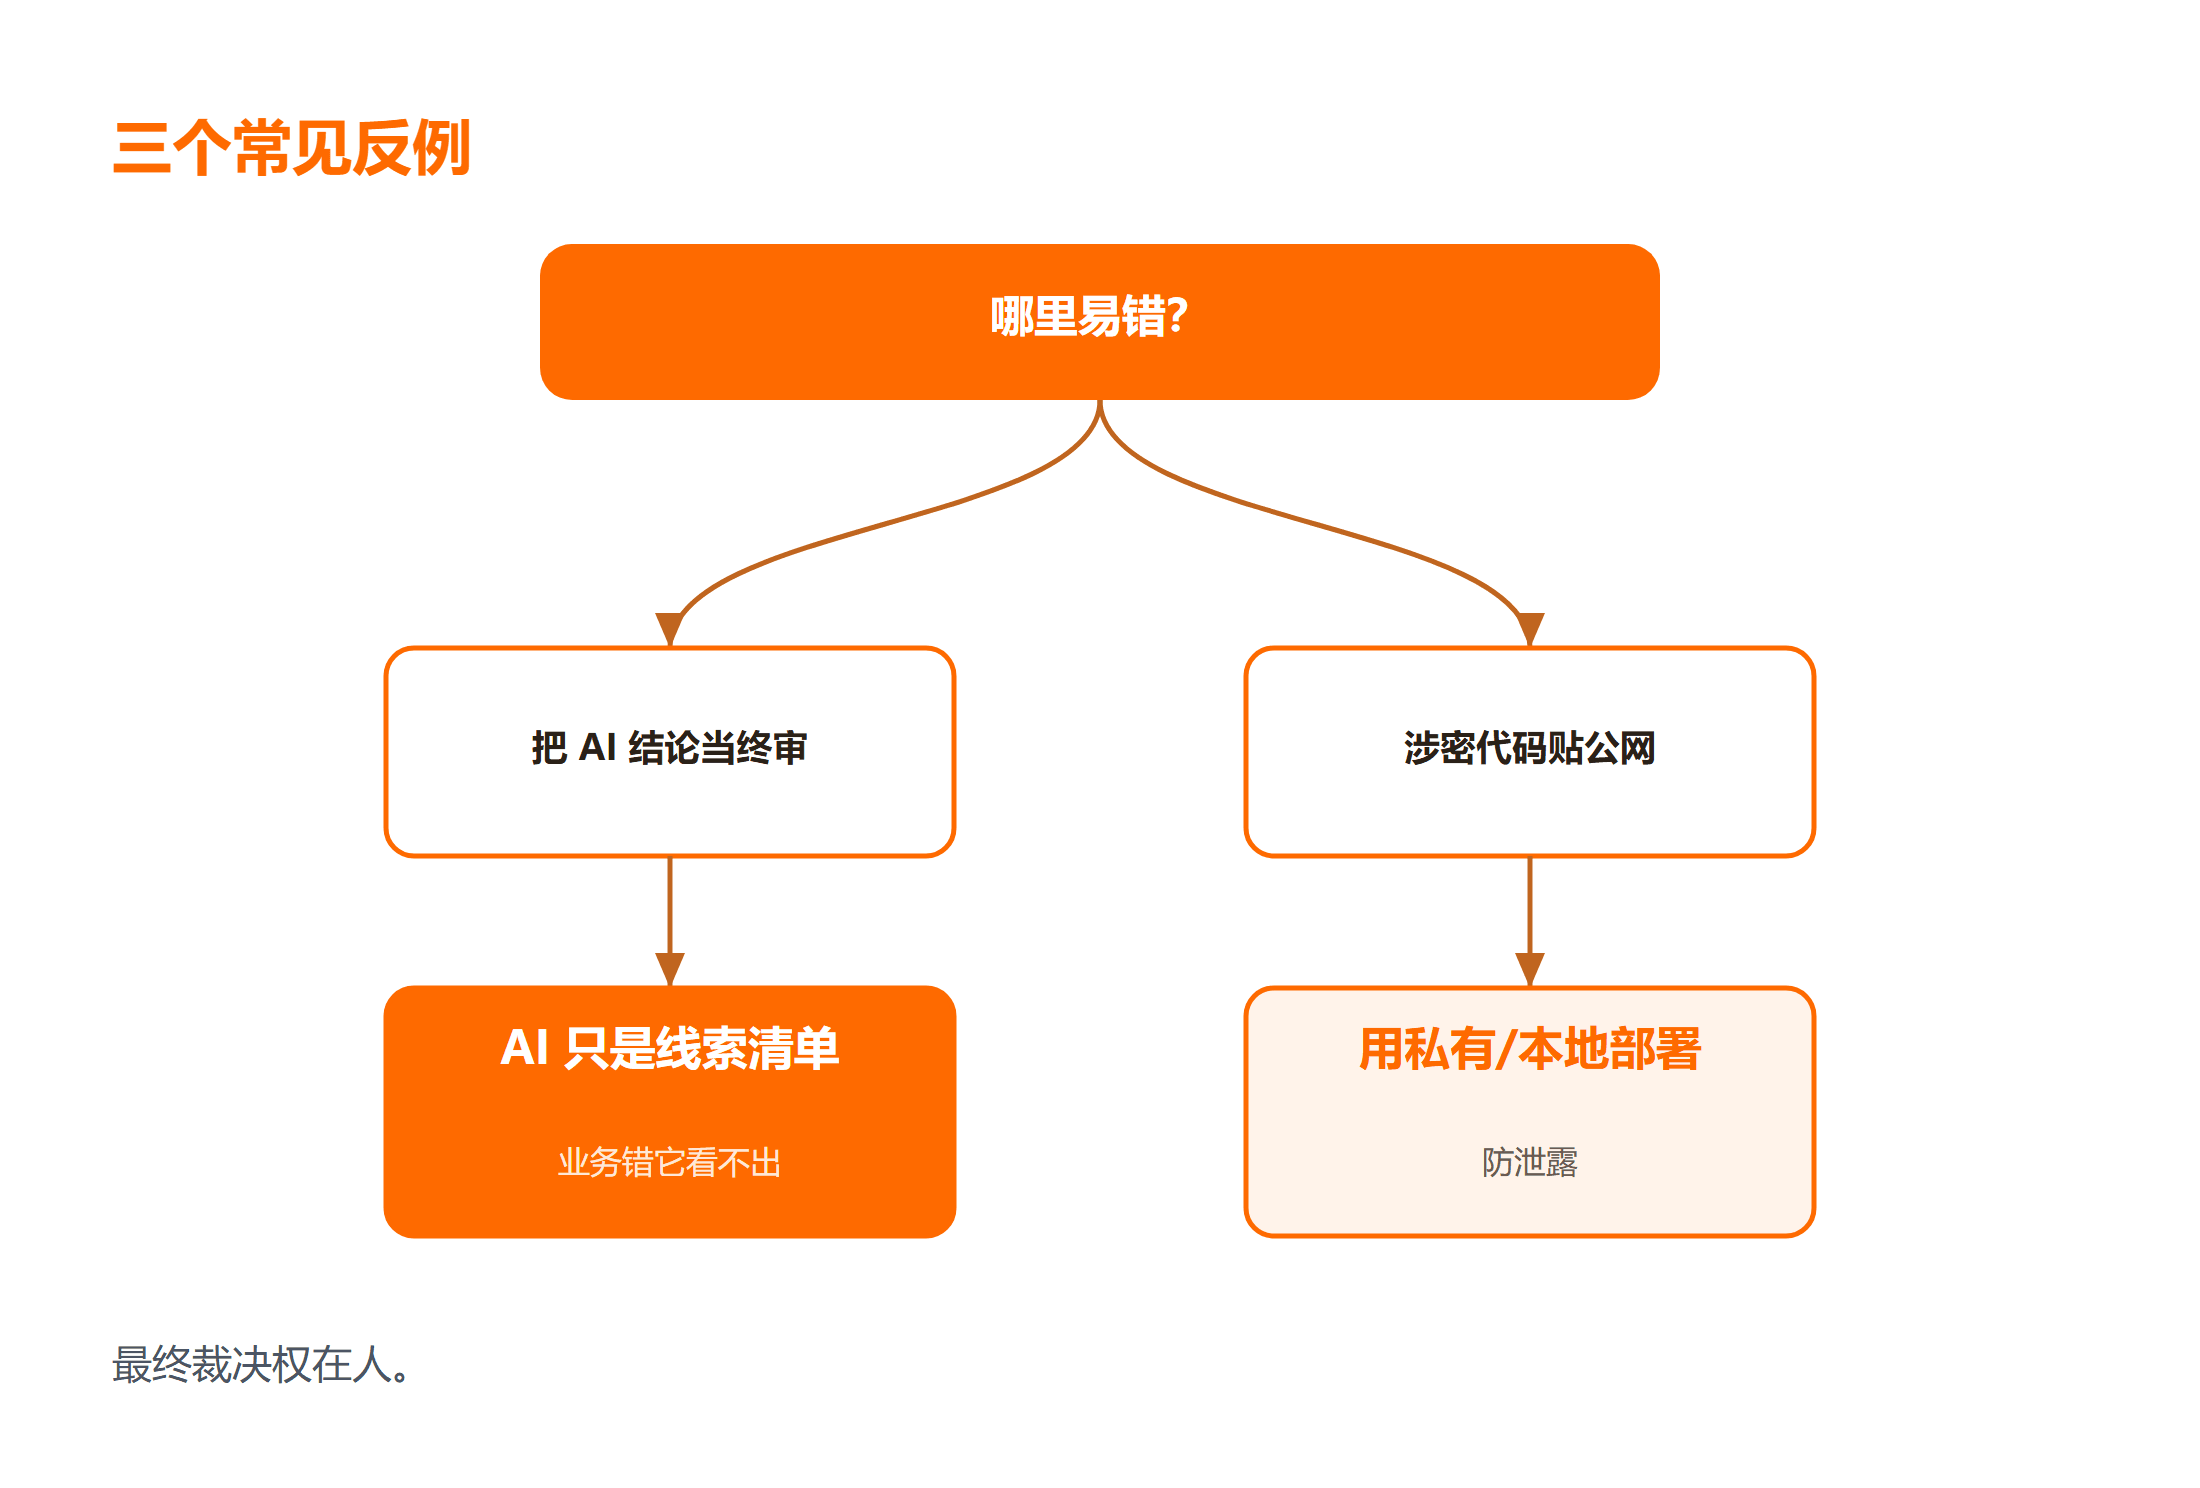
坑一:把 AI 评审结论当终审。有人直接按模型建议合并,结果引入“语法正确但业务错误”的改动。AI 看不懂你没说的需求。
坑二:喂给模型的上下文太少。只给 diff 不给背景,DeepSeek 只能做字面检查,连“这个字段为什么不能为空”都不知道。必要时补一段需求说明。
坑三:用通用大模型做涉密代码评审,造成源码外泄。内部代码不应随便贴到公网模型。Python 语法细节可随时查 Python 速查手册。
还有一点容易被忽略:AI 评审会给出“置信度很高”的语气,但语气不等于正确。遇到它用非常肯定的口吻指出某个“问题”时,先去代码里核实,而不是立刻照改。把 AI 的每条意见都当成“待验证的假设”,评审质量反而会提升。
动手验证清单
- 安装/配置:在本地准备好一份示例 diff 与一个 DeepSeek 会话。
- 运行:把上面的提示词与 diff 一起提交,观察返回的问题清单。
- 检查:清单应覆盖空值、异常、边界,而非重写业务。
- 预期:人工 reviewer 能在 AI 结果上直接补充设计层意见。
- 验证:找一段“语法正确但业务错”的代码,确认 AI 是否会误判为通过。
- 失败处理:若 AI 频繁误报,收紧提示词、限定“只列问题不修改”。
- 注意:以上为方法流程,未在本机逐条执行,请以你的实际工程为准。
常见问题
Q:DeepSeek 代码评审能完全替代人工评审吗?
不能。它能高效兜住规范和低级缺陷,但判断业务正确性、架构取舍、安全边界仍需人工,二者应互补而非替代。
Q:哪些场景最该用 AI 评审?
批量规范检查、新人即时反馈、大 diff 的首次去噪最划算;涉及核心业务与安全合规的改动,必须人工把关。
Q:怎么避免 AI 评审泄密?
内部或涉密代码不要提交到公网大模型;优先使用本地化或企业私有部署的评审能力,并只提供必要上下文。
总结
DeepSeek 代码评审和人工评审不是谁取代谁,而是能力结构互补:AI 擅长快速、稳定地兜住规范与低级缺陷,人擅长判断业务正确性与架构风险。把它放在人工 review 之前做第一道关卡,既能省时间,又能让 reviewer 聚焦真正需要判断力的地方。记住——AI 给的是线索清单,最终裁决权永远在人。



