
 TRAE-AI编程

当你盯着一段刚写完的业务函数,心里盘算“要不要补测试”时,最快的解法不是手动一行行写断言,而是让 AI 先帮你把测试骨架铺出来。AI 生成单元测试,是指用大模型或 AI 编程助手,根据函数签名、实现逻辑或已有调用,产出可运行的测试用例。它能把“写测试”这一步从纯体力活变成“审一遍、改两处”的轻量工作,但产出的质量高度依赖你给的上下文是否充足。
本文基于 Python 3.11 + pytest 8 的环境验证,覆盖三种主流做法:用 AI 编程助手在编辑器里就地生成、用对话式大模型按提示词产出、在 CI 里接入自动化测试生成。每种做法都附上可直接复制的命令与例子,并讲清适用边界,以及忽略上下文、不跑本地验证、直接信任生成结果三个常见错误。看完你不仅能把测试补上,还能判断哪条路最适合自己当前的项目。
一、先搞清楚单元测试到底在验什么
单元测试是只针对一个函数或方法、在隔离环境下验证其输入与输出是否符合预期的测试。它的价值不在于“测得多”,而在于“改坏时能立刻报警”。
用一句白话讲:单元测试就是给函数设几组典型输入,看它返回的结果是不是你预期的那样。比如一个计算折扣的函数,你喂入原价和折扣率,它应当返回正确金额;喂入非法值,它应当按约定抛错或返回兜底值。
1.1 为什么 AI 适合干这活
写单测最枯燥的部分是“构造输入、摆预期、补边界”,这套动作高度模式化,正好是大模型的强项。你给出函数源码,它往往能一次列出正常路径、空值、极值、异常四类用例。
⚠️ 注意:AI 生成的测试默认只会覆盖“它看得到的代码路径”。如果函数依赖了数据库、网络或时钟,而你没告诉它,生成出来的测试大概率会在你的环境里直接挂掉。
1.2 常见误解
很多人以为“AI 生成的测试等于可靠的测试”。其实生成只是起点,真正决定质量的是你有没有跑起来、有没有断言到关键行为。一个永远返回 True 的断言,跑了也等于没跑。
二、方案一:用 AI 编程助手在编辑器里就地生成
这是最顺手的做法。像 AI 编程技能教程 这类能力,可以直接读到你光标所在的函数,结合项目里的测试约定,就地补一个测试文件。
先在项目里装好 pytest:
pip install pytest==8.3.4假设有这样一个被测试函数:
# calc.py
def discount(price: float, rate: float) -> float:
    if price < 0 or rate < 0 or rate > 1:
        raise ValueError("参数非法")
    return round(price * (1 - rate), 2)
让 AI 助手在 test_calc.py 里生成用例,它通常会写出:
# test_calc.py
import pytest
from calc import discount

def test_normal():
    assert discount(100, 0.1) == 90.0

def test_zero_rate():
    assert discount(100, 0) == 100.0

def test_invalid_price():
    with pytest.raises(ValueError):
        discount(-10, 0.1)

def test_invalid_rate():
    with pytest.raises(ValueError):
        discount(100, 1.5)
跑一下验证:
pytest test_calc.py -q上面这段做的是用四组用例覆盖正常、边界和异常三种情况。执行后你应该看到 4 个测试全部通过。这种方式的代价是:你仍要 review 断言是否真的戳中了关键逻辑,而不是只验证了“函数能跑完”。
三、方案二:用对话式大模型按提示词产出
没有内置 AI 助手的编辑器,也能用 Claude Code 编程技能教程 这类对话工具,把函数和测试约定贴进提示词,让它产出完整测试文件。关键在于提示词要写清“测试框架、待测函数、覆盖要求”三件事。
一个能稳定出活的提示词结构:
请用 pytest 为下面这个函数写单元测试:
1. 覆盖正常输入、空值、极值、异常四类;
2. 每个测试只断言一个行为;
3. 异常用例用 pytest.raises;
4. 给出可直接运行的 test_xxx.py。
函数源码:<粘贴 discount 函数>
💡 小提示:把“项目里已有的一个测试文件”也贴给模型当样例,它能模仿你们的命名和目录风格,生成的代码几乎不用改就能合进仓库。
这种方式的取舍在于:上下文给得越细,产出越贴身;但你要手动把代码粘来粘去,不适合批量补测。它更适合一次性的复杂函数,或你手边没有 AI 编辑器插件的情况。
四、方案三与横向对比
第三种做法是在 CI 流程里接入自动化测试生成,让每轮提交都自动补一批回归测试。它通常配合 软件测试教程 里的测试分层思想,把单测、集成、端到端分开管理。接入后,新函数合并前会先跑一轮 AI 生成的测试,保证不退化。
| 做法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| 编辑器内助手 | 日常开发、就地补测 | 零上下文搬运、最顺手 | 依赖编辑器能力 |
| 对话式提示词 | 无插件、复杂函数 | 任意环境可用 | 手动粘贴、难批量 |
| CI 自动生成 | 团队、回归防护 | 持续兜底、防退化 | 接入成本、需审结果 |
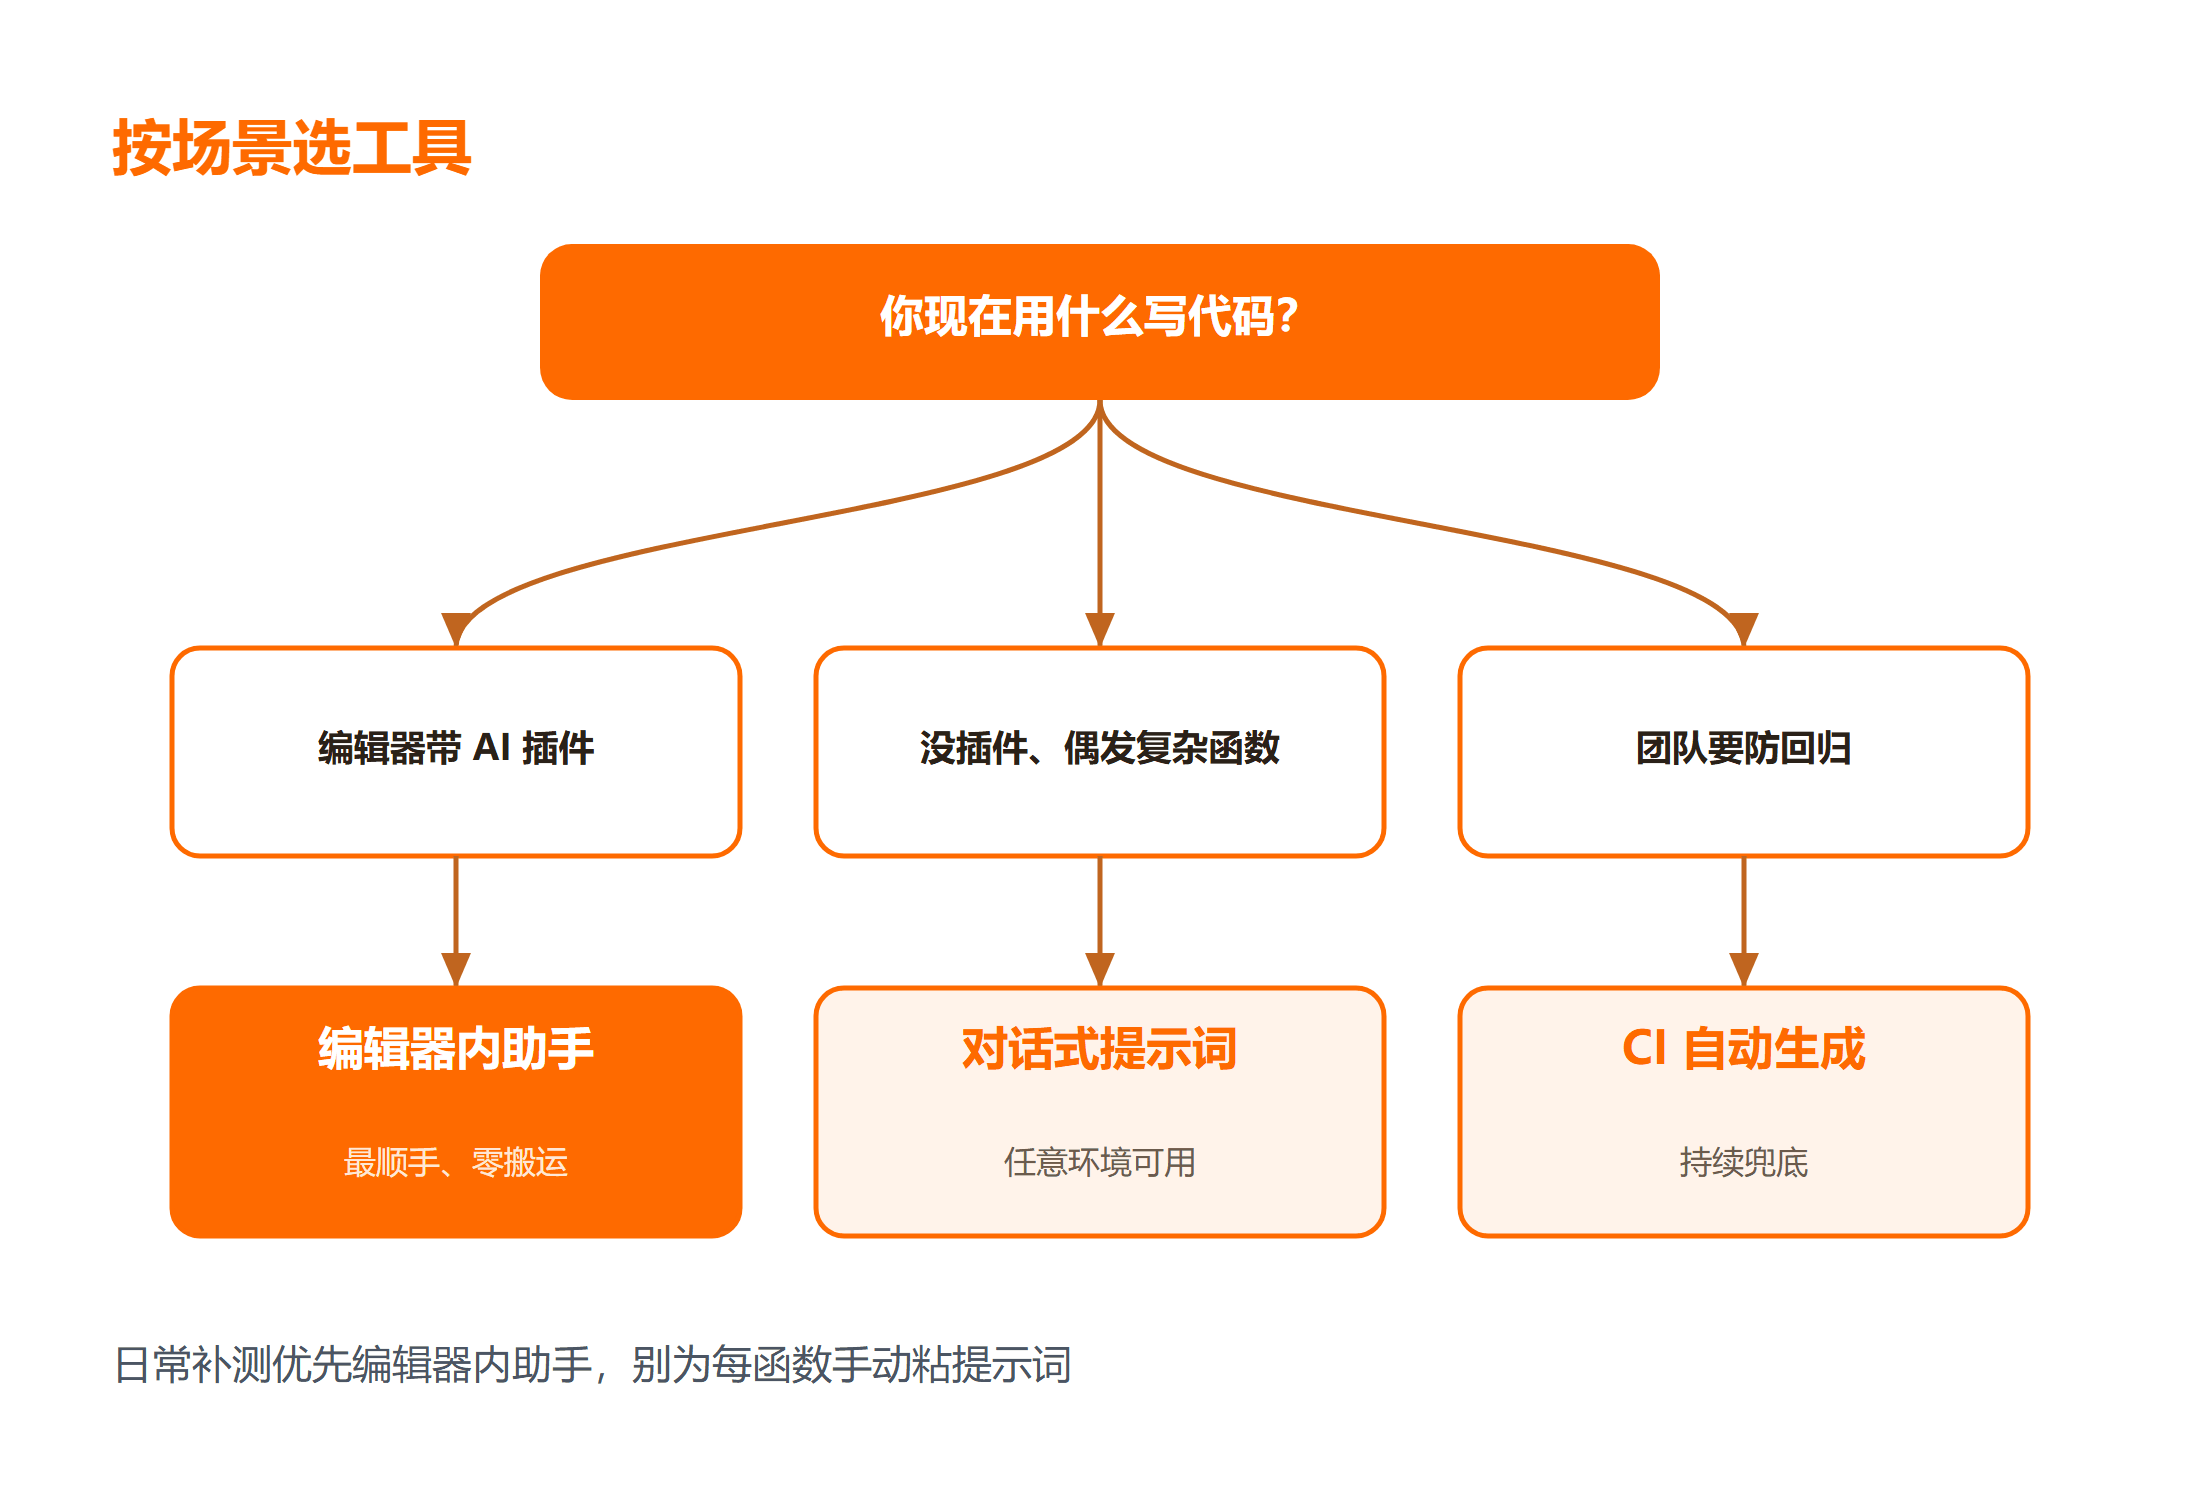
选型建议:个人小项目用方案一最省事;临时给某个难测函数补用例用方案二;团队想长期防回归再上方案三。无论哪种,Codex 插件 这类能力都能缩短从“函数写完”到“测试就绪”的距离,前提是你要审一遍生成结果。
五、踩坑清单
把读者最容易卡住的三点列出来,每个给现象、原因、解法。
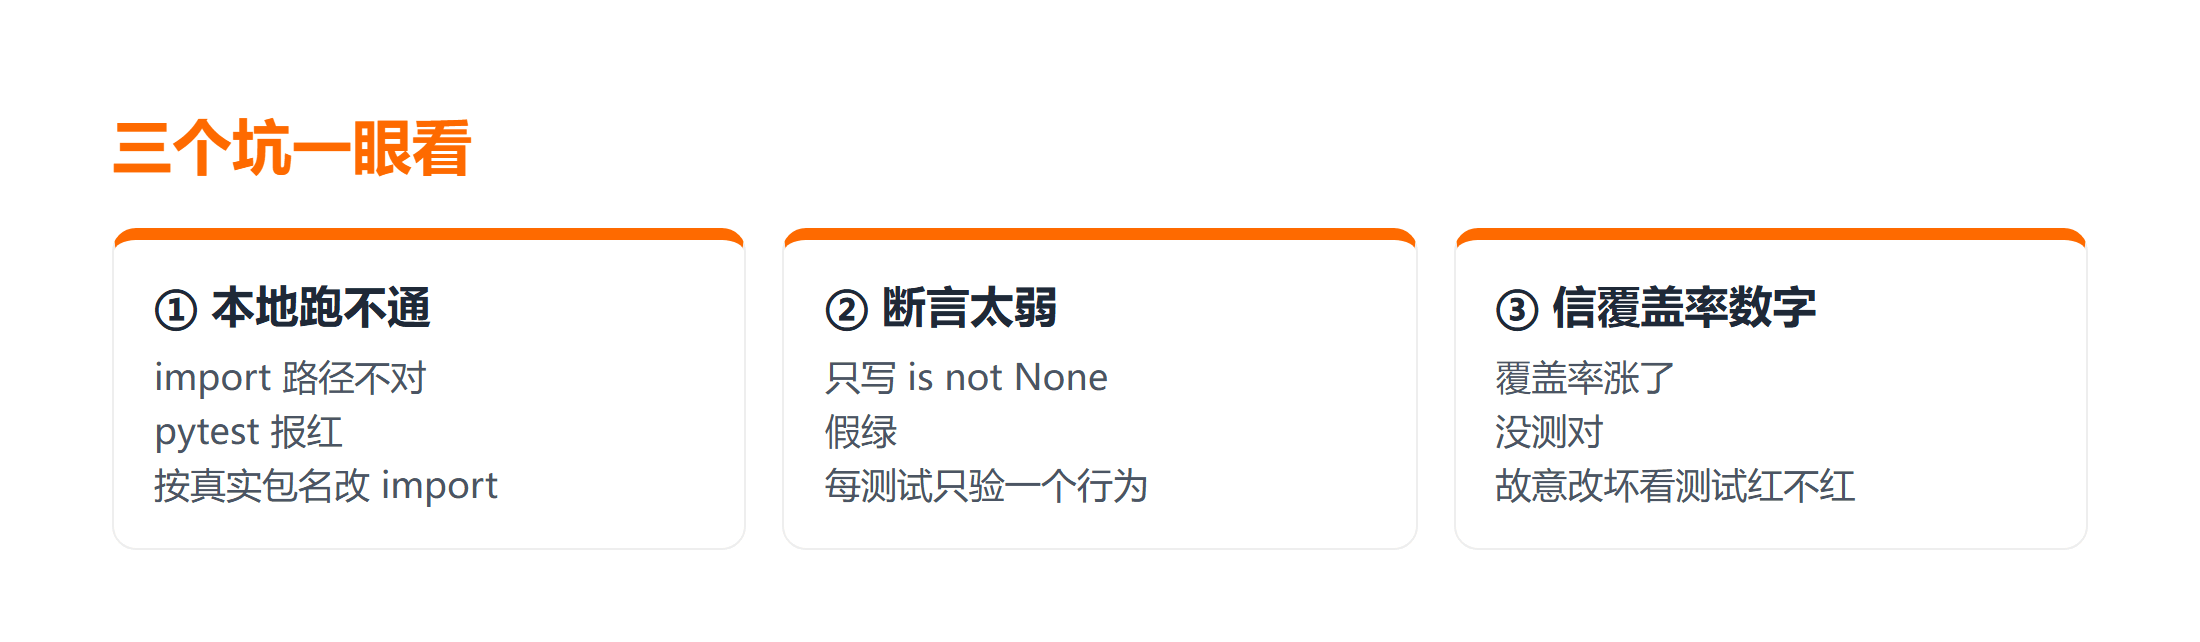
坑一:生成了但本地跑不通。 现象是 pytest 报 import 错误或路径找不到。原因通常是 AI 按通用结构写了 from src.xxx import,而你的包名不同。解决法是让它按你真实的项目结构生成,或手动把 import 改成本地可解析的路径。
坑二:断言太弱。 比如只写了 assert result is not None,函数抛错也能过。解决法是要求“每个测试只验证一个明确行为”,并把关键返回值写进断言。
坑三:直接信任覆盖率数字。 覆盖率涨了不代表测对了。解决法是盯着失败分支:故意改坏一个实现,看测试会不会红,红了才说明它真在守门。
总结
AI 生成单元测试的核心不是“让模型替你思考”,而是把最机械的用例骨架交给它,你把精力放在 review 关键断言上。三种做法里,编辑器内助手最顺手,对话式提示词最灵活,CI 自动生成最稳长期。无论选哪条,都要本地跑一遍、断言要戳中行为、别被覆盖率数字骗了。
要点带走:
- AI 生成只是起点,跑起来并审断言才算数;
- 提示词写清框架、函数、覆盖要求,产出才贴身;
- 覆盖率红不红,比覆盖率数字高不高更重要。
下一步可以把生成测试纳入提交前检查,让回归防护变成习惯。
延伸学习
想把这块系统补齐,可以按这个顺序来:
- 先过一遍 TRAE AI 开发 Python Django 后台管理系统,看 AI 助手怎么贯穿真实项目;
- 语法和断言记不住时,翻 SQL 模糊查询到底有哪几种?三种方式一次讲清 这类笔记找思路;
- 想画清楚测试流程,用 Mermaid流程图 把用例链路画出来。
常见问题
Q:AI 生成的测试能直接合并进主干吗? A:不建议直接合。先本地跑通,再人工确认断言戳中了关键行为,最后才并入,避免“假绿”测试混进仓库。
Q:函数依赖数据库,AI 生成的测试怎么处理? A:让模型用 mock 或 fixture 把外部依赖替掉,只测函数自身逻辑;千万别在单测里真连库,否则又慢又不稳定。
Q:提示词要写到多细才够? A:至少给三样:测试框架、待测函数源码、覆盖要求(正常/边界/异常)。再贴一个项目里现成的测试样例,产出基本能直接用。



