 TRAE-AI编程

不用每个都追:普通开发者按"任务适配"选模型,比按"版本号新旧"选模型划算得多。刚过去的 9 月堪称 AI 模型的发布会旺季:据公开报道,OpenAI 发布了主打计算机操作与安全能力的 GPT-6 Astra,Anthropic 推出价格更友好的 Claude Fable 5.1,Google 更新了主打速度的 Gemini 3.8 Flash,Meta 也发布了面向编码与 Agent 工作流的 Muse Spark 1.3。圈子里天天有"又变了"的声音,但真正决定你该不该升级的,从来不是榜单分数,而是你的任务类型、成本预算和迁移成本。本文把这些更新拆成一张决策表、一笔成本账和一套最小验证流程,零基础也能照着做。
一、先看结论:要不要追新,一张表定
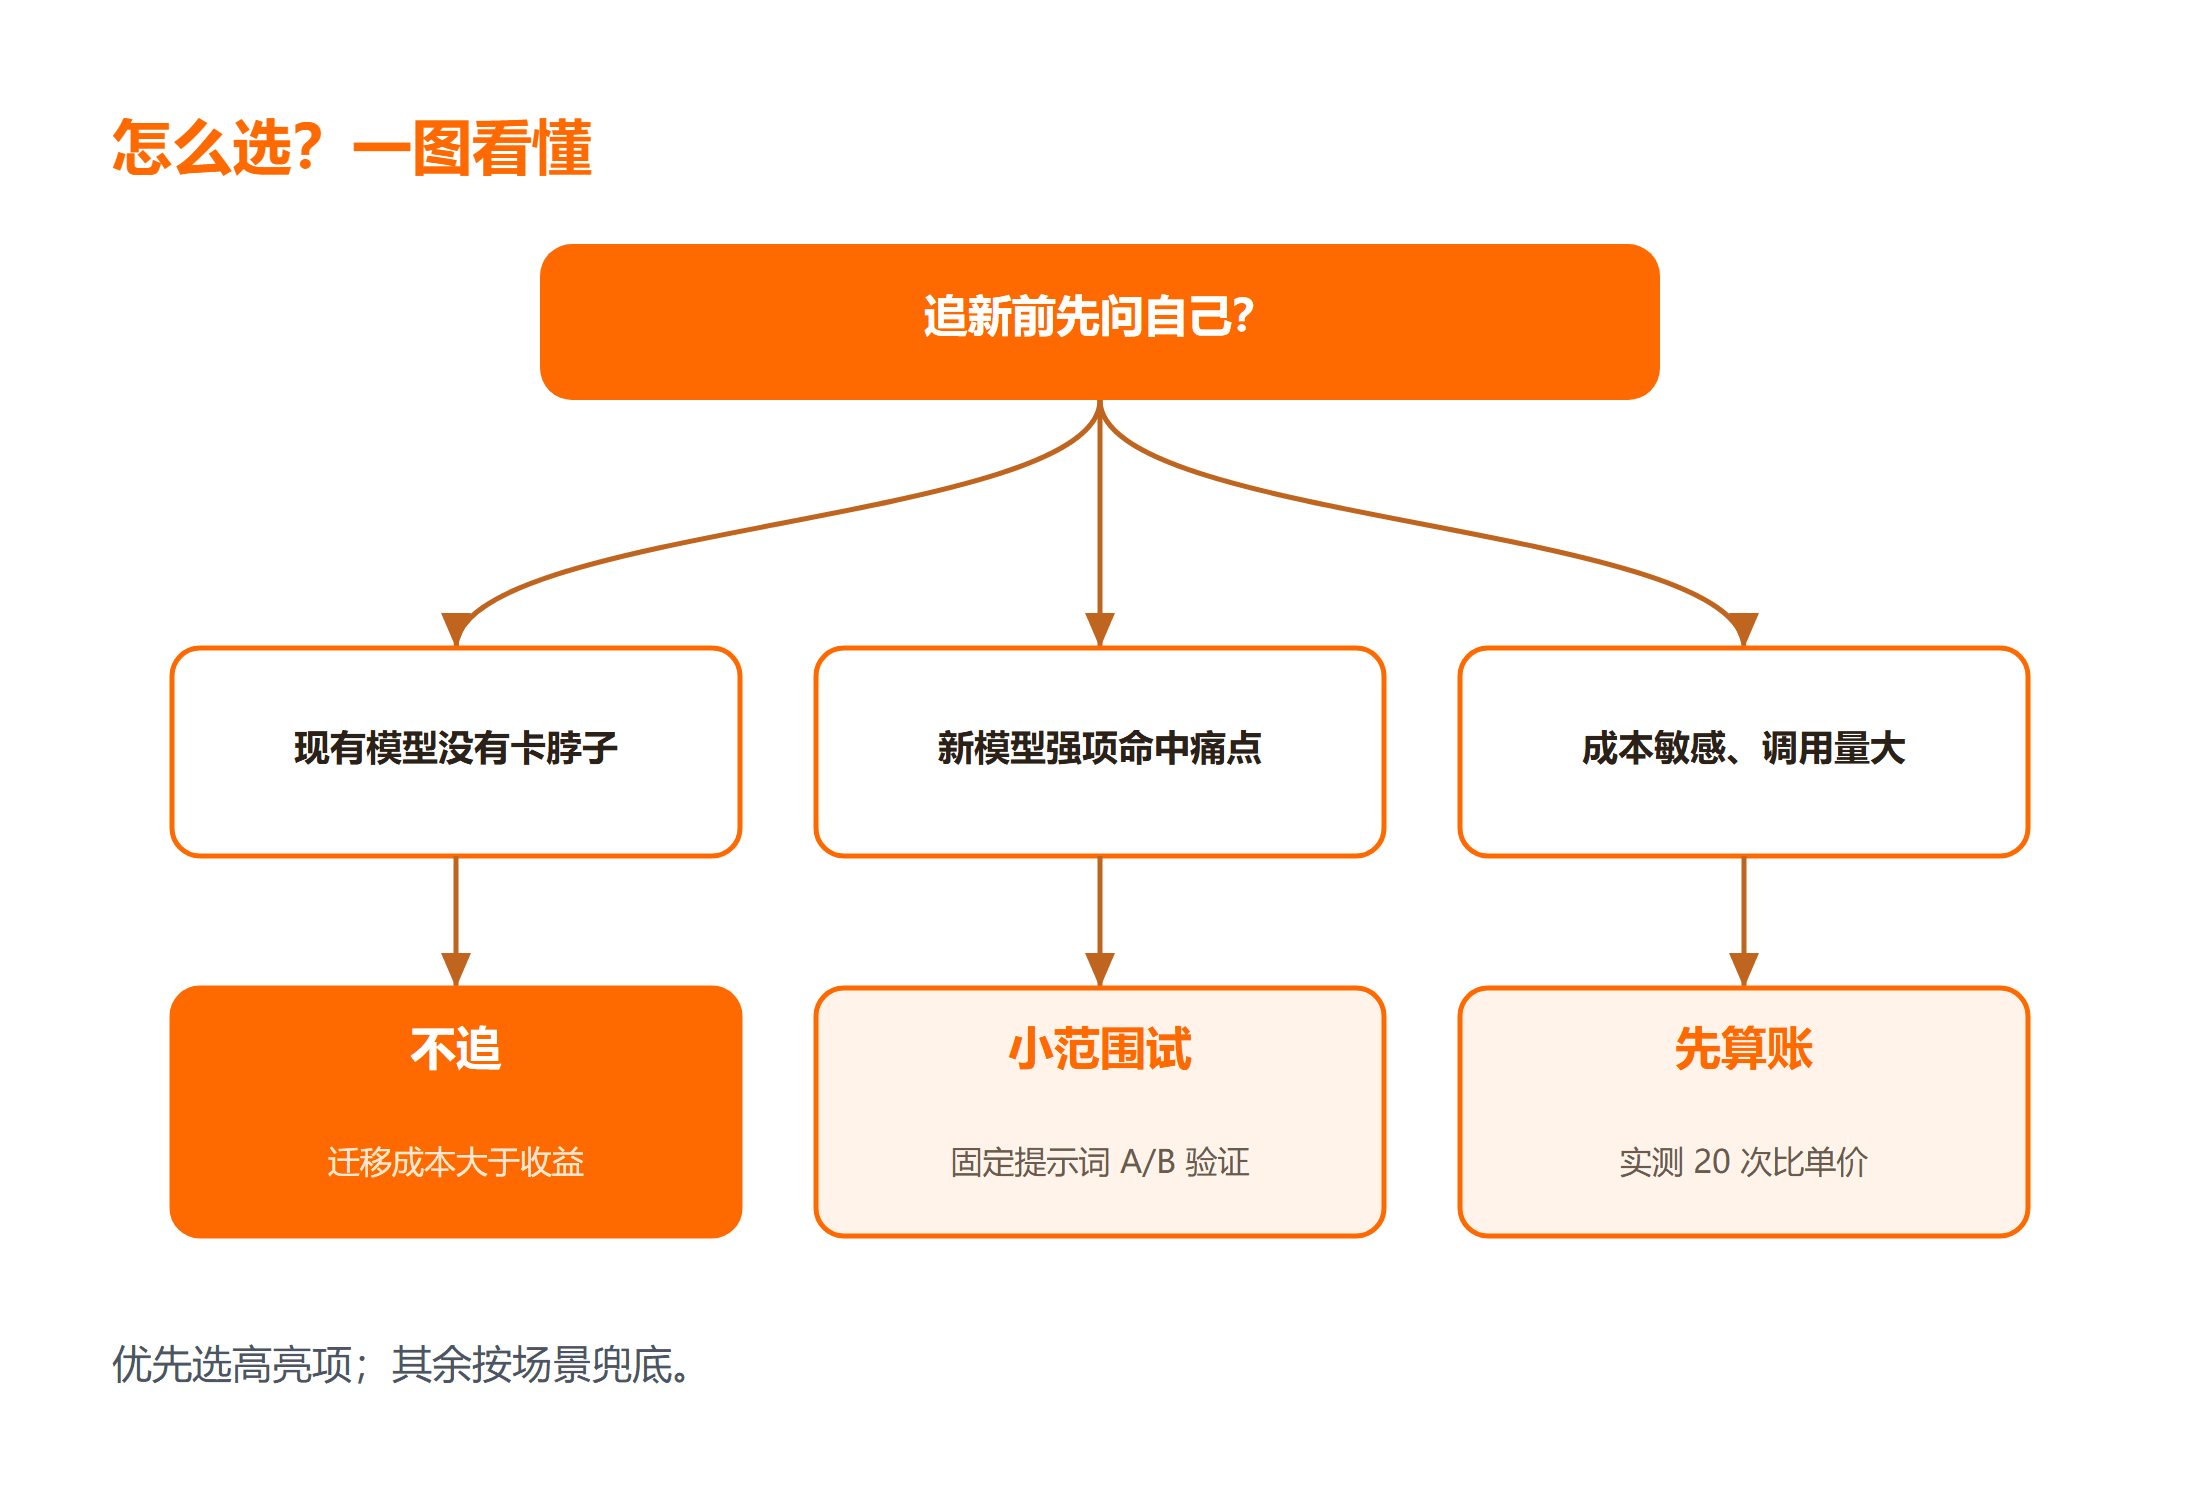
先说结论:日常学习和小项目留在现有模型上,等稳定再换;只有当新模型的强项正好命中你的痛点时,才值得第一时间切换。
| 你的情况 | 建议 | 理由 |
|---|---|---|
| 学习中,用免费或学生额度 | 不追 | 新模型优势用不上,切换纯增加学习成本 |
| 现有模型没有卡脖子问题 | 不追 | 迁移成本大于收益 |
| 长任务经常超时、上下文丢失 | 可以试 | 新一代主打长会话与上下文管理 |
| 成本敏感、调用量大 | 对比后换 | 新版普遍降价,按账单实测再定 |
| 做安全审计、自动化操作类工作 | 值得评估 | GPT-6 Astra 类更新正对这些场景 |
决策顺序是先看任务、再看账单、最后才看跑分。跑分是厂商在理想条件下测的,和你的真实仓库、真实提示词没有必然关系。
二、这个 9 月都更新了什么:3 分钟看懂
把公开报道里的关键信息压缩成一张清单,方便对号入座(具体数字为厂商口径,实测请以自己业务为准):
- GPT-6 Astra(OpenAI,9 月初):主打计算机操作与网络安全能力,自动化任务完成率和终端任务跑分都有提升;API 定价每百万输入约 10 美元、输出约 50 美元,属于明显的"能力涨价"档。
- Claude Fable 5.1(Anthropic,9 月 1 日):主打编码与知识工作,典型工作负载价格估计比上代低约 25%,Agent 类高缓存任务降幅更大,是"降价走量"档。
- Gemini 3.8 Flash(Google,9 月第一周):围绕推理速度与免费档延迟优化,适合面向用户的高频调用场景。
- Muse Spark 1.3(Meta,9 月第一周):工具调用次数与 token 消耗比上代减少约两成,并在模糊指令下会先反问确认。
看懂节奏比记住参数更重要:现在头部厂商的更新周期已经压缩到"周"级,任何具体版本都会很快被下一次更新覆盖。因此本文教的是可复用的选型方法,而不是某个版本的评测结论。想补齐大模型基础概念,可以先过一遍 AI 人工智能教程。
三、追新前先算成本:Token 与 API 账单
AI 模型最容易被忽略的成本是 Token 计费结构的差异:有的版本单价降了但输出变长,总价反而更高。动手切换前,先用一段小脚本实测你真实任务的消耗(示例基于 OpenAI 兼容接口,未在本机执行,价格以官方定价页为准):
# 用最小请求实测新模型的单次任务成本
from openai import OpenAI

client = OpenAI(api_key="你的密钥")  # 密钥放环境变量更安全,此处为演示

resp = client.chat.completions.create(
    model="gpt-6-astra",          # 换成你要试的新模型名
    messages=[
        {"role": "system", "content": "你是代码审查助手,只输出要点。"},
        {"role": "user", "content": open("demo.py", encoding="utf-8").read()},
    ],
)

# 检查返回内容是否符合预期
print(resp.choices[0].message.content[:200])

# 打印本次消耗,用于和旧模型对比账单
print("输入 tokens:", resp.usage.prompt_tokens)
print("输出 tokens:", resp.usage.completion_tokens)
跑完把新旧两版模型各执行 20 次同样的真实任务,对比三项数据:单次 tokens、输出质量、失败重试次数。单次更便宜不等于总账单更便宜,输出啰嗦的新模型可能反而更贵。API 调用的基础写法,站内的 OpenAI API 教程 有更完整的示例。另外提醒一句:Token 是 AI 时代的新计量单位,理解它才能看懂账单,相关概念见延伸区的笔记。
四、怎么验证新模型对你有没有用:最小验证流程
不要拿跑分验证,要拿你自己的任务验证。一套 30 分钟能跑完的最小流程:
- 选 5 个真实任务:从你最近的工作里挑 5 个有标准答案的任务,比如修一个已知 bug、写一个工具函数。
- 固定提示词 A/B 跑:同一份提示词分别发给新旧模型,提示词质量决定结论可信度,写法可参考 GPT5 提示词教程。
- 按验收标准打分:每个结果按"一次通过 / 需要修改 / 失败"三档记录,运行结果要实际检查而不是目测。
- 算总账:汇总成功率与 token 消耗,只有"成功率更高且成本可接受"才值得切换。
- 小范围灰度:先在个人项目切换一两周,确认稳定再动生产环境。
整个流程的关键动作是固定变量:任务相同、提示词相同、验收标准相同,唯一变量才是模型。这样得出的结论才能指导决策,而不是被单次惊艳案例带偏。生成式 AI 的能力边界与适用场景,生成式 AI 教程 里有系统性梳理。
五、常见失败与排查
追新过程中最常见的失败集中在三类:输出不符合预期、上下文超限、成本失控。对照排查:
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| AI 模型输出反而变差 | 提示词按旧模型习惯写的 | 按新模型文档调整提示词,重跑 A/B |
| 长文档报上下文超限 | 上下文窗口配额或分段不合理 | 检查窗口上限,改成分块处理 |
| 账单比预期翻倍 | 输出长度增加或重试过多 | 设置输出上限,失败先查参数再重试 |
| 结构化输出解析失败 | JSON 格式不稳定 | 用官方结构化输出参数,加解析容错 |
| 工具链报模型不存在 | 旧模型标识被下线 | 按厂商迁移公告更新配置里的模型名 |
特别提醒最后一条:这轮更新周期里已有平台下线旧模型标识,如果你的自动化脚本写死了模型名,升级后第一次运行就会失败。把模型名放进配置文件而不是写死在代码里,是成本之外另一笔该提前算的账。
总结
回顾全文:9 月的 AI 模型扎堆更新改变了"参数",但没有改变选型方法——先按决策表定位自己的情况,再算真实任务的 token 账单,最后用固定的最小验证流程实测成功率。GPT-6 Astra 的能力跃升、Claude Fable 5.1 的降价、Gemini 3.8 Flash 的提速,都只是这条流程里的待验证选项。对普通开发者来说,学会验证,比追上每一个版本重要得多。下次再有"重磅发布"刷屏,你只需要打开本文第四节,30 分钟就能得到属于自己的答案。
延伸学习
- 配套课程:Python 机器学习 AI 路线(想从"用模型"进阶到"懂模型"从这里开始)
- 相关笔记:免费试遍主流大模型(追新前先免费横向试一轮,省下试错成本)
- 概念笔记:词元是什么(看懂 token,才算看懂账单)
常见问题
Q:不追新会不会很快被淘汰?
A:不会。模型能力是一层层叠加的,基础教程和经典任务在旧模型上完成度已经很高。把精力放在验证方法和工程能力上,比抢首发更有长期价值。
Q:免费用户有必要关注这些更新吗?
A:有必要,但不用行动。免费档通常滞后一到两个版本,等新能力下放到免费额度再切换,正好避开首批的稳定性问题。
Q:怎么第一时间知道模型更新和下线信息?
A:关注你所用平台的发布公告与定价页,自动化脚本里的模型名放配置文件。更新日志类信息以官方渠道为准,社区转述常有延迟和偏差。