TRAE-AI编程

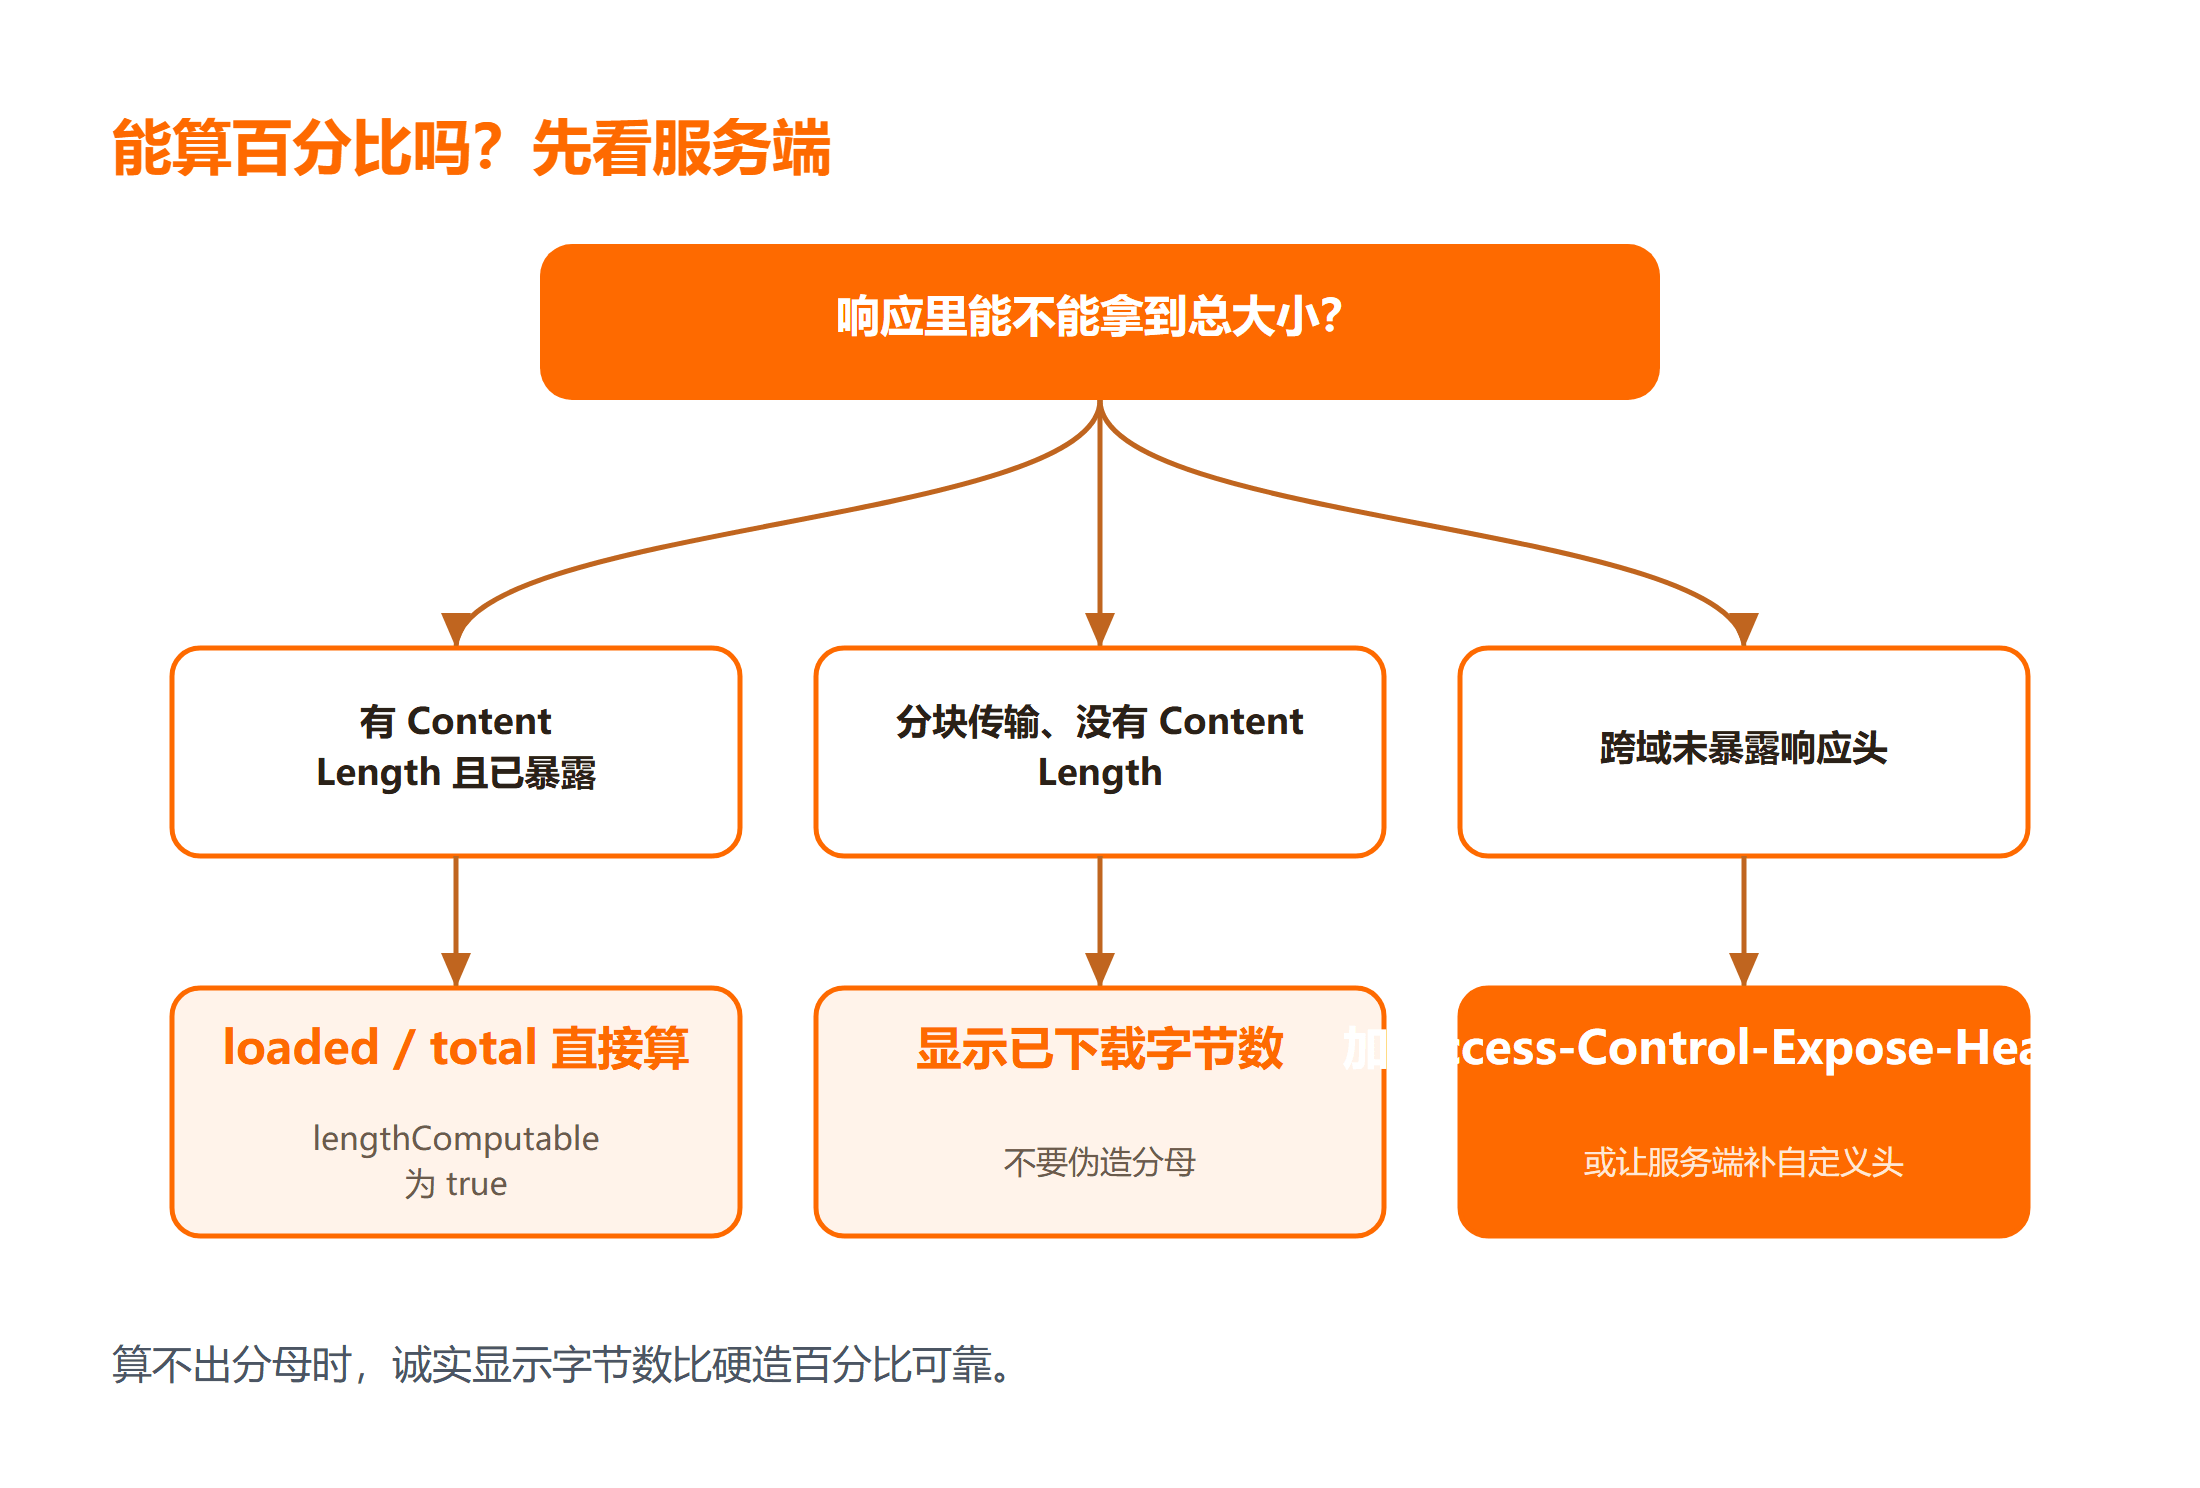
能拿到,但前提说在前面:百分比不是一个「读出来」的值,而是「已接收字节数 ÷ 总字节数」算出来的。所以只要服务端没有给出总大小——响应头里没有 Content-Length,或者跨域时没把它暴露出来——浏览器就只能告诉你已经收了多少兆,算不出分母,百分比自然无从下手。本文给出前端监听下载进度的三种取法:XMLHttpRequest 的 progress 事件最省事,fetch 配 ReadableStream 最通用,服务端补一个自定义总大小头最可靠。适用边界一并写清:超过几百兆的文件不该用 JS 拼 Blob,也不该期待每种服务端都能给出准确分母。
先看结论
| 取法 | 依赖什么 | 能拿到百分比吗 | 适合场景 |
|---|---|---|---|
| XMLHttpRequest 的 progress | 响应头给出 Content-Length | 能,但要判 lengthComputable | 常规文件下载、最快落地 |
| fetch + ReadableStream | Response.body 可用 | 有分母才能算,否则只给字节数 | 需要自己控 SIZE、取消、解压后的处理 |
| 服务端补自定义总大小头 | 后端配合暴露响应头 | 能,且最准确 | 流式压缩、分片包加速器场景 |
一句话总结:能算下载进度百分比就显示百分比,拿不到分母就诚实地显示已下载字节数,不要为了好看去伪造分母。下面三种取法按「改动成本从小到大」排列,实际项目里经常组合使用。
一、先搞清楚百分比的分母从哪来
浏览器下载文件时,服务端返回 Content-Length 表示本次响应体的字节数,这就是分母。分子是浏览器已经收到的字节数,前端通过事件拿到。
三个必须先确认的前提:
- 服务端用的是不是分块传输(Transfer-Encoding: chunked)。分块传输时通常没有 Content-Length,此时前端事件里的 total 为 0、lengthComputable 为 false。
- 响应有没有被 gzip 或 br 压缩。压缩之后 Content-Length 记的是压缩后的字节数,浏览器收到的也是压缩后的字节,两者对得上,但和文件解压后的真实大小不是一回事。这也是为什么有的人会发现「进度到 100% 了,文件大小却比预期小」。
- 是不是跨域请求。跨域时响应头默认只对少数几个简单响应头可见,Content-Length 必须靠服务端返回
Access-Control-Expose-Headers: Content-Length才会出现在前端可读列表里。
这三个前提对应的知识在 HTTP 教程 里有更系统的说明,尤其是响应头那一节。想不通为什么前端读不到某个响应头,先回到这里看跨域那一条。三个前提里只要有一个不成立,下载进度就只能退化成字节数显示。
二、第一种写法:XMLHttpRequest 的 progress 事件
这是最简单的一条路,浏览器原生支持,兼容性也最好。想监听下载进度,只需要给 XHR 挂一个 progress 回调:
function downloadWithProgress(url, onPercent) {
  return new Promise((resolve, reject) => {
    const xhr = new XMLHttpRequest();
    xhr.open("GET", url);
    xhr.responseType = "blob";
    xhr.onprogress = (e) => {
      if (e.lengthComputable && e.total > 0) {
        onPercent(Math.round((e.loaded / e.total) * 100));
      } else {
        onPercent(null, e.loaded);
      }
    };
    xhr.onload = () => {
      if (xhr.status >= 200 && xhr.status < 300) resolve(xhr.response);
      else reject(new Error("服务端返回 " + xhr.status));
    };
    xhr.onerror = () => reject(new Error("网络中断"));
    xhr.send();
  });
}
预期结果:下载过程中 onPercent 被反复调用,参数从 1 递增到 100;下载完成后 Promise 兑现为 Blob 对象。
失败分支要写清楚。第一,e.lengthComputable 为 false 时不要硬算,否则会得到 Infinity 或 0%;上面的写法用 null 表示「没有百分比」,同时把已下载字节数交给界面显示。第二,xhr.status 非 2xx 时 xhr.response 可能是服务端返回的错误体(比如一段 JSON),此时要按失败处理而不是当成文件。第三,想中途取消就调用 xhr.abort(),它会触发 onerror 分支,界面上要能区分「用户取消」和「网络错误」。
拿到 Blob 之后再把落盘动作补上:
function saveBlob(blob, filename) {
  const href = URL.createObjectURL(blob);
  const a = document.createElement("a");
  a.href = href;
  a.download = filename;
  document.body.appendChild(a);
  a.click();
  a.remove();
  setTimeout(() => URL.revokeObjectURL(href), 0);
}
注意 revokeObjectURL 不能在 click 之前调用,否则下载会拿不到内容,这也是新手最常踩的一处。
三、第二种写法:fetch 配 ReadableStream 自己累计
用 XMLHttpRequest 的好处是事件现成,代价是不太好接现代流式处理。想自己控速、想顺便做校验,又想继续拿到下载进度,就得上 fetch 的 Response.body:
async function downloadByStream(url, onUpdate) {
  const res = await fetch(url);
  if (!res.ok) throw new Error("服务端返回 " + res.status);
  if (!res.body) throw new Error("当前环境不支持流式读取");

  const total = Number(res.headers.get("Content-Length")) || 0;
  const reader = res.body.getReader();
  const chunks = [];
  let received = 0;

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    chunks.push(value);
    received += value.byteLength;
    onUpdate(total ? Math.round((received / total) * 100) : null, received, total);
  }

  return new Blob(chunks, { type: res.headers.get("Content-Type") || "" });
}
预期结果:每读到一个分块就回调一次,回调非常密集,界面上应当做降频处理(比如每 200 毫秒更新一次)再渲染,避免频繁重排把主线程拖住。
这段代码用到了 Promise 与异步迭代的基础,需要补的话可以看 JavaScript 教程 的异步章节。
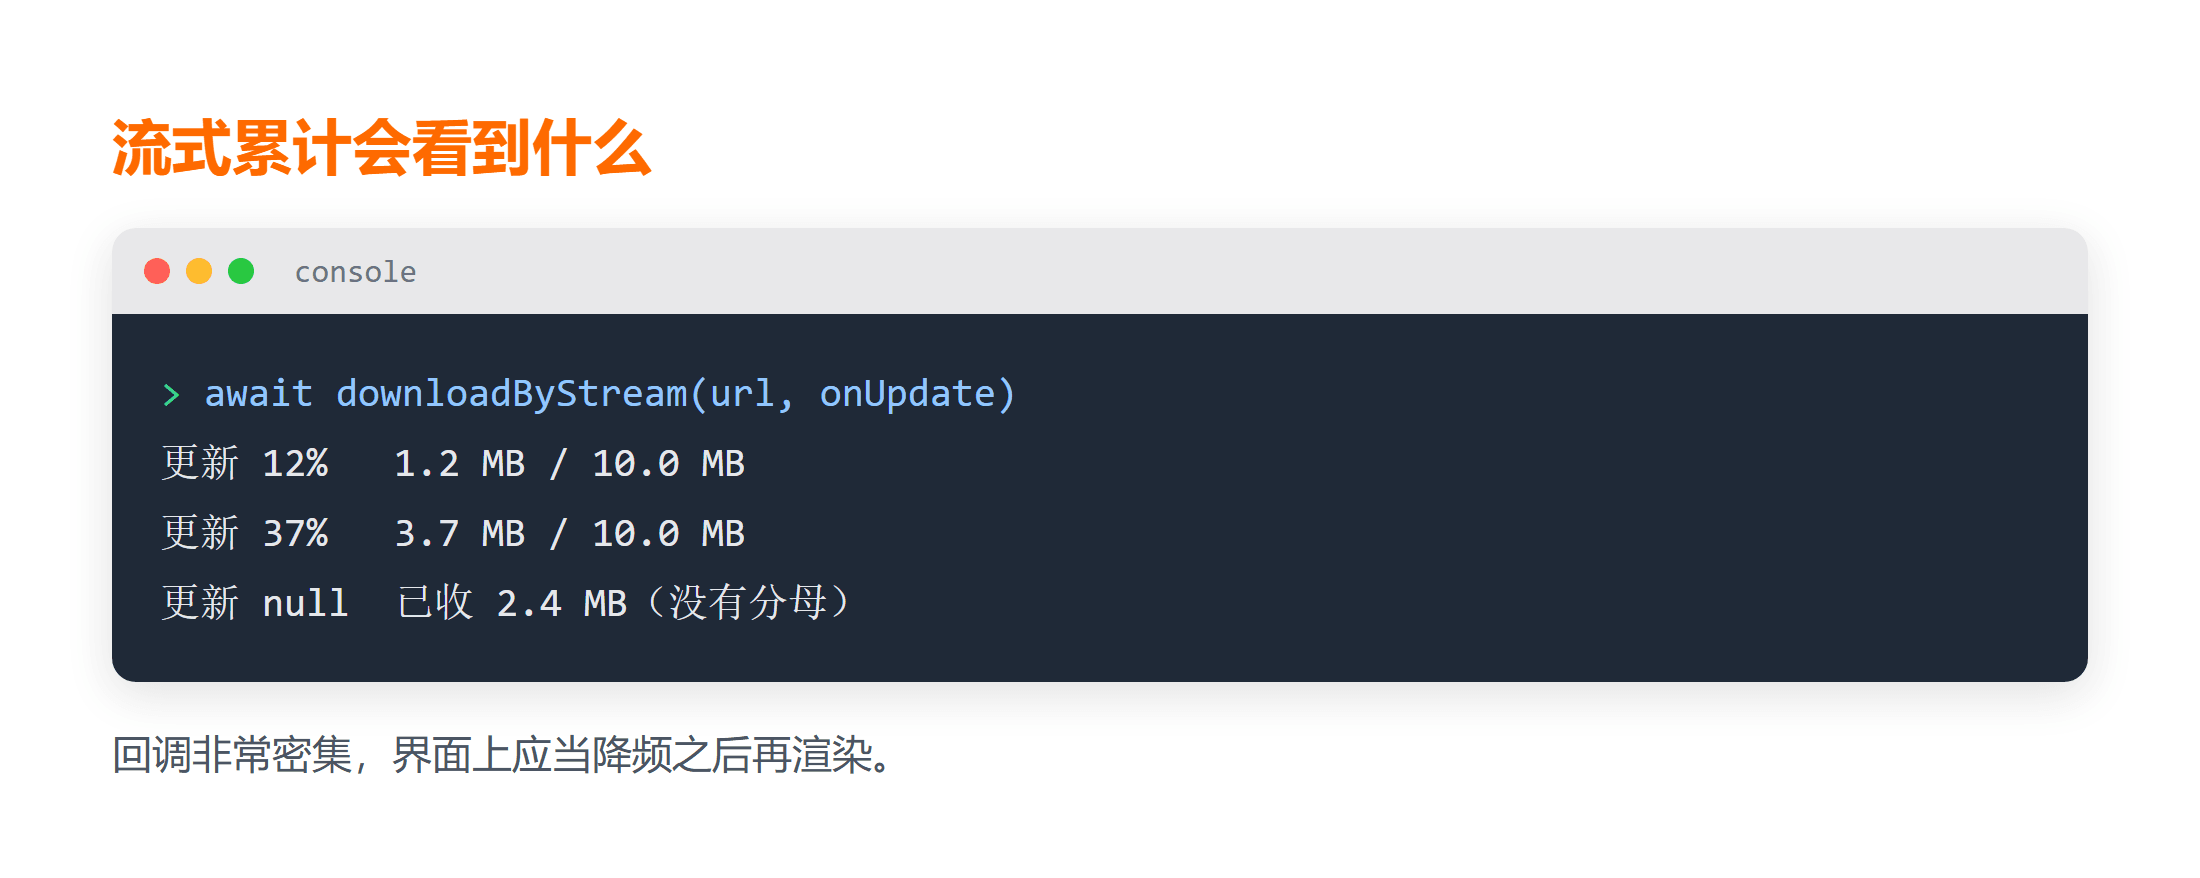
失败分支:res.body 在某些老环境里是 null,必须显式判并给出提示;Content-Length 读不到时 total 为 0,此时退化为显示字节数。还有一种容易忽略的情况——服务端是分块传输且不压缩时,响应体大小未知,估算不准的问题不是前端能解决的,得回到第四节的方案。
四、第三种做法:让服务端把分母递过来
如果下载链路中间经过了自己的网关,最稳的做法是让网关或后端额外返回一个自定义头,比如 X-File-Size,并在跨域时把它列进 Access-Control-Expose-Headers。想在本地把这一套跑通,可以先跟着 Node.js 教程 起一个最小的静态服务。服务端用 Node 写起来也就几行:
const express = require("express");
const fs = require("fs");
const app = express();

app.get("/download/:name", (req, res) => {
  const path = "./files/" + req.params.name;
  const stat = fs.statSync(path);
  res.setHeader("Content-Length", stat.size);
  res.setHeader("Access-Control-Expose-Headers", "Content-Length, X-File-Size");
  res.setHeader("X-File-Size", stat.size);
  fs.createReadStream(path).pipe(res);
});
预期结果:前端拿到的响应头里同时有 Content-Length 与 X-File-Size,两者一致。实践中的注意点是:为了传输效率开启 gzip 之后,Content-Length 会变成压缩后的大小,而 X-File-Size 保留的是原文件大小——此时应该拿 X-File-Size 当分母,并把 XHR 收到的 loaded 视为压缩字节数,两者相除会产生偏差,所以 gzip 场景下最诚实的做法是显示字节数而不是百分比。这段 Node 代码是口径说明,未在本机执行。
服务端在 Nginx 一侧也可以通过反向代理与静态资源配置影响这些响应头,相关写法在 Nginx 入门指南 里能查到,尤其是静态资源的 etag 与 gzip 配置那一节。最后补一句成本提醒:为了算百分比而额外发一次 HEAD 请求是常见的兜底做法,但会给每一次下载多加一次往返,做之前先算一下值不值。
动手核对清单
- 前置:准备任意一个本地静态服务(本机打算提供 http 与静态文件即可),放一个几十兆的文件进去用于测试。
- 命令:启动服务后记录它的地址,把浏览器开发者工具的网络面板打开。
- 运行:分别用第二、三节的两段代码各下载一次,观察回调参数。
- 检查:网络面板里确认响应头包含 Content-Length,界面上的数字能爬到 100。
- 预期:有 Content-Length 时百分比从 1 递增到 100;删掉该响应头后百分比为 null,只显示已下载字节数。
- 失败:百分比一直停在 0 或界面报错,多数是跨域未暴露该响应头,修复方式是在服务端加上
Access-Control-Expose-Headers。 - 验证:把服务端的压缩开关打开再跑一次,确认百分比行为仍然符合预期,至此才算闭环。
以上为本机的常规操作流程,未在本文写作环境实际执行,输出为预期结果。
总结
- 下载进度百分比 = 已接收字节 ÷ 总字节,缺了分母就寸步难行。
- 简单场景用 XMLHttpRequest 的 progress,判 lengthComputable,异常分支单独处理。
- 需要更细控制时用 fetch 配 ReadableStream 自己累计,别忘判 res.body 是否存在。
- Content-Length 缺失或经过压缩时,让服务端补一个自定义总大小头,界面上诚实显示字节数。
- 超过几百兆的文件不要拼 Blob,直接交给浏览器原生下载更稳。
常见问题
Q:lengthComputable 一直是 false,一定是服务端没给 Content-Length 吗?
不一定,还有两种常见情况:请求跨域但服务端没有用 Access-Control-Expose-Headers 暴露该头,以及请求 mode 为 no-cors 导致前端连响应头都读不到。下载进度算不出百分比时先看这两处,往往比重写代码更快见效。跨域报文本身的含义与排查顺序,可以展开读 跨域常见报错解读 这条笔记。验证办法是打开浏览器开发者工具的网络面板,直接看响应头列表里有没有这一项。
Q:进度条走到 100% 之后为什么还要等很久?
因为 100% 只代表字节接收完毕,后面还有拼接 Blob、写临时文件、触发保存 dialog 这几步。大文件尤其明显。解决办法是把文案写成「接收完成,正在生成文件」,而不是停在「下载中 100%」。
Q:能不能用这种方式断点续传?
单独的前端做不到。续传依赖服务端支持 Range 请求头,前端只负责在请求头里带上 Range: bytes=xxx-,并且要把已下载的分片和剩余部分重新拼接。本文的三种写法都解决不了服务端的 Range 支持问题。
延伸学习
- Web前端入门扫盲课程:把请求、响应、资源加载这条链路补齐的配套课程,遇到奇怪的网络现象可以跟一遍。
- Blob文件下载怎么实现:专门讲 HTML5 里 Blob 下载的一条笔记,和第二节的落盘写法正好对上。
- Web 标准详解:把响应头、请求方法这些属于 Web 标准的约定放在一条线上理解,读本文第一节会轻松很多。