 TRAE-AI编程

用 LLM 做爬虫页面通用解析,最稳的做法不是把整页 HTML 直接丢给模型,而是先用 CSS 选择器把正文区域切出来,再把清洗后的纯文本交给模型,让它按你给定的 JSON 结构输出字段。整页 HTML 里的 script、样式、导航栏会挤占上下文,还会让模型把无关链接当成正文。
不少人一上来就想写"一个提示词解析所有网站"的爬虫通用解析方案,结果在分页、登录墙、动态渲染这三道坎上反复翻车。真正的通用性不来自提示词写得多花哨,而来自三件事:结构化的输入、受限的输出、可校验的字段。输入越干净,模型出错的概率越低。
本文给一条可以照着跑的路径:最小可运行示例、三种解析策略的取舍、四个高频失败分支的修复办法,以及一份能直接打印出来的输入输出验证清单。示例用 Python 演示,思路换到别的语言也一样成立。
先看结论
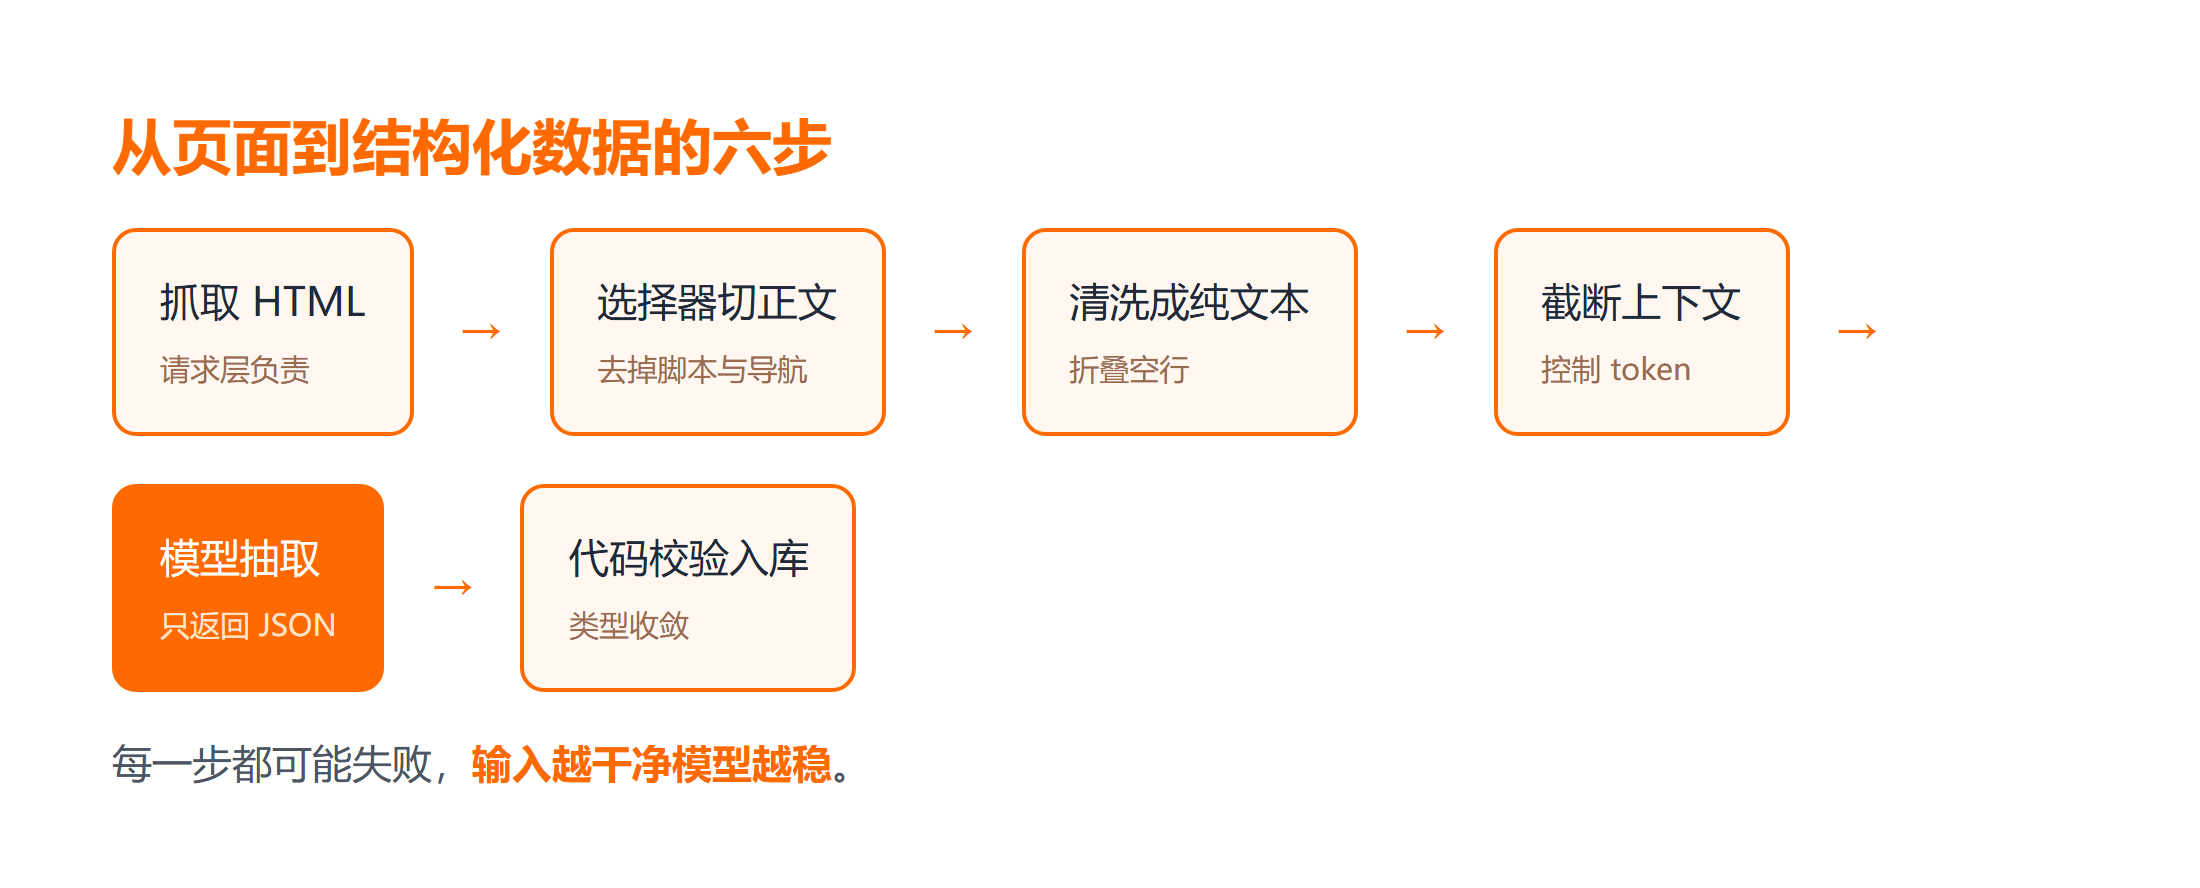
爬虫通用解析的落点是"半自动":用代码解决确定性问题(取哪块、翻几页、怎么存),用模型解决不确定性问题(字段在哪、怎么归一)。让模型去做它本该做的抽取与归一化,不要让模型去做请求调度。
一句话顺序:抓 HTML → 用 CSS 选择器切出正文块 → 清洗成纯文本 → 截断到模型上下文以内 → 要求模型只返回 JSON → 用代码校验字段后再入库。
抓取这一步如果还不熟,可以先看 requests 爬虫教程 把请求与响应对象理顺,再回来看抽取这部分。
一、最小场景与预期行为
做爬虫通用解析之前,先把任务收敛到一个能验证的小问题:给定一个商品详情页,抽标题、价格、品牌、上架时间四个字段,输出一行 JSON。
输入是一段已经清洗过的正文文本,输出必须是能被 json.loads 解析的字符串。预期行为是:字段缺失时给 null,不给空字符串,也不给"未知"这类占位词——占位词会让下游判断失真。
import json
import re
from openai import OpenAI

SCHEMA = {
    "title": "文章或商品标题,字符串",
    "price": "价格数字,浮点,无则 null",
    "brand": "品牌名,字符串,无则 null",
    "published_at": "上架时间,YYYY-MM-DD,无则 null",
}

PROMPT = f"""你是数据抽取程序。只输出一个 JSON 对象,不要解释,不要 Markdown 代码块。
字段定义:{json.dumps(SCHEMA, ensure_ascii=False)}
缺字段一律用 null,禁止编造,禁止输出"未知"。
正文:
{{body}}
"""

client = OpenAI()

def extract(body: str) -> dict:
    body = re.sub(r"\n{3,}", "\n\n", body)[:6000]
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": PROMPT.format(body=body)}],
        response_format={"type": "json_object"},
    )
    return json.loads(resp.choices[0].message.content)
这段代码做的是:定义字段说明、把正文压到 6000 字符以内、强制模型返回 JSON 对象、再用 json.loads 解析。关键点有两个:一是提示词里明确写"禁止编造",二是开启 response_format 的 JSON 模式,让语法错误率大幅下降。
二、先用最稳的实现:确定性切分 + 模型抽取
最稳的方案是先用 CSS 选择器把正文块定位出来。选择器是确定性的,命中就是命中,不命中会立刻暴露,比让模型在整页 HTML 里猜要可靠得多。
from bs4 import BeautifulSoup

def clean_text(html: str) -> str:
    soup = BeautifulSoup(html, "html.parser")
    for tag in soup(["script", "style", "nav", "footer", "aside"]):
        tag.decompose()
    main = soup.select_one("article") or soup.select_one("main") or soup.body
    text = main.get_text("\n", strip=True) if main else ""
    return re.sub(r"\n{3,}", "\n\n", text)
上面这段做的是:去掉脚本、样式、导航、页脚等噪声标签,再依次尝试 article、main、body 三个容器,最后折叠多余空行。这一步把 200 KB 的 HTML 压成 5 KB 左右的纯文本,成本直接降一个数量级。
清洗之后还剩两个必须处理的边界:
- 超长正文:模型上下文有限,超过就要截断或分段。截断优先保留开头与结尾,中间按需切片。
- 多页内容:分页交给代码循环请求,不要指望模型自己翻页。
三、替代方案与取舍
三条路线各有适用范围,选错就事倍功半。
| 方案 | 适用场景 | 成本 | 主要风险 |
|---|---|---|---|
| CSS 选择器 + 正则 | 结构固定的站点 | 最低 | 改版即失效 |
| 选择器切分 + 模型抽取 | 结构多变、字段语义化 | 中 | 需要校验与重试 |
| 整页 HTML 直投模型 | 一次性小批量摸索 | 最高 | 超限、幻觉、不稳定 |
第二种是爬虫通用解析在生产环境的常见落点。它把"取哪块"的确定性交给选择器,把"字段是什么意思"的模糊性交给模型,各司其职。
代价也要说清楚:模型调用有延迟和费用,一条 5 KB 的正文抽取大概消耗一两千 token,批量跑一万页就是真金白银。所以务必先做去重与缓存,同一 URL 不要重复解析。
另外两个值得知道的策略:
- 先用正则兜底,失败再上模型。价格、日期这类格式固定的字段,正则命中率往往在九成以上,只有正则落空时才调用模型,成本能再降一截。
- 给模型一个真实样例(few-shot)。在提示词里放一条完整的输入输出示例,比堆十行描述有效,尤其是字段边界模糊的时候。
四、反例、边界和常见失败
这一节列四个真实会遇到的失败分支,以及对应的修复办法。
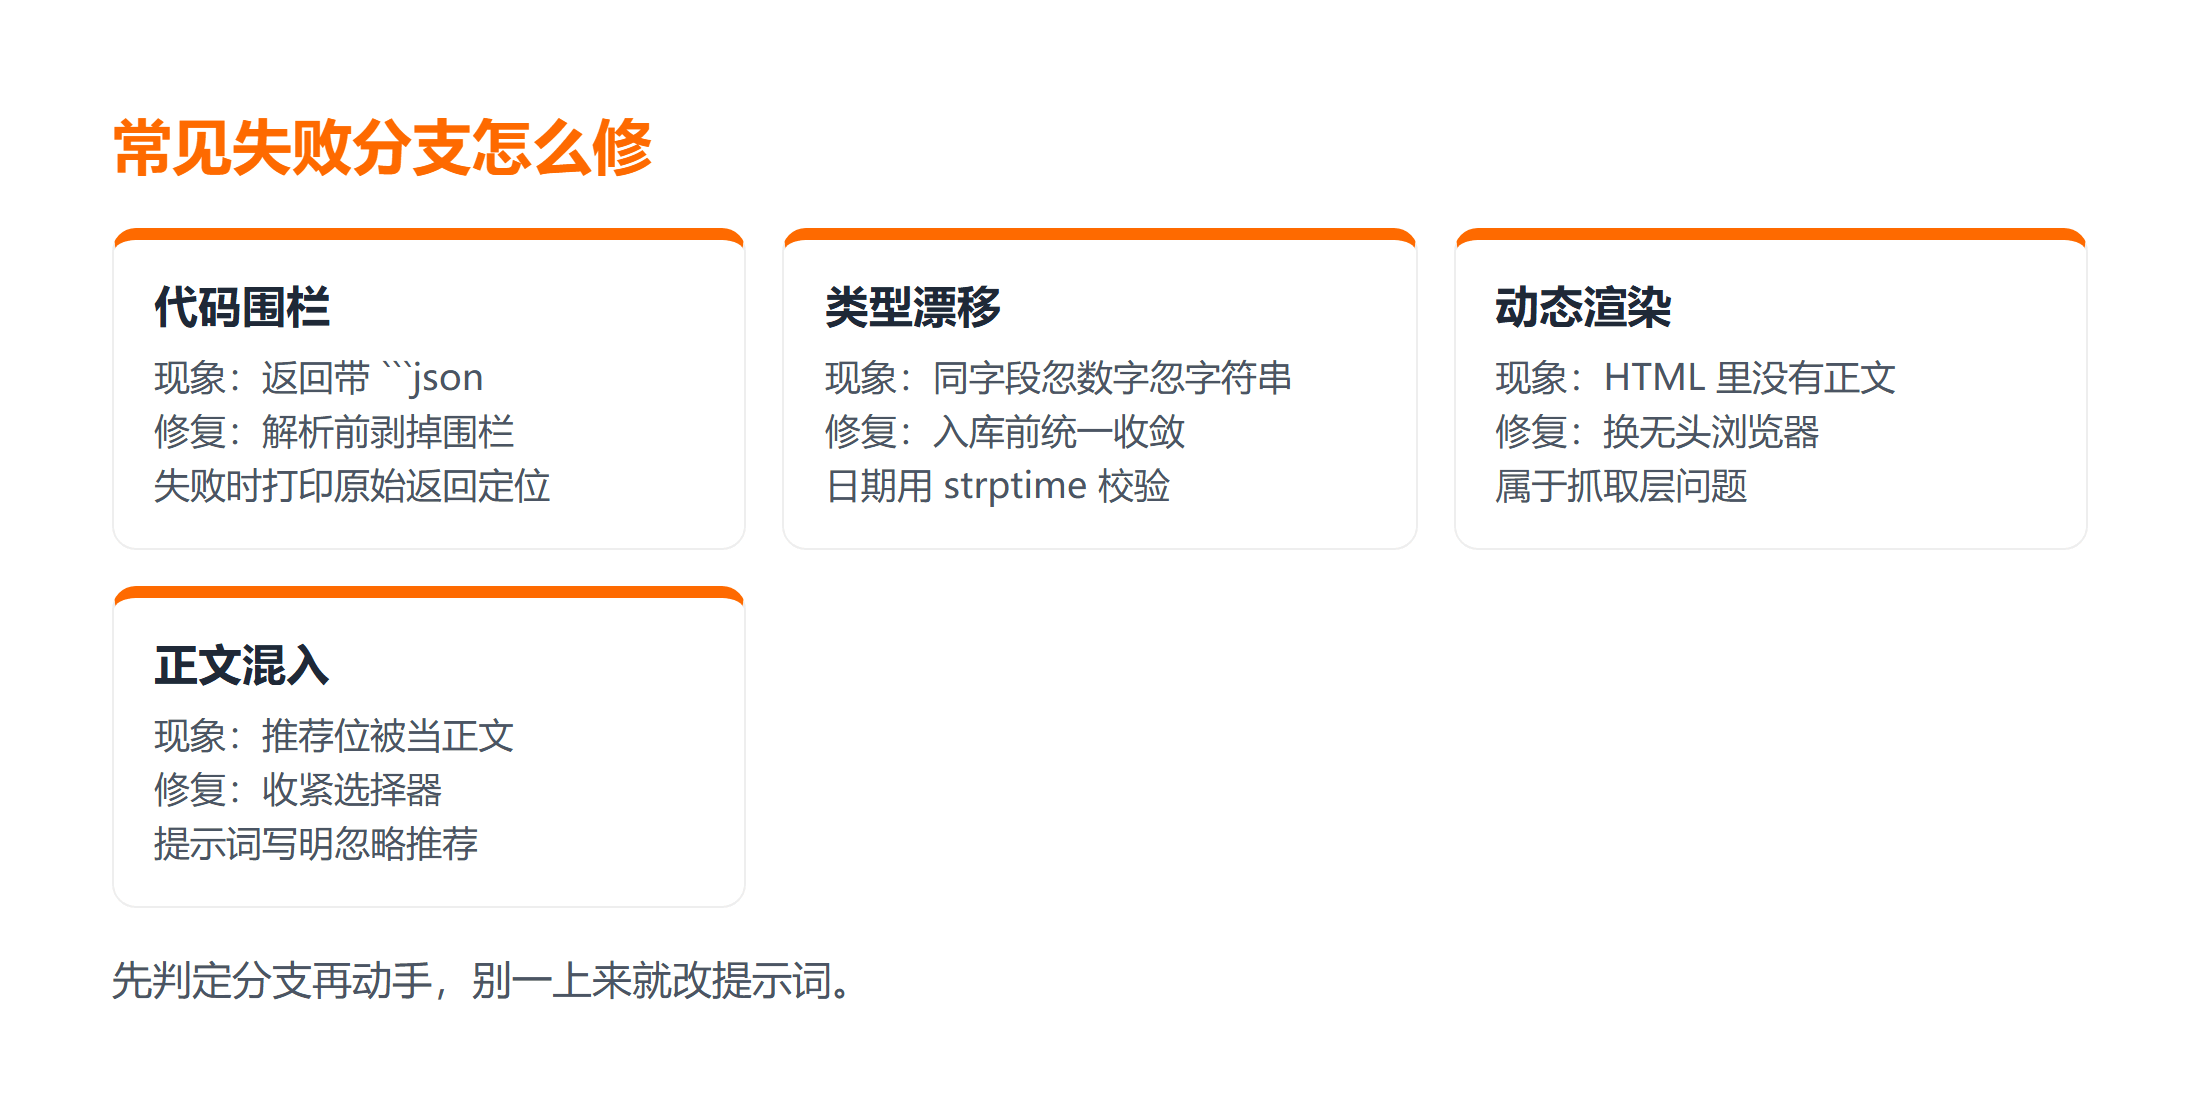
4.1 失败分支一:模型返回带 Markdown 代码围栏
即使声明"只输出 JSON",模型有时仍会包一层 ```json。修复办法是在解析前剥掉围栏,并保留原始返回用于排查。
def safe_load(raw: str) -> dict:
    cleaned = re.sub(r"^```(?:json)?|```$", "", raw.strip(), flags=re.M).strip()
    try:
        return json.loads(cleaned)
    except json.JSONDecodeError as exc:
        raise ValueError(f"模型返回不是合法 JSON:{cleaned[:200]}") from exc
这段做的是:先去掉首尾代码围栏再解析,解析失败时把前 200 个字符拼进报错信息。预期结果(未在本机执行,依据 json 模块的标准行为)是合法 JSON 正常返回字典,非法输入抛出带上下文的 ValueError。
4.2 失败分支二:字段类型漂移
同一个字段这次给数字、下次给字符串,入库时直接炸。修复办法是在入库前统一做一次类型收敛,日期用 datetime.strptime 校验,价格去掉货币符号再转浮点。
4.3 失败分支三:动态渲染页面抓不到正文
页面靠 JavaScript 渲染时,请求回来的 HTML 里没有正文。这是抓取层的问题,不是模型的问题,应该用无头浏览器或站点公开的 JSON 接口解决,别在提示词上打补丁。
4.4 失败分支四:把无关内容当成正文
评论区、推荐位被一起切进来时,模型会把推荐位里的标题当成字段。修复办法是收紧选择器到正文容器,并在提示词里写明"忽略评论与推荐内容"。
4.5 输入输出验证清单
跑之前按这个清单逐项核对,能挡掉大部分返工:
- 安装:
pip install requests beautifulsoup4 openai - 检查:打印
len(clean_text(html)),确认清洗后长度在 2000–8000 字符区间 - 运行:
python extract_demo.py - 预期:终端输出一行可解析的 JSON,缺字段为
null - 失败:
JSONDecodeError→ 打印原始返回定位围栏问题;字段全为null→ 检查选择器是否命中 - 修复:调整选择器或补一个 few-shot 样例后重跑
- 验证:同一 URL 连跑三次,三次输出一致才算通过
上面这些命令做的是装依赖、跑脚本、按输出定位问题。预期结果(未在本机执行)是三次输出一致;若三次不一致,说明提示词约束不够,需要补字段定义或降低温度参数。
总结
爬虫通用解析的正确姿势是"代码管确定、模型管模糊":用 CSS 选择器切正文,用模型做结构化提取,最后用代码校验 JSON 输出再入库。整页直投是探索阶段的权宜之计,不适合长期跑。
三条要点带走:
- 输入质量决定输出质量,清洗这一步不能省;
- 让模型只做抽取与归一化,请求调度和翻页永远由代码负责;
- 每条记录入库前都要过类型校验,模型返回什么都不能直接信。
下一步建议把抽取结果落到表里,跑一百条真实页面统计字段缺失率,再回头决定哪些字段值得改用正则兜底。语法细节记不住时,翻 Python 速查手册 最快。
常见问题
Q:为什么不让模型直接解析整页 HTML?
A:整页里的脚本和导航会挤占上下文,还会诱导模型把无关链接当正文。先切后抽,成本更低、结果更稳。
Q:模型返回的字段经常缺,怎么改善?
A:先确认正文块切对了,再在提示词里补一条完整示例。缺字段要求返回 null,不要让模型自己编内容。
Q:LLM解析网页时遇到动态渲染的页面怎么办?
A:那属于抓取层问题。用无头浏览器等待渲染完成,或直接找站点公开的 JSON 接口,模型侧改提示词没有用。
Q:批量跑一万页成本太高,有哪些降本手段?
A:先按 URL 去重缓存,再用正则兜底格式化字段,只有正则落空时才调模型。这三步通常能省下大半开销。
延伸学习
想把这条链路补完整,可以按这个顺序来:
- 读一篇相关笔记 常用爬虫库汇总,把 requests、BeautifulSoup、lxml 的分工看清;
- 想动手练,Python 爬虫配套课程 是边学边写的形式;
- 想验证抽取代码,直接用 Python 在线运行 贴进去跑。