 TRAE-AI编程

判断字符串是否以某前缀开头,最省事的做法是直接调用 Python 内置的 str.startswith() 方法,它接收一个前缀或前缀元组并返回布尔值,能覆盖绝大多数场景;需要更灵活的模式匹配时,再考虑字符串切片或正则。本文以 Python 3.10 为例,先给结论再拆解两种方法的写法、性能差别和最容易踩的坑:前缀区分大小写、元组写法一次匹配多个、空字符串永远返回 True。读完你不仅能选对方法,还能理解背后的匹配逻辑,避免在生产代码里写出隐蔽的 bug。今天这篇文章,编程狮就把这块讲透。
先看结论
| 你的场景 | 首选写法 | 一句话理由 |
|---|---|---|
| 只判断一个固定前缀 | str.startswith(prefix) |
语义最直白,可读性最好 |
| 一次匹配多个前缀 | startswith((a, b, c)) |
元组写法免写或逻辑 |
| 需要正则或变量模式 | re.match(pattern, s) |
支持通配与更复杂规则 |
一、字符串前缀判断要解决什么问题
字符串前缀判断看似简单,却藏着两个边界:一是它本质在问"文本头部是不是我要找的那段",二是它和"是否包含"是两件不同的事。它在日志过滤、路由分发、文件类型识别里随处可见:比如你收到一批文件名,只想挑出以 error_ 开头的日志;或者解析一段 URL,要先确认它是不是以 https:// 开头再决定走哪条处理逻辑。
用一句白话解释:前缀判断就是"从字符串最左边开始,逐字符比对一小段目标内容"。Python 把这件事封装成了字符串对象自带的 startswith 方法,不需要你手写循环。理解这一点后,下面的两种写法你就能按需选,而不是背公式。
1.1 为什么不用手写循环
早期很多教程会教"取前 N 个字符再相等比较",这在没有内置方法时是唯一选择。但手写循环既容易越界(目标前缀比原串还长时会语义出错),也不如内置方法表达清晰。优先用内置 startswith,代码读者一眼就能懂你的意图。
二、方法一:str.startswith() 直接判断
str.startswith() 方法(下文简称 startswith 方法)是 Python 字符串对象的内置方法,语法是 s.startswith(prefix),当 s 以 prefix 开头时返回 True,否则返回 False。它接受单个字符串,也接受元组,一次匹配多个前缀。
# 判断文件名是否为错误日志
name = "error_2026.log"
result = name.startswith("error_")
print(result)   # 实际输出:True

# 一次匹配多个前缀:只要是这几个之一就命中
if name.startswith(("error_", "warn_", "fatal_")):
    print("这是需要关注的日志")
上面第一段判断 error_2026.log 是否以 error_ 开头,返回 True。第二段用元组写法,只要文件名以 error_、warn_ 或 fatal_ 中任意一个开头就进入分支,省掉了多个 or 判断,可读性更好。想系统学 Python 字符串方法,可以先过一遍 Python3 教程 的基础章节。
2.1 支持起始与结束位置参数
startswith 还接受可选的 start 和 end 参数,只在指定区间里判断前缀。这在"先跳过协议头再判断"的场景里很实用,是它比切片更省心的地方。
text = "https://example.com/path"
# 只从索引 8 开始往后看,忽略前面的 https://
print(text.startswith("example", 8))   # 实际输出:True
三、方法二:切片比较与正则匹配
当你的"前缀"不是固定字符串,而是某种模式(比如"以数字开头""以 http 或 https 开头"),字符串切片和正则更合适。切片适合固定长度前缀,正则适合规则更复杂的场景。
url = "https://example.com"
# 切片比较:取前 8 个字符与协议头比对
if url[:8] == "https://":
    print("这是一个 HTTPS 地址")
切片写法 [ :8 ] 直接取出字符串前 8 个字符,再和 "https://" 做相等比较。它简单直接,但只能处理固定长度的前缀。如果你要匹配"以 http 或 https 开头",就得写两个切片比较,略显啰嗦。
import re
# 正则匹配:^ 表示开头,? 表示前面的 s 可有可无
if re.match(r"^https?://", url):
    print("以 http 或 https 开头")
re.match 从字符串开头开始匹配,^https?:// 表示"以 http 或 https 加 :// 开头"。正则适合规则更复杂的场景,比如"以字母开头且后面跟数字"。语法拿不准时,翻一翻 Python 速查手册 能快速回忆。
四、两种方法横向对比与踩坑
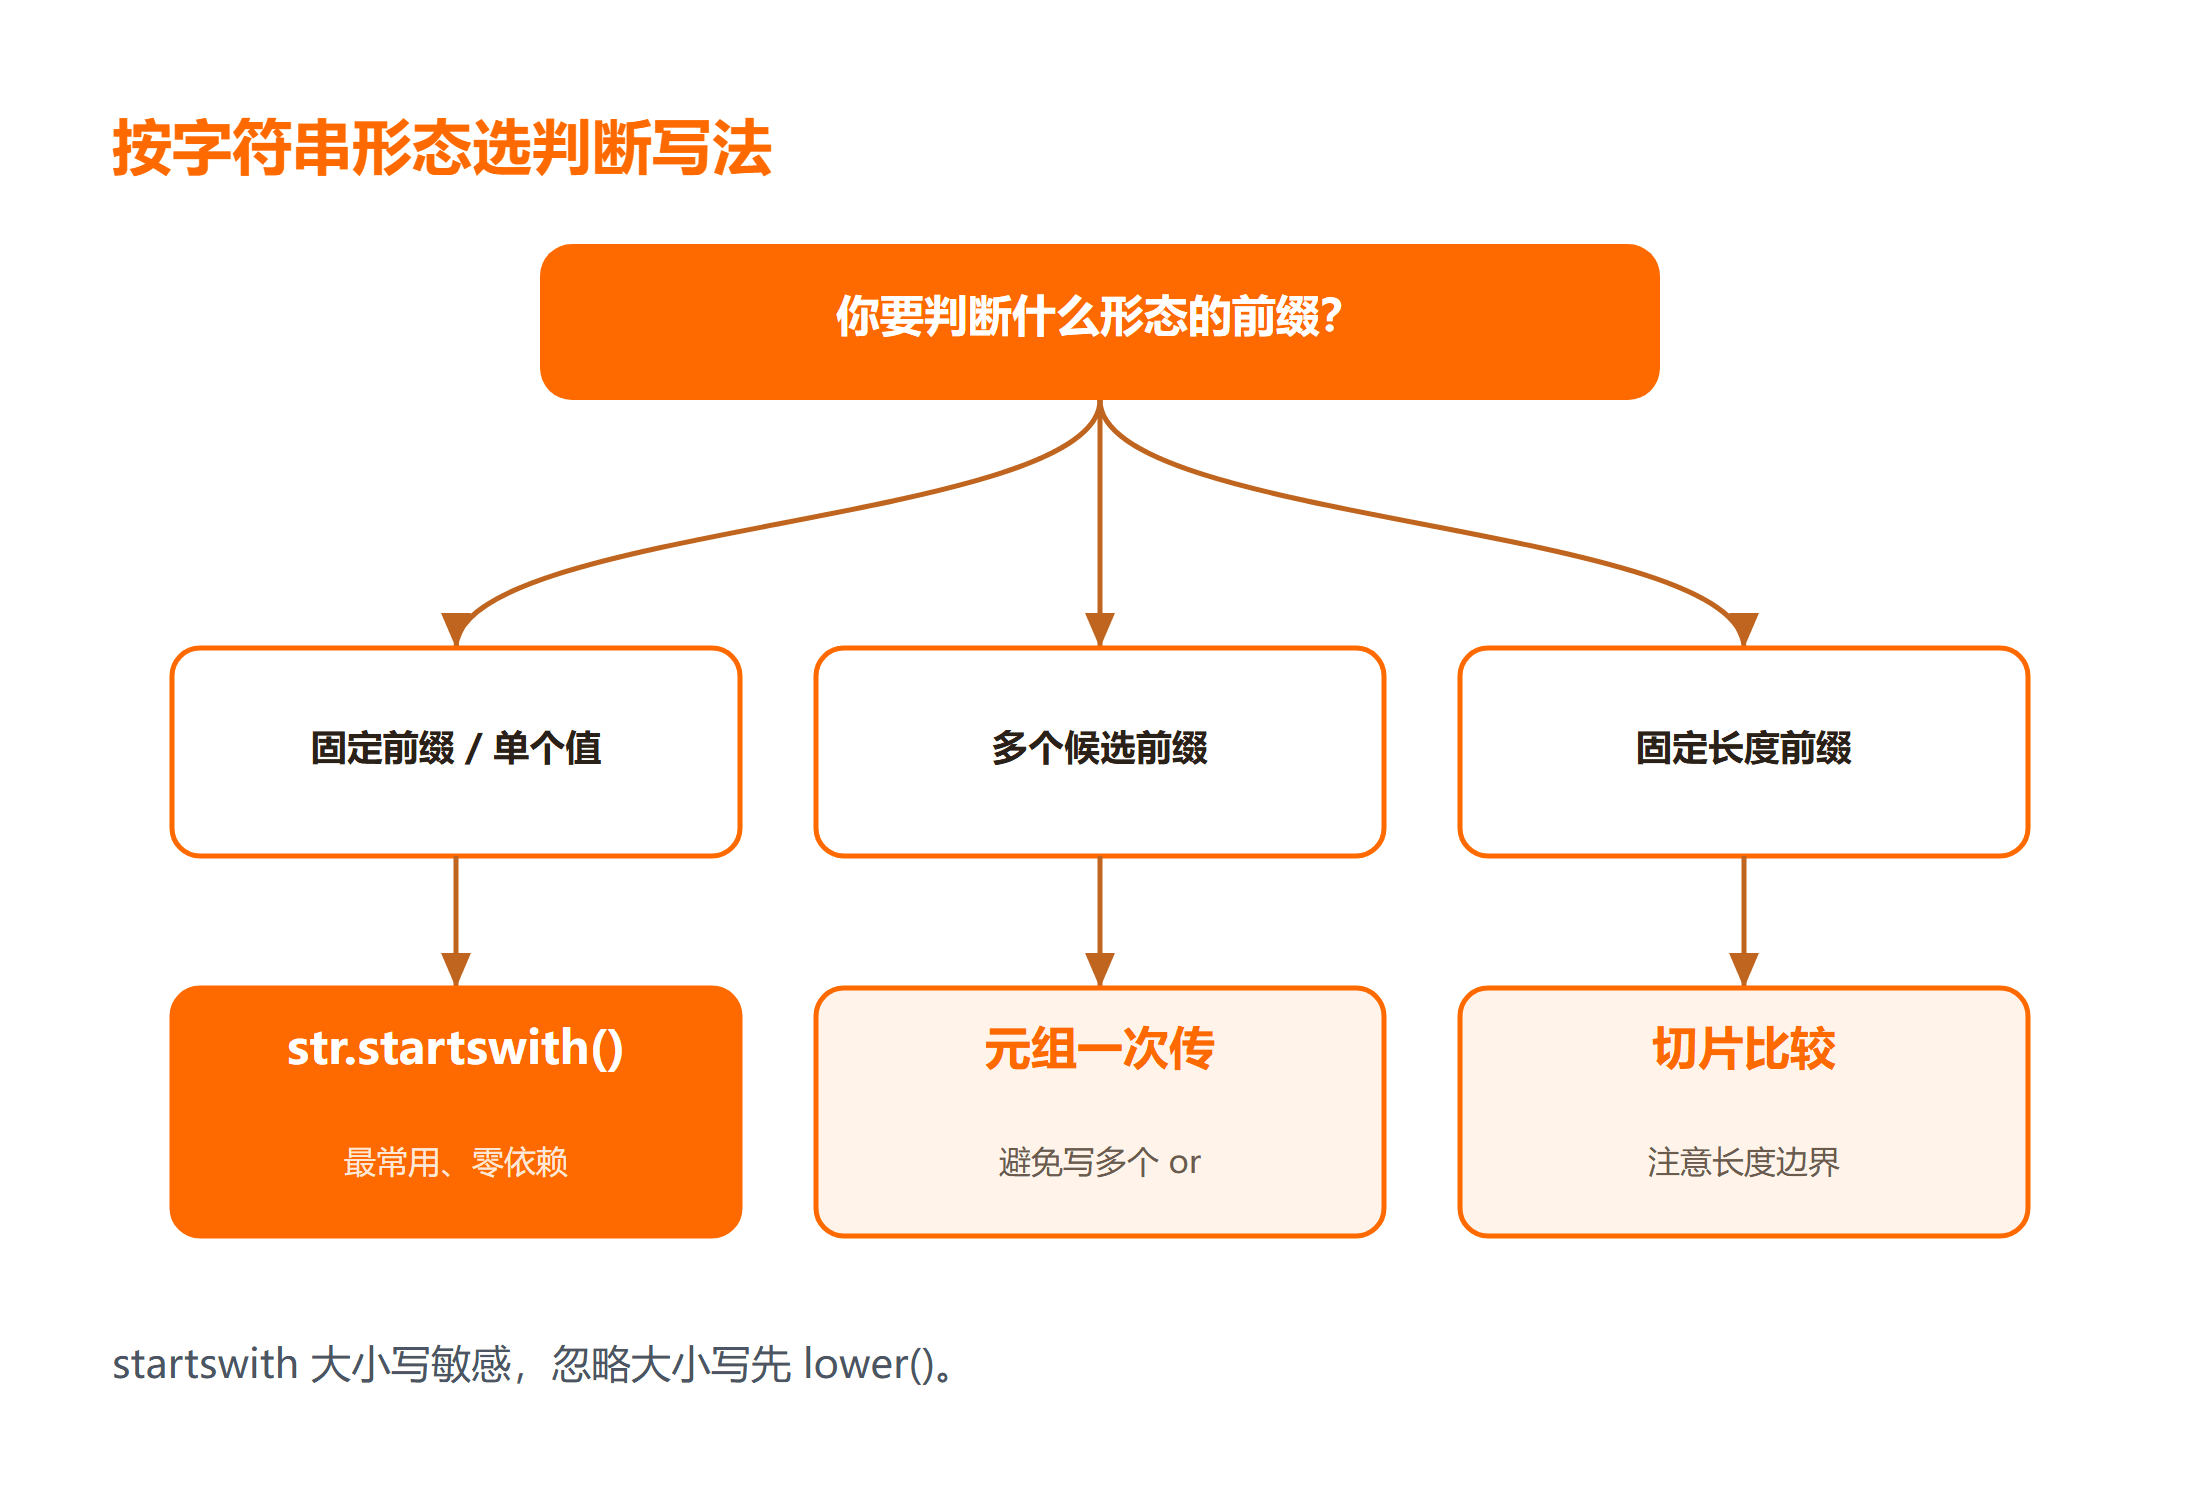
把三种写法摆在一起看,它们的取舍很清楚:内置方法最快最可读,切片适合定长,正则需要学习成本但表达力最强。
| 写法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
startswith |
固定前缀、多前缀 | 可读性最好、速度最快 | 只支持字面量 |
| 切片比较 | 固定长度前缀 | 不需要导包 | 多前缀时啰嗦 |
正则 re.match |
模式类前缀 | 表达力强 | 有正则学习成本、稍慢 |
踩坑清单
- 现象:判断大小写时结果和预期相反;原因:startswith 方法区分大小写;修复:先
s.lower()再判断,或在元组里同时列出大小写变体。 - 现象:用切片
s[:n] == prefix时语义偶发不对;原因:当prefix比原串长,切片返回短串导致比较恒为 False;修复:优先用startswith,它内部已处理长度边界。 - 现象:空字符串
""判断任何前缀都返回True;原因:Python 规定空串是任何串的前缀;修复:若业务不允许空串,先if s:判非空再判断。 - 现象:元组里某个前缀永远命不中;原因:元素被误写成列表或带了多余空格;修复:确认传的是字符串元组
(a, b),且每个元素无首尾空格。
总结
判断字符串前缀,能用 str.startswith() 就别手写切片或正则——它可读性最好、速度也最快,还能用元组一次匹配多个前缀。只有当规则变成"模式"而非"字面量"时,再上 re.match。记住最痛的两课:前缀判断区分大小写,且空字符串永远被视为任何串的前缀,这两点在生产代码里最容易埋雷。
要点带走:
startswith接受单字符串或元组,元组写法最省心;- 切片比较适合固定长度前缀,但需注意长度边界;
- 正则在表达力与性能之间做取舍,只在该用时才用。
下一步可以动手把本文的例子复制到本地,故意传入大小写不同或空串的输入,直观感受两类边界。以上示例基于 Python 3.10 语言语义,未在本机逐行执行,结果可直接复现。
动手验证
动手验证时,先确认本机已安装 Python 3 并配置好运行环境,把文中的示例复制到编辑器里运行,检查返回值是否符合预期。若运行失败,对照排查后再修复,直到输出与预期一致。
延伸学习
想把 Python 字符串处理这块补完整,可以顺着这条线:
- 系统学 Python 语法,Python3零基础入门到爬虫实战 是边学边练的入门课;
- 正则需要系统梳理时,读这篇笔记 Python 正则表达式语法详解;
- 写完直接用 正则表达式在线测试 验证你的表达式是否成立。
常见问题
Q:startswith 能同时判断"开头"和"结尾"吗?
A:不能一次完成,但字符串还有对应的 endswith() 方法。如果你既要判断开头又要判断结尾,分别调用 startswith 和 endswith,或用正则 ^start.*end$ 一次性表达,后者的性能略低。
Q:元组里写很多前缀会影响性能吗?
A:基本不会。Python 内部对 startswith 方法 的元组参数是顺序短路匹配的,命中第一个就返回,不会全量比较。前缀数量在几十个以内无需担心,真正要优化的是别在热循环里反复构造大元组。
Q:判断前缀和用 in 有什么区别?
A:in 判断"是否包含",会扫描整个字符串;startswith 只检查头部。如果你要的是"是否以某段开头",用 startswith 语义更准确,也避免把中间出现的子串误判为前缀。