 TRAE-AI编程

你写后台接口时,八成遇到过这种需求:用户只记得名字里带个“狮”字,或者手机号后四位,要你把它搜出来。精确等于是查不到的,得用模糊查询。但模糊查询不是只有 LIKE 一种写法,性能和适用面差别很大。核心答案一句话:最通用的是 LIKE 配合 % 和 _ 两个通配符;需要复杂模式匹配时上 REGEXP;当数据量大、追求检索性能时,再考虑全文索引。这篇以 MySQL 8.0 为例讲清三种方式的写法和代价。今天这篇文章,编程狮就把这块讲透。
先看结论
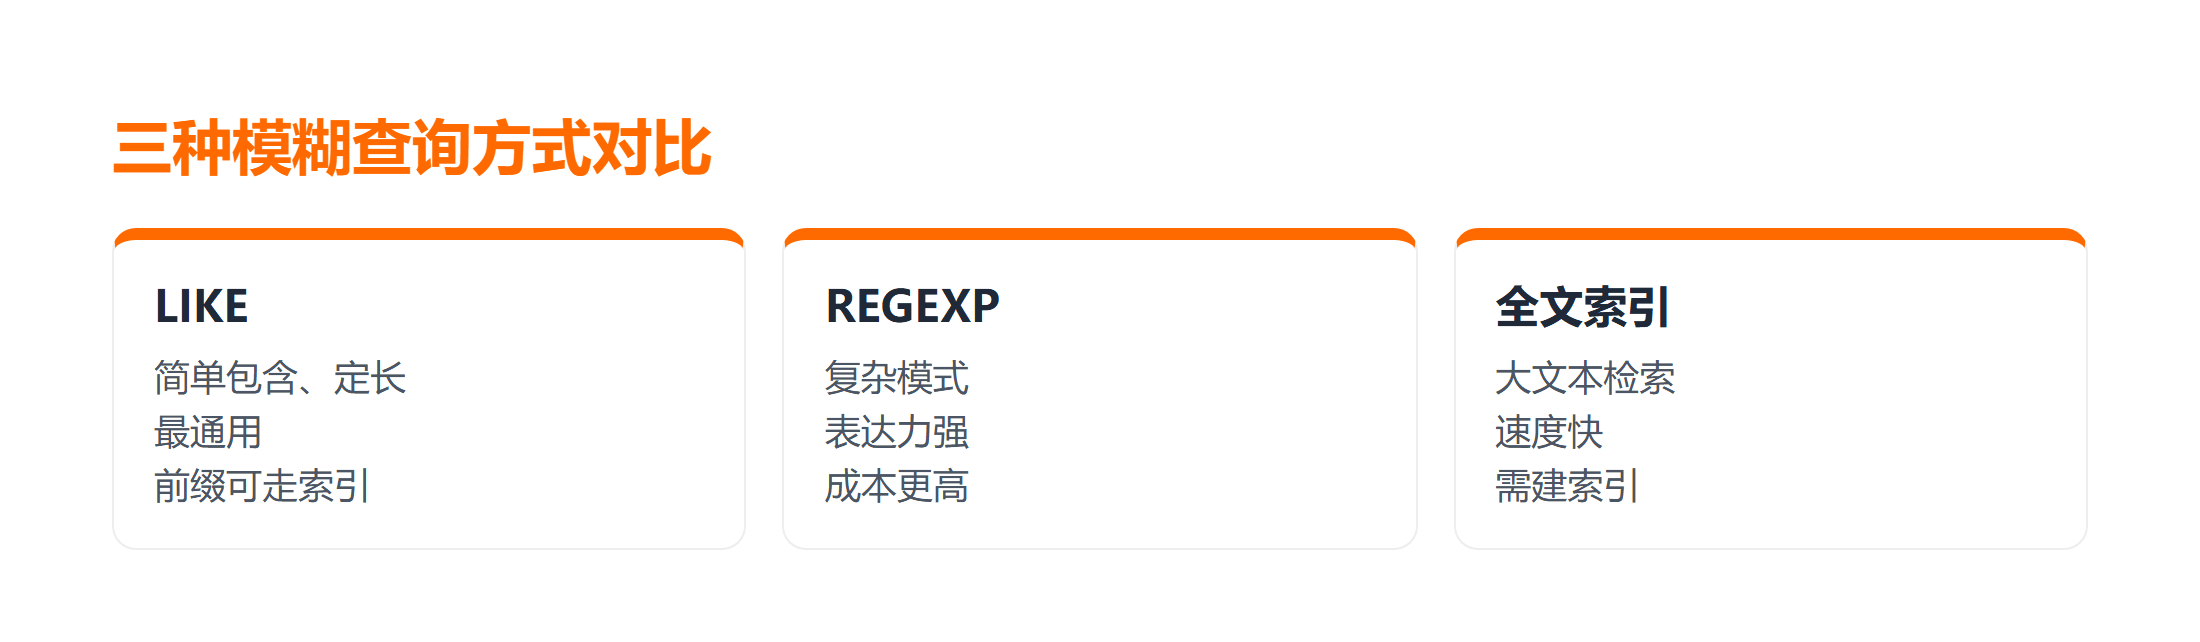
SQL 模糊查询不是只有 LIKE 一种,三种手段按“匹配复杂度 + 数据规模”递进:
| 你的场景 | 首选方式 | 一句话理由 |
|---|---|---|
| 简单包含、前缀匹配 | LIKE | 最通用,语法简单 |
| 复杂模式、正则匹配 | REGEXP | 支持正则,表达力强 |
| 大文本、高性能检索 | 全文索引 | MATCH AGAINST 速度快 |
一、SQL 模糊查询到底在解决什么
精确查询 WHERE name = 'w3cschool' 要求一字不差,但真实搜索往往是“包含某段”“以某字开头”“符合某种模式”。比如从用户表里捞出所有名字带“狮”的记录,或者手机号以 138 开头的用户,这类需求只能交给 SQL 模糊查询来完成。要系统学语法,可以先过一遍 SQL 教程。
它解决的正是“用不完整信息反查完整数据”的问题,是后台搜索框背后的核心语法。
二、SQL LIKE 与通配符:最通用的写法
SQL 通配符只有两个:% 匹配任意长度(含零个)的字符,_ 匹配恰好一个字符。LIKE 是几乎所有关系型数据库都支持的标准写法,速查语法可以翻 MySQL 速查手册。
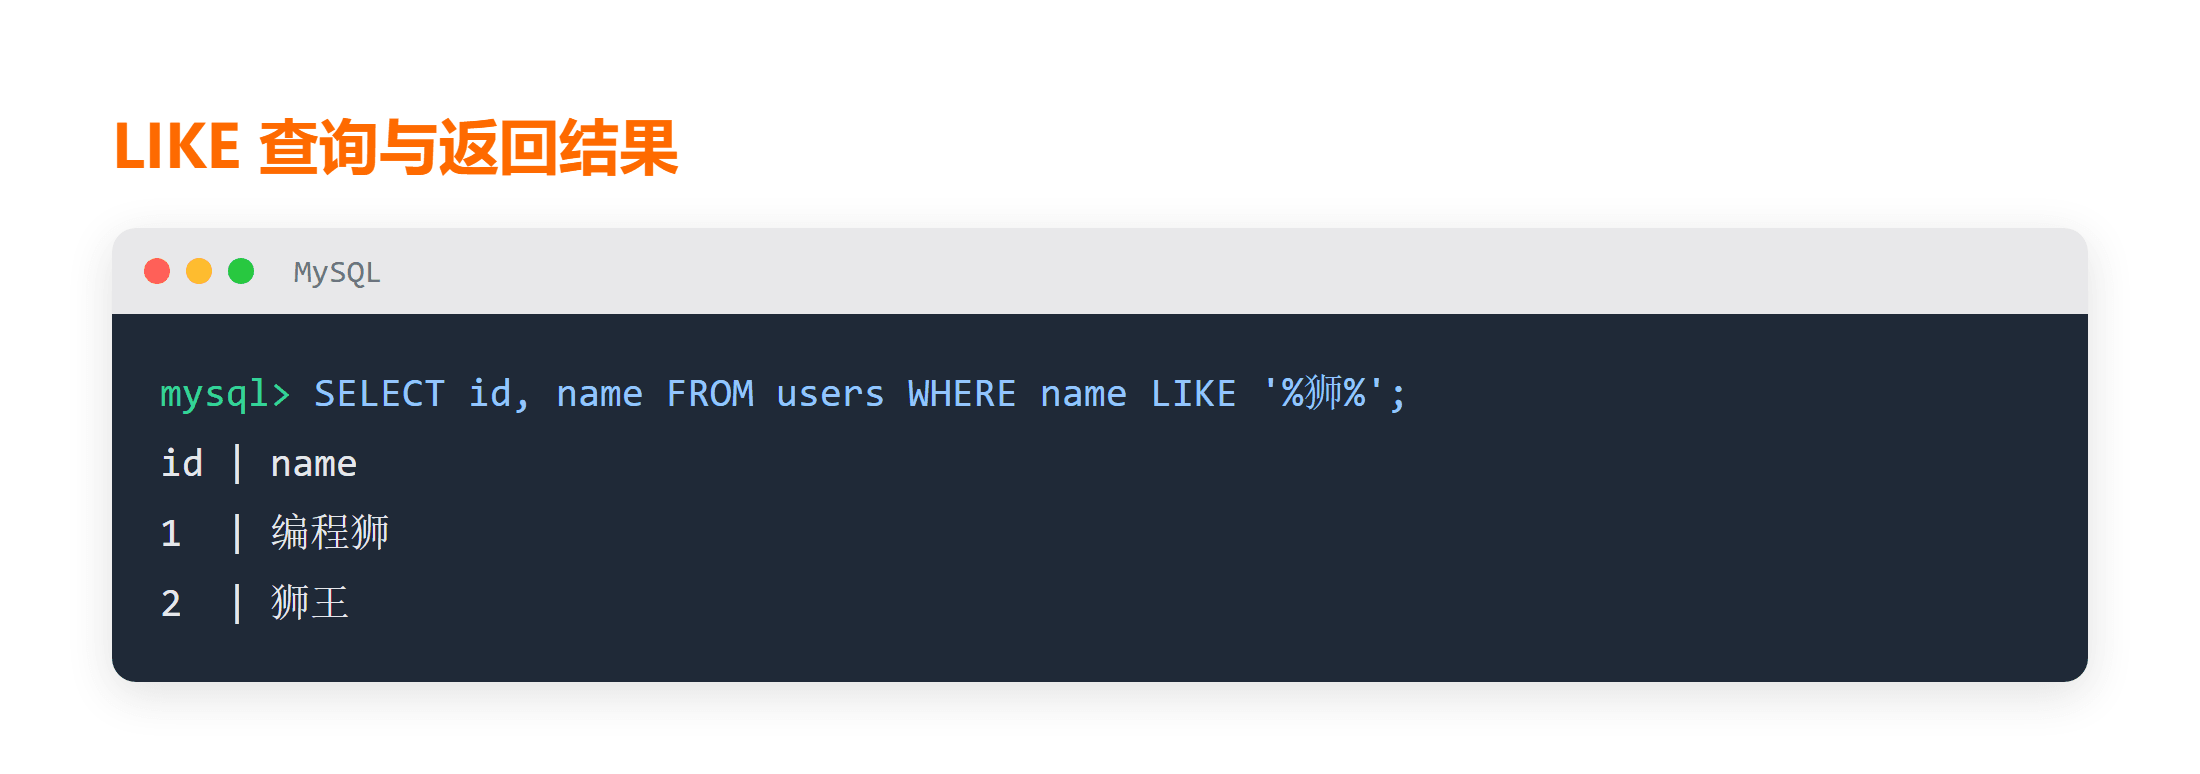
-- 名字里包含“狮”的所有用户
SELECT id, name FROM users WHERE name LIKE '%狮%';

-- 姓“王”且名字正好两个字
SELECT id, name FROM users WHERE name LIKE '王_';
上面两条分别做了“包含匹配”和“定长匹配”。预期结果里第一条会返回“编程狮”“狮王”这类任意位置含“狮”的行,第二条只返回“王X”这种两字姓名。
⚠️ 注意:当
%出现在模式最左侧(如'%狮'),数据库通常无法利用索引,会退化成全表扫描。数据量大时一定要警惕,必要时改成前缀匹配或全文索引。
三、SQL REGEXP:更灵活的正则匹配
当匹配规则变复杂,比如“以王开头或者以狮结尾”,LIKE 要写多个 OR,而 SQL REGEXP(MySQL 里也写作 RLIKE)直接用正则表达,可读性更好,适合复杂模糊匹配场景。不同库的 REGEXP 语法略有差异,可对照 SQL Server 速查手册 查语法。
-- 名字以“王”开头,或以“狮”结尾
SELECT id, name FROM users WHERE name REGEXP '^王|狮$';

-- 手机号是 1 开头的 11 位数字
SELECT id, phone FROM users WHERE phone REGEXP '^1[0-9]{10}$';
第一条用 ^ 和 $ 锚定首尾,第二条用字符类和量词描述手机号格式。REGEXP 表达力远强于 LIKE,但正则匹配的计算成本也更高,不适合在超大数据集上频繁使用。另外在 MySQL 里 REGEXP 默认不区分大小写,需要区分时得显式加 BINARY。
四、全文索引与横向对比
当要在长文章、商品描述这类大文本里搜关键词,LIKE 的 '%词%' 会全表扫描、慢到不可用。本质上,模糊查询是把用户输入当作“模式”而非“精确值”去匹配,因此很难利用普通等值索引,这正是它和精确查询在性能上天差地别的根源。此时该用数据库的全文索引,用 MATCH ... AGAINST 做分词检索,速度有数量级提升。
-- 先建全文索引,再检索
ALTER TABLE articles ADD FULLTEXT INDEX ft_body (body);
SELECT id, title FROM articles WHERE MATCH(body) AGAINST('数据库 优化');
MATCH AGAINST 会按分词结果返回相关度排序的结果,而不是机械子串匹配,更适合“搜索框”类需求。需要提醒的是,在 MySQL 里对中文友好必须配置 ngram 分词器,否则默认分词器对中文支持有限,中文检索准确率会明显下降。
| 方式 | 语法复杂度 | 能否用索引 | 适用数据量 | 适配场景 |
|---|---|---|---|---|
| LIKE | 低 | 前缀可,前导%不可 | 中小 | 简单包含、定长 |
| REGEXP | 中 | 通常不可 | 中小 | 复杂模式匹配 |
| 全文索引 | 高(需建索引) | 可 | 大 | 长文本检索 |
踩坑清单
- 现象:模糊查询越来越慢;原因:模式以
%开头导致全表扫描;修复:改成前缀匹配,或改用全文索引。 - 现象:大小写结果不一致;原因:LIKE 是否敏感取决于列的排序规则;修复:统一用
utf8mb4_general_ci或显式LOWER()。 - 现象:REGEXP 拖垮性能;原因:正则逐行计算;修复:限制数据范围或改用全文索引。
- 现象:中文分词不准;原因:默认全文分词对中文支持弱;修复:使用 ngram 分词器或专用搜索引擎。
总结
SQL 模糊查询的选型逻辑是“由简入繁”:能用 LIKE 的前缀或包含匹配就别上正则;模式一复杂就交给 REGEXP;一旦数据量和文本长度上来,全文索引才是终局方案。记住最痛的一课——前导通配符 % 会让 LIKE 退化为全表扫描,生产环境一定要规避。
要点带走:
- LIKE 的
%和_覆盖绝大多数简单模糊需求; - REGEXP 表达力强但更耗资源,别滥用在大数据集;
- 大文本检索请直接上全文索引,而不是
'%词%'。
下一步可以动手给常用搜索字段补上合适索引,直观感受查询耗时的变化。
动手验证清单
下面这组动作帮你在本机验证三种模糊查询,按你自己的环境执行,结果以实际输出为准(本文 SQL 未在作者本机执行,仅给出预期形态):
- 安装:本地起一个 MySQL 8.0 或用 Docker 拉取镜像;
- 配置:建一张
users表并插入若干含“狮”的测试数据; - 命令:执行
SELECT ... WHERE name LIKE '%狮%'验证包含匹配; - 运行:在命令行或客户端跑该语句,观察返回行;
- 检查:用
EXPLAIN查看是否走了索引,确认前导%时 type 为 ALL; - 预期:前导
%显示全表扫描,前缀匹配可走 range; - 失败:若查不到数据,检查字符集是否为 utf8mb4 导致中文不匹配;
- 修复:统一连接与表字符集,或显式转换;
- 验证:对大文本建 FULLTEXT 索引后对比
LIKE与MATCH的耗时。
延伸学习
想把 SQL 检索能力补完整,可以顺着这条线:
- 先过一遍 SQL 入门课程,把基础语法铺平;
- 对比性能看 REGEXP 与 LIKE 性能对比;
- 想优化复杂查询再读 MySQL 代价估计器怎么用。
常见问题
Q:LIKE 和 REGEXP 哪个更快?
A:绝大多数情况下 LIKE 更快,尤其是能用索引的前缀匹配。REGEXP 要逐行做正则计算,开销更高。只有 LIKE 写不出复杂模式时,才值得为表达力付出性能代价。
Q:为什么前导通配符会让查询变慢?
A:索引是按前缀有序排列的,'王%' 可以从索引定位起点,而 '%狮' 不知道起点在哪,只能逐行比对,于是退化为全表扫描。
Q:中文模糊查询为什么有时匹配不到?
A:多半是字符集或排序规则不一致,比如表是 utf8mb4 而连接用了 latin1,中文会被截断或转码失败。统一成 utf8mb4 通常就能解决。