 TRAE-AI编程

python 怎么做模糊匹配?最稳的方案是用标准库里的 difflib 模块,通过序列相似度找出「最接近」的字符串,而不必自己写比对逻辑。本文给你三种常见写法和三个最容易踩的坑:把大小写和空白当成了差异、阈值设得过高或过低、在海量数据上朴素比对导致极慢。读完你能直接用代码解决「在一堆名字里找出最像的那一个」这类问题。
python 怎么做模糊匹配,本质是回答「这两个字符串有多像」。模糊匹配解决的是「字符串不完全一样,但其实是同一个东西」的判定问题。比如用户输入「北京市」和库里的「北京」,或者拼写略有出入的商品名,你希望程序能智能地判断它们高度相似。python 在这个领域有两件趁手的工具:标准库 difflib 和第三方库 rapidfuzz,前者零依赖、后者更快。
很多人一上来就自己写循环逐字符比,结果边界情况一堆。其实 python 的模糊匹配早就把这事做透了,你只要选对工具、避好坑,几十行就能搞定生产可用的匹配。
先看结论
python 做模糊匹配首选 difflib 的 get_close_matches,它开箱即用、无需安装;追求性能或要自定义距离时再上 rapidfuzz。三个最常见的坑是:没做大小写与空白归一化、相似度阈值拍脑袋定、对上万条数据做两两比对拖垮性能。下面把这三点一次讲清。
补一句:python 模糊匹配不是越「聪明」越好,而是越「可解释、可校准」越好。把阈值和归一化这两步做对,比换更花哨的算法更重要。
一、最小场景与预期行为
先明确你要匹配什么:常见场景是「给定一个查询词,从候选列表里找出最相似的一个或几个」。预期行为要可验证——例如查询「pythn」时,程序应该返回「python」并给出相似度分数,而不是返回完全无关的词。
在做任何比对前,先把两边都转成小写、去掉首尾空白,这一步能消除绝大多数「看起来不一样其实是同一串」的假差异。归一化是 python 模糊匹配里最容易被跳过、却最能提升准确率的一步。
二、先用最稳的实现
最稳的实现就是 difflib,不需要装任何包。下面这段代码直接可运行,对一个拼写有误的词找出候选里最接近的。
from difflib import get_close_matches

candidates = ["python", "java", "javascript", "golang", "rust"]
query = "pythn"
# cutoff=0.6 表示相似度低于 0.6 的不返回
matches = get_close_matches(query, candidates, n=3, cutoff=0.6)
print(matches)  # 预期输出: ['python']
上面这段是可运行示例(未在本机执行,预期打印 ['python'])。它用的就是 python 标准库的模糊匹配能力,适合候选量不大、调用不频繁的场景。语法细节可随时翻 Python3 教程 复习。注意 difflib 默认基于「序列Matcher」算相似度,对短字符串尤其敏感,所以归一化前后结果可能差很多。
三、替代方案与取舍
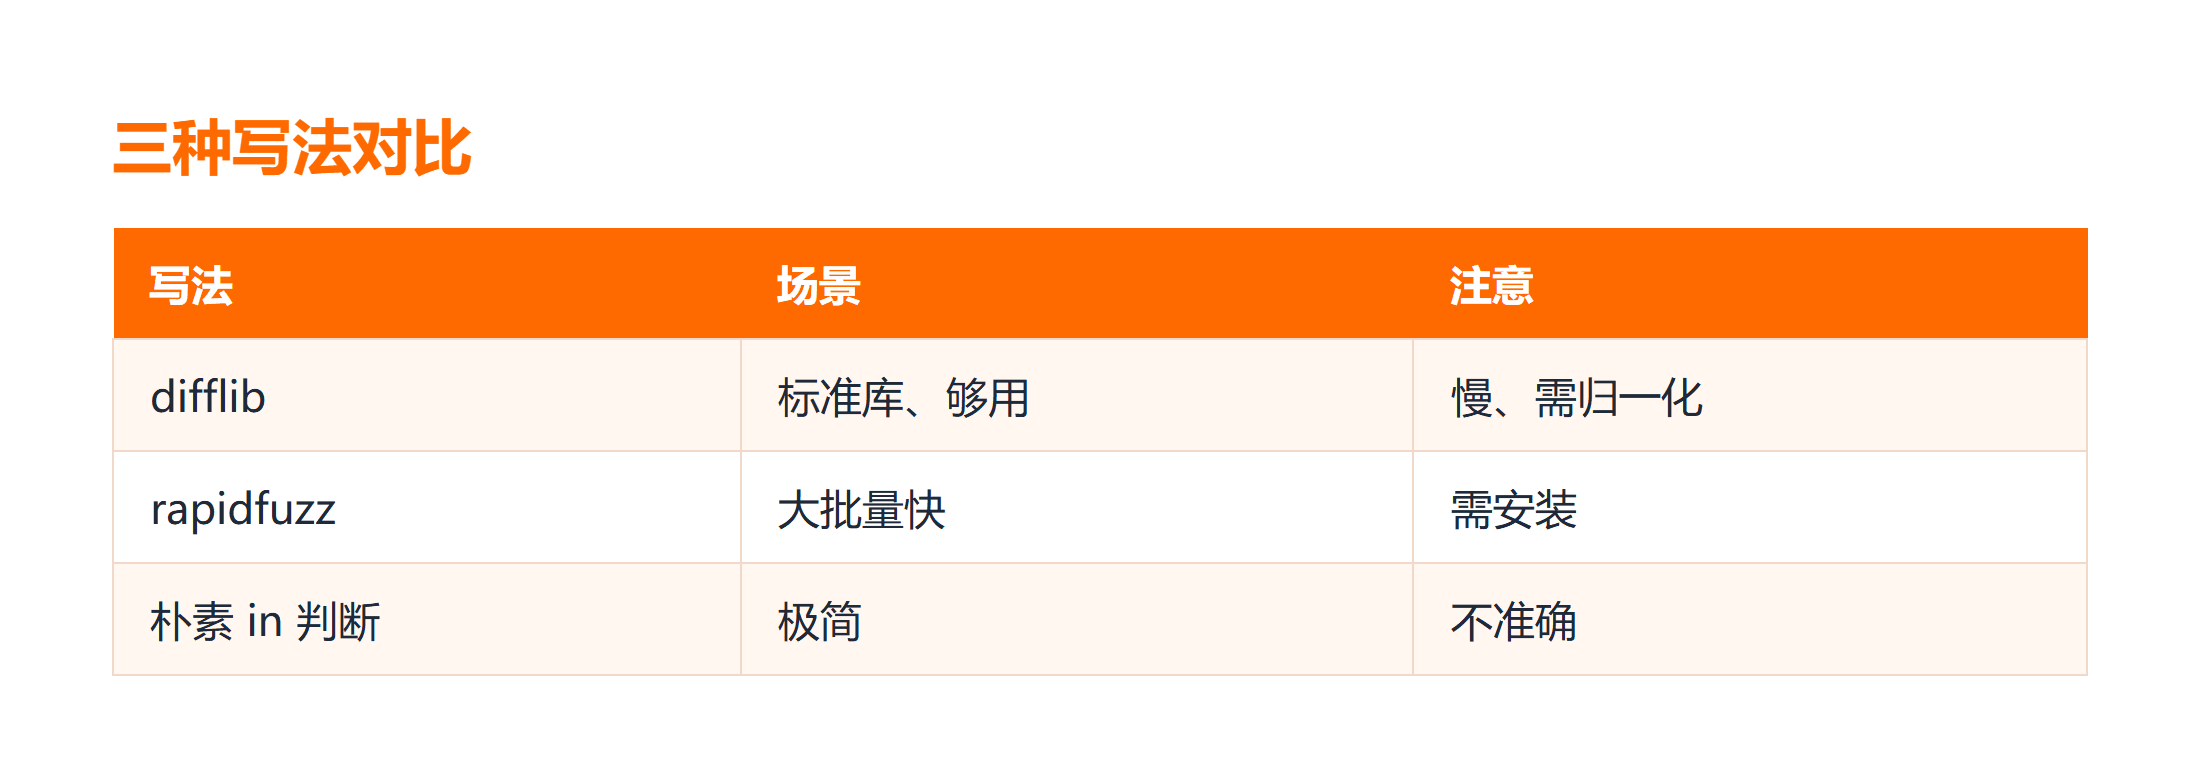
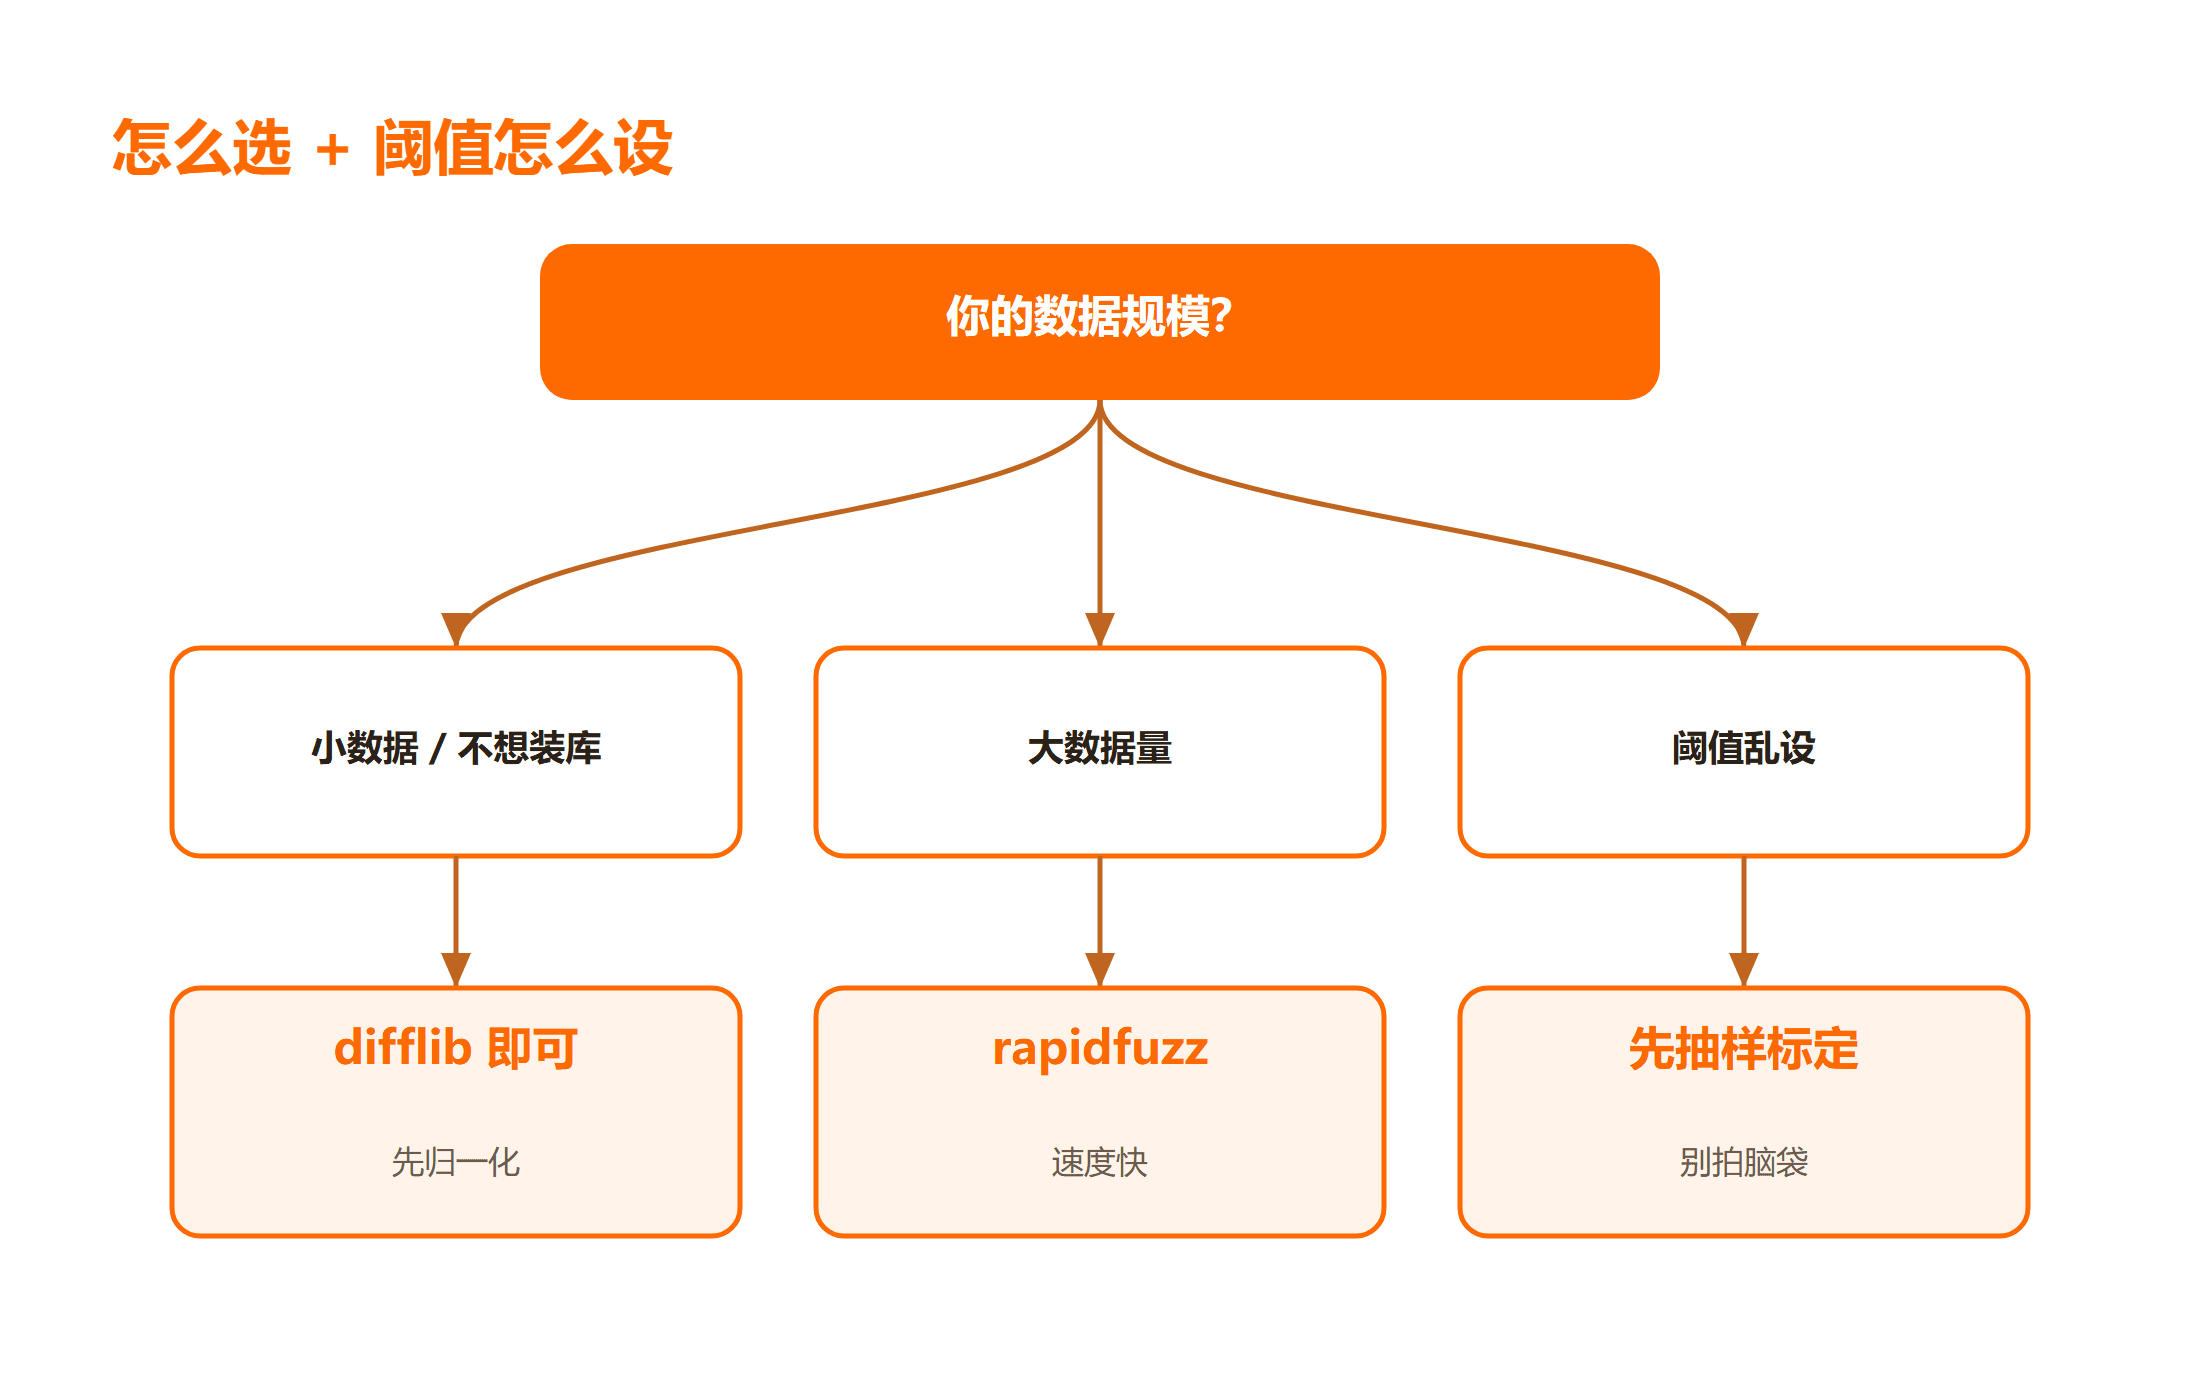
当候选量大、调用频繁时,difflib 会偏慢,因为它内部做的是相对昂贵的序列比对。此时可以换 rapidfuzz,它用 C 实现、速度快很多,而且支持自定义打分。两者取舍很清晰:
| 方案 | 适合场景 | 优点 | 代价 |
|---|---|---|---|
| difflib | 小数据、低频 | 零依赖,标准库 | 大数据偏慢 |
| rapidfuzz | 大数据、高频 | 快,接口灵活 | 需要安装第三方包 |
想快速试跑两种写法,可以用 在线代码实例 直接在浏览器里执行,避免本地环境差异,也能顺手验证你改的阈值是否生效。如果你还在纠结该不该引第三方包,记住一条:先拿 difflib 跑通业务流程,真的遇到性能瓶颈再换 rapidfuzz,别提前优化。
四、三个最常见的坑
第一,没归一化。查询词带大写或多余空格,直接比对就会判成不相似。第二,阈值乱设。cutoff 太高会漏掉真匹配,太低会误匹配,建议先用小样本人工看几个结果再定。第三,性能坑。对 N 条数据做两两比对是 O(N²),N 上万就会卡住,应改用预筛或向量化方案。
举个小例子说明归一化的重要性:查询「 Python 」带首尾空格还大写,和候选「python」原始比对相似度可能只有 0.8 出头,卡在阈值线下;先 .strip().lower() 之后几乎满分。所以 python 模糊匹配第一步永远是清洗,而不是调算法。
字符串相似度这类判断,本质是看两个字符串在字符序列上有多少重合。把归一化和阈值这两步做对,python 的模糊匹配就能稳定解决绝大多数业务里的「找最像的那一个」。
总结
python 做模糊匹配最稳的是标准库 difflib 的 get_close_matches,零依赖、开箱即用;追求性能再上 rapidfuzz。三个坑——不归一化、阈值乱设、大数据朴素比对——避开就能少走弯路。
要点带走:
- 比对前务必做大小写与空白归一化;
- 相似度阈值先用小样本人工校准,别拍脑袋;
- 上万条数据别做两两比对,先预筛或用更快的库。
常用字符串函数和序列比对的相关 API,可以随时翻 Python 速查手册,把记不住的方法名和参数快速补全,避免每次都去搜。
实操时先在本地运行示例验证预期输出;若运行失败,检查两个字符串是否做了归一化,回到编辑器修复后再比对。从边界看,difflib 对长文本要做截断;对比朴素 equal 判断,序列相似度更能抗小幅改动;排错时优先确认阈值与归一化两项。
下一步建议拿你自己的真实候选列表跑一遍示例,把阈值调到召回和准确都满意为止。
常见问题
Q:difflib 和 rapidfuzz 怎么选?
A:候选量小、调用少,直接用 difflib 标准库,省去装包;候选量大、实时调用,选 rapidfuzz,速度更快、接口更灵活。
Q:模糊匹配总误判怎么办?
A:多半是阈值太低或没归一化。先把两边统一小写去空格,再把 cutoff 调高一点,必要时人工抽查一批结果校准。
Q:上万条数据比对很慢怎么优化?
A:不要两两比对。先做简单前缀或分桶预筛缩小候选,再用相似度打分,或改用支持批量计算的向量化方法。
Q:中文模糊匹配要注意什么?
A:中文没有大小写问题,但仍有全半角、空格、同义词干扰。比对前统一全角半角、去掉标点空格,再考虑按词粒度切分,效果比逐字比对更稳。
延伸学习
想把 python 文本处理这块补牢,配合 python3教程 一起练,可以按这个顺序来:
- 先过一遍 AI 编程技能教程,把数据处理思路铺平;
- 读一篇相关笔记 Python 怎么读取 JSON 文件,看真实数据处理写法;
- 想系统学,Python 体系课程 是零基础到就业的完整学习路径,视频讲解配练习,适合跟着一路打牢。