
 TRAE-AI编程

SQL 分组统计最基础的写法是 GROUP BY 配合 COUNT、SUM、AVG 这类聚合函数,按某一列把多行归并成组再算汇总;想只保留满足条件的组,给查询加 HAVING 过滤;如果既要分组汇总、又想保留每一行的原始明细,就用窗口函数 PARTITION BY。今天这篇文章,编程狮就把这三种写法从最小示例讲到边界。
本文以 MySQL 8 的语法为准验证,覆盖基础聚合、分组过滤和窗口函数三条路径,并附选型对比。读完你能按“要不要明细行”这个标准,直接选出最合适的写法。下面先把结论摆出来。
先看结论
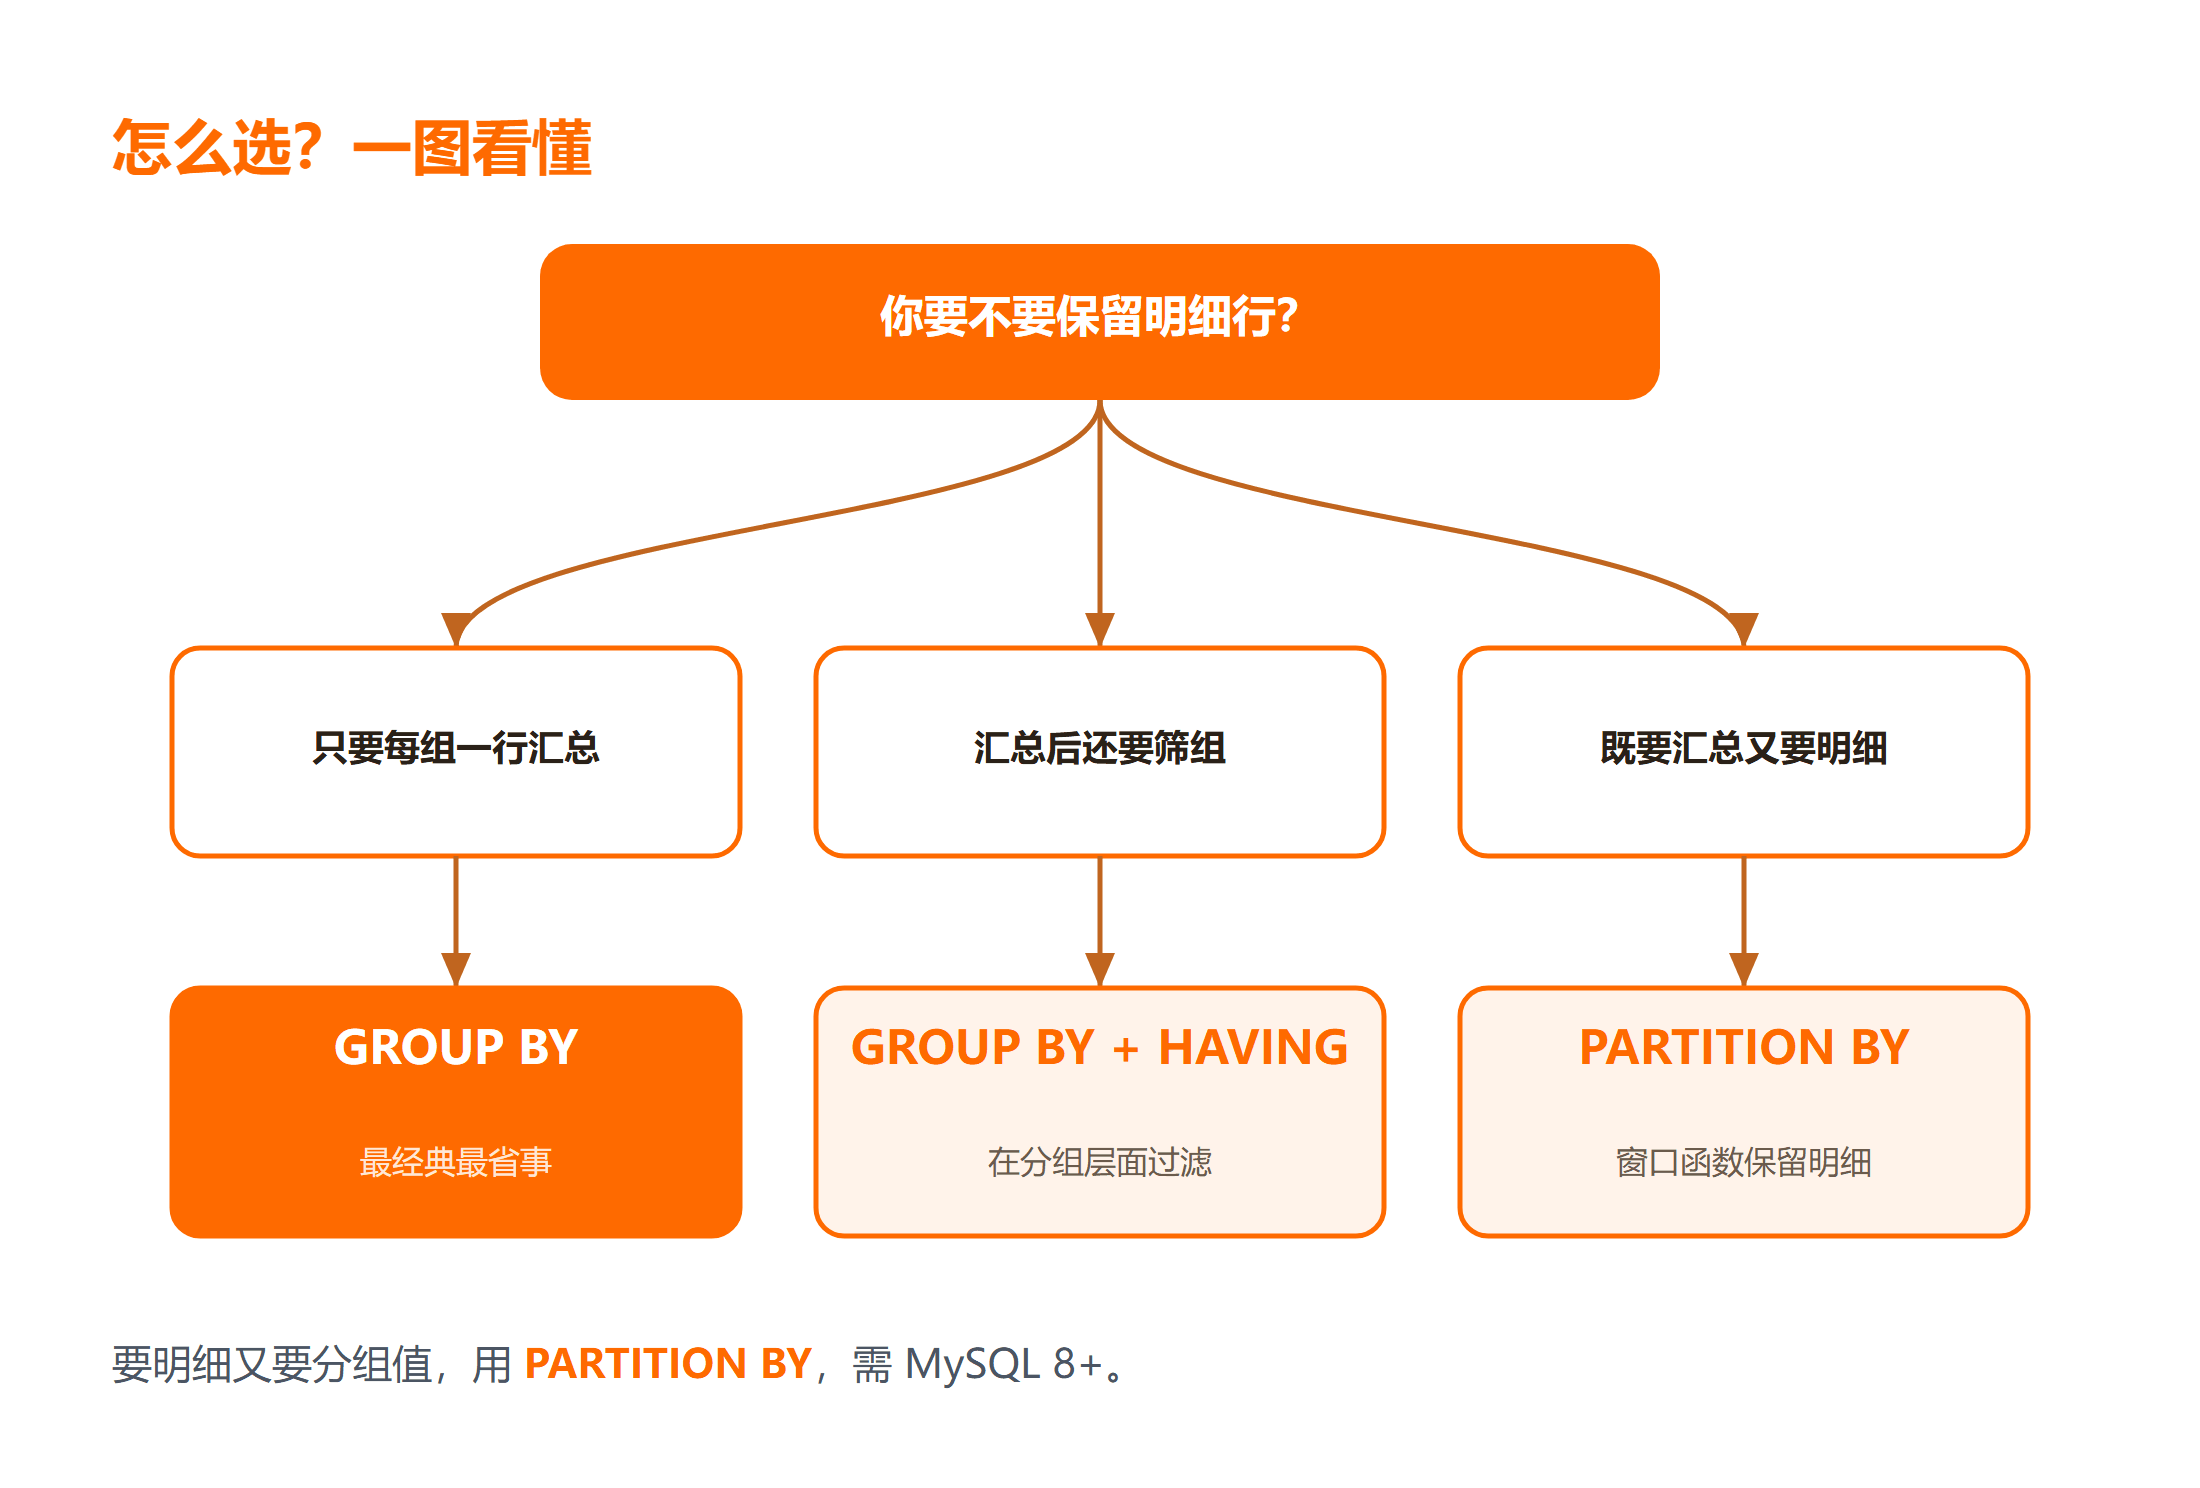
三种写法解决的是不同颗粒度的统计需求,先按你要不要保留明细行来定:
| 你的需求 | 推荐方式 | 一句话理由 |
|---|---|---|
| 只要每组一行汇总 | GROUP BY + 聚合函数 |
最经典、最省事 |
| 汇总后还要筛掉不合条件的组 | GROUP BY + HAVING |
在分组层面过滤 |
| 既要汇总又要每行明细 | PARTITION BY 窗口函数 |
不折叠行,明细保留 |
如果你还没建过示例表,可以先看 MySQL 基础教程,照着把测试库和 employees 表建起来。
一、方法一:GROUP BY 加聚合函数
最基础的用法:用 GROUP BY 指定按哪一列分组,再用聚合函数算每组的统计值。下面这张 employees 表按 department 分组,数出每个部门的人数。
-- 按部门统计人数
SELECT department, COUNT(*) AS emp_count
FROM employees
GROUP BY department;
上面这段做了两件事:把相同 department 的行归到一组、COUNT(*) 数出每组有多少行。聚合函数还有 SUM、AVG、MAX、MIN,按统计目标替换即可。
适用场景:部门人数、品类销售额、每月订单量——任何“按某维度汇总成一行”的需求都靠它。
边界说明:GROUP BY 会把同组多行压成一行,所以 SELECT 里只能出现分组列和聚合结果。这是它和后文窗口函数最大的区别。
⚠️ 注意:
SELECT里出现的所有非聚合列,都必须写进GROUP BY,否则 MySQL 在严格模式下会直接报错,宽松模式则返回一个不确定的值。
二、方法二:GROUP BY 加 HAVING 过滤分组
WHERE 在分组前过滤行,而 HAVING 在分组后过滤“组”。当你要“只保留人数大于 5 的部门”时,WHERE COUNT(*)>5 是无效的,必须写在 HAVING 里。
-- 只保留人数大于 5 的部门
SELECT department, COUNT(*) AS emp_count
FROM employees
GROUP BY department
HAVING COUNT(*) > 5;
预期结果(未在本机执行,依据 MySQL 官方分组语法):返回那些 emp_count 大于 5 的部门及其人数,人数不足 5 的组被整组丢弃。
验证要点:用 SELECT 把 emp_count 一起查出来核对,确认被丢弃的都是小于/等于 5 的部门;若结果不符,先检查 HAVING 里写的是聚合表达式而非普通列。
边界说明:HAVING 可以直接引用聚合结果(如 COUNT(*)),也能引用 GROUP BY 里的列;但引用普通非分组列在语义上无意义,应尽量避免。
三、方法三:窗口函数 PARTITION BY 保留明细
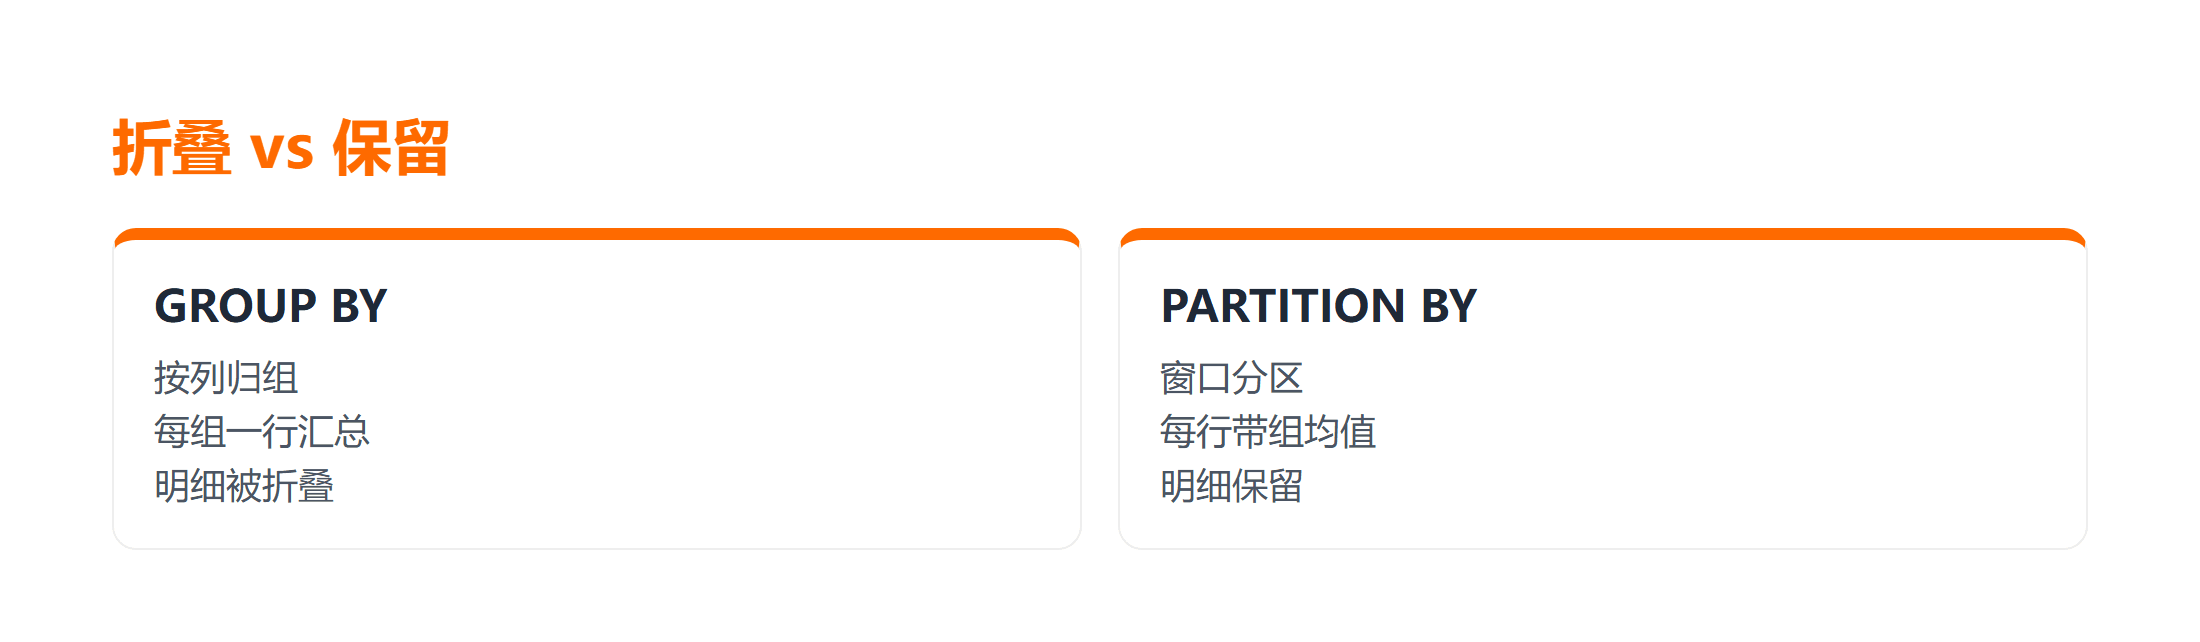
前两种都会把多行“折叠”成一行汇总,明细丢了。窗口函数 PARTITION BY 则在保留每一行原始数据的同时,算出一个分组内的聚合值,写在同一行的另一列上。
-- 保留每行明细,同时算部门平均工资
SELECT
  name, department, salary,
  AVG(salary) OVER (PARTITION BY department) AS dept_avg
FROM employees;
适用场景:既要看每行原始数据、又要在旁边标注“它所在组的平均值/排名/累计”。比如给每个员工打上部门平均工资,方便前端做对比展示。关于标准 SQL 写法,SQL 基础教程 里有更系统的聚合与窗口函数讲解,值得延伸阅读。
边界说明:窗口函数不折叠行,输出行数等于原表行数。它需要 MySQL 8 及以上;在 5.7 及更早版本里会报语法错,只能用子查询或变量模拟。
四、三种方式横向对比与选型
| 方式 | 输出行数 | 是否保留明细 | 典型用途 |
|---|---|---|---|
GROUP BY |
每组一行 | 否 | 部门人数、品类销售额 |
GROUP BY + HAVING |
每组一行(已过滤) | 否 | 筛选高频分组 |
PARTITION BY |
原表每行一行 | 是 | 每行标注所属组均值 |
排错清单:
- 现象:报错“非聚合列必须出现在 GROUP BY”,原因:
SELECT多了未分组的列,修复:补进GROUP BY或套聚合函数; - 现象:
HAVING里用WHERE的列名报错,原因:HAVING引用了聚合结果,修复:直接写聚合表达式如HAVING COUNT(*)>5; - 现象:窗口函数报语法错,原因:MySQL 5.7 及更早版本不支持
OVER,修复:升级到 MySQL 8 或改用子查询。
💡 小提示:想直接动手试,文末「延伸学习」已放好 MySQL 教程入口,建一张小表就能复现上面的分组结果。
实操清单:前置、操作、验证与失败处理
按这份清单把分组统计跑通:
- 前置(安装/配置):本地装好 MySQL 8(窗口函数需要 8+),用
mysql -V确认版本;建一张employees测试表并灌入几行样本数据。 - 操作(命令/运行):把示例 SQL 粘进 MySQL 客户端或 Workbench 执行;方法三务必确认服务端版本 ≥ 8。
- 验证(检查/预期):预期方法一返回“部门—人数”两列、每组一行;方法三返回与原表行数相同的明细,并多出一列组均值。
- 失败处理(失败/修复):报“非聚合列”就补
GROUP BY;窗口函数报语法错就升级 MySQL 或改写子查询。
总结
SQL 分组统计有三条主路径:GROUP BY 做经典汇总、HAVING 在汇总后筛组、窗口函数 PARTITION BY 在保留明细的同时算分组值。SQL 分组统计有哪几种完整写法,选型关键就看一句话——你要不要原始明细行。
要点带走:
- 只要汇总,用
GROUP BY+ 聚合函数; - 分组后还要过滤,用
HAVING而非WHERE; SELECT里的非聚合列必须进GROUP BY;- 要明细又要分组值,上窗口函数,但需 MySQL 8+。
下一步建议把窗口函数整体学一遍,理解了 OVER 和 PARTITION BY 的语义,很多“先分组再 join 回原表”的笨重写法都能一行搞定。
延伸学习
想把分组统计这块系统补齐,可以按这个顺序来:
- 先过一遍 MySQL 入门课程,把查询和聚合基础铺平;
- 查窗口函数语法时翻 MySQL8 教程 看
OVER用法; - 想厘清两者差异,这篇 GROUP BY 与 PARTITION BY 讲得很透,值得延伸阅读。
常见问题
Q:WHERE 和 HAVING 到底有什么区别?
A:作用阶段不同。WHERE 在分组前过滤原始行,不能用聚合结果;HAVING 在分组后过滤“组”,专门用来筛聚合值。要“部门人数大于 5”必须用 HAVING COUNT(*)>5。
Q:为什么 GROUP BY 之后 SELECT 只能写分组列和聚合函数?
A:因为分组会把同组多行压成一行,非分组列在组内可能有多个不同值,数据库不知道取哪一个。要么把它加进 GROUP BY 让它在组内唯一,要么用 MAX、MIN 等聚合函数明确取哪个。
Q:窗口函数会修改原表数据吗?
A:不会。窗口函数只在查询结果里新增一列计算值,原表的行数和内容完全不变。正因为“不折叠行”,它才适合既看明细又看分组汇总的报表场景。



