 TRAE-AI编程

先给结论:批量写 Redis 时真正慢的不是执行命令,而是每条命令的一次网络往返。把 N 条命令装进一个管道一次性发出,往返次数从 N 次降到一次,耗时往往能差一个数量级。前提是别把需要"看结果再决定"的逻辑塞进去,也别指望它替你保证原子性。
很多人第一次用管道是想解决"插入十万条数据太慢",试完之后发现确实快了,但接着就会遇到第二个问题:集群环境下有部分命令报错说跨了槽。这不是管道坏了,而是它的工作方式和事务本来就不同。
本文基于 redis-py 的通用写法与 redis-cli 的常见用法,示例在本地或远程单机实例上都能跑。所有耗时均为预期结果(未在本机执行),实际数字取决于网络时延。适用边界也写清楚:管道与 MULTI、EXEC 是两件事,别混为一谈。
先看结论
- 管道的收益来自往返:省掉的是等待上一次返回的时间,命令本身的执行开销不变。
- 管道不等于事务:它只是把命令打包发送,不保证这组命令之间不被别的客户端插进来。
- 需要原子性就用 MULTI 和 EXEC:它们把一组命令变成一个不可分割的执行单元。
- 批量要大但别太大:一次性塞太多会在客户端堆出巨大的缓冲区,按批次提交更稳。
Redis 的命令语义与返回值格式记不清时,对着 Redis 教程 的命令章节核对最省时间。
一、先把开销的来源讲清楚
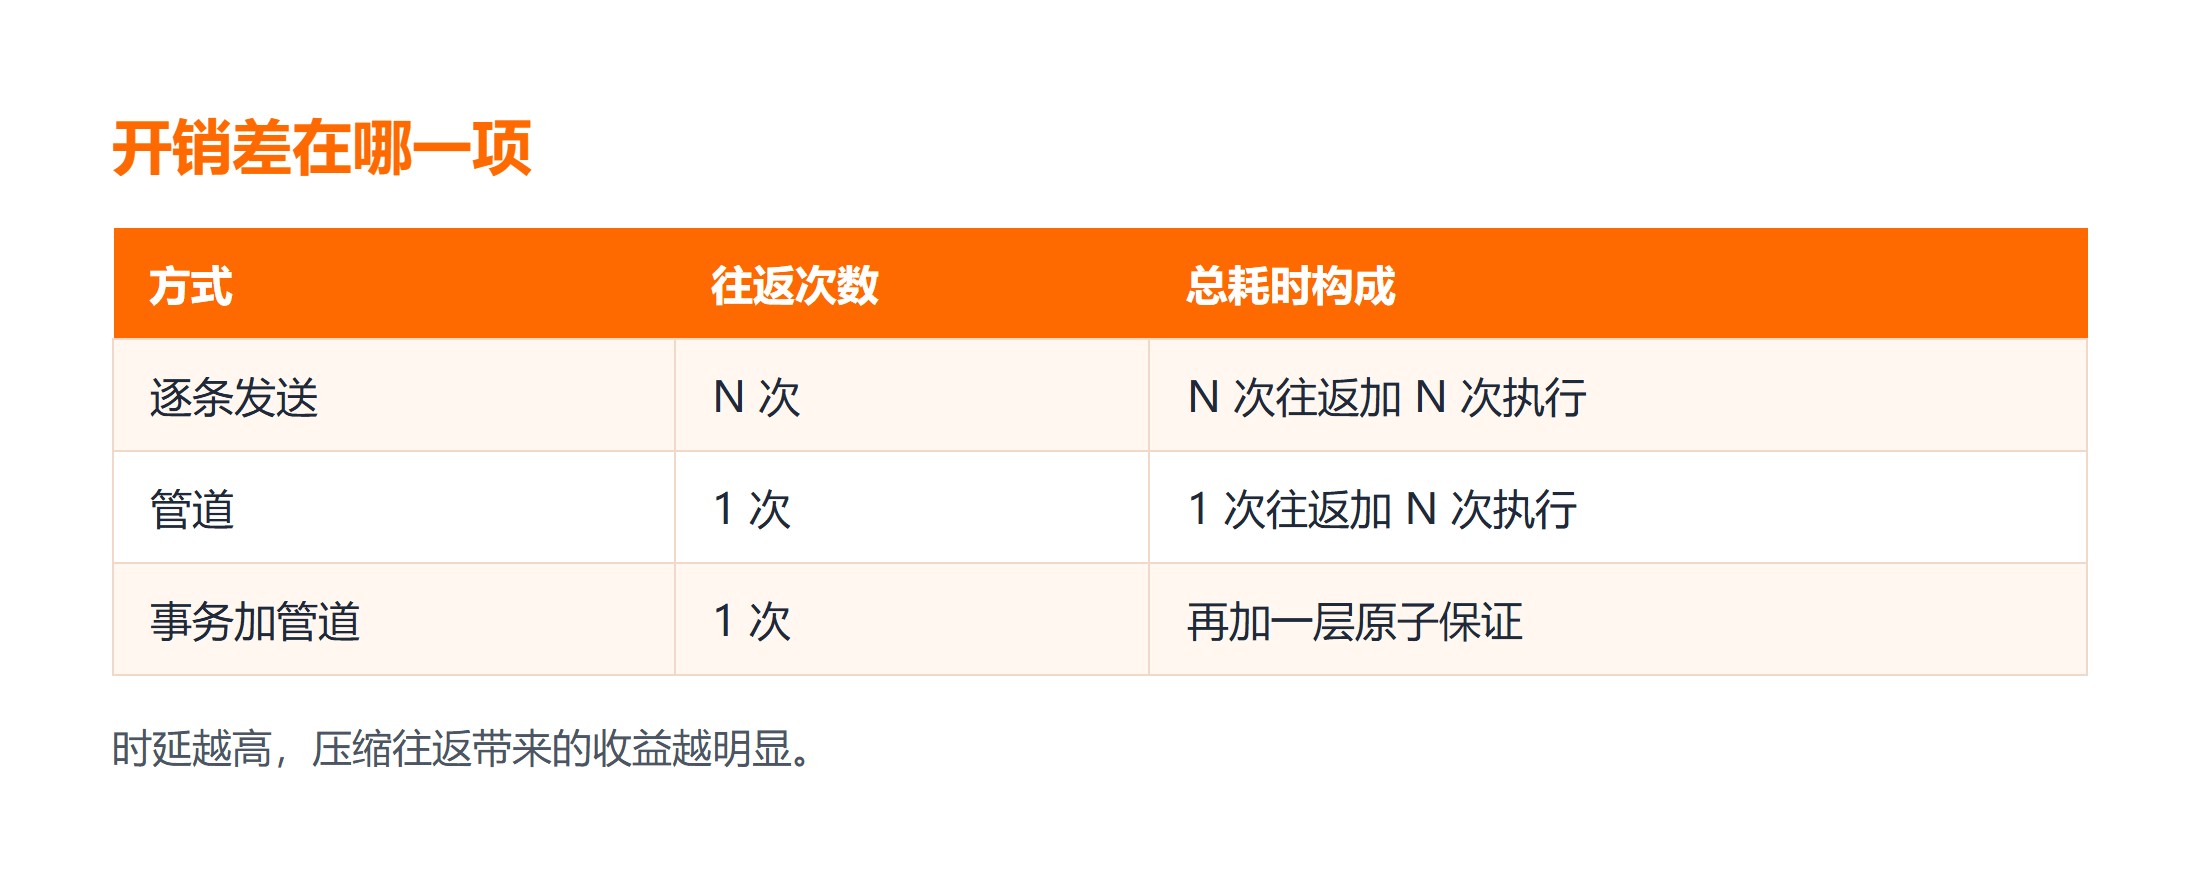
一次命令的完整耗时大致由三部分组成:客户端组包、网络传输、服务端执行再回传。在内网环境里,服务端执行通常是几十微秒量级,而一次往返常常是零点几毫秒起步。
于是逐条写入一千条的耗时约等于:
总耗时 ≈ 1000 × (往返时延 + 单条执行)改成管道之后变成:
总耗时 ≈ 1 × 往返时延 + 1000 × 单条执行 + 打包传输差别就在第一项:往返从一千次变成一次。时延越高,收益越明显——这也是为什么跨可用区访问同一个实例时,管道的提速效果会比本地连高出很多。
反过来说,如果你的瓶颈在服务端执行本身(比如每条都是重计算命令),管道救不了你,这时候要看的是命令选型与数据结构。
二、三种常见写法
Python 客户端里最常见的写法是把命令先排队,最后统一提交:
import redis

r = redis.Redis(host='localhost', port=6379, db=0)

pipe = r.pipeline(transaction=False)
for i in range(1000):
    pipe.set(f'k:{i}', i)
results = pipe.execute()
这段的关键是 transaction=False:它表示只使用管道的网络打包能力,不额外包一层 MULTI 与 EXEC。调用 execute() 时所有命令一次性发出,results 是按发送顺序排列的返回值列表。
需要原子性时把开关打开:
pipe = r.pipeline(transaction=True)
pipe.incr('counter')
pipe.expire('counter', 600)
pipe.execute()
这时客户端会在前后自动加上 MULTI 与 EXEC,整组命令作为一个单元执行,不会被其他客户端的命令穿插。
批量导入历史数据则可以直接用命令行:
printf 'SET k:1 v1\r\nSET k:2 v2\r\n' | redis-cli --pipe预期结果(未在本机执行)是终端汇报一次传输的统计信息。这种方式适合离线灌数据,不适合在线逻辑里调用。
Linux 下的批量管道 usage 记不清时,翻 Linux 速查手册 能快速核对管道的用法。
三、四个踩坑点
坑一:一次塞太多。 客户端会把待发送的命令攒在内存里,几十万条一次性提交会让缓冲区膨胀,还可能长时间占用连接。稳妥做法是分批,比如每一千条提交一次,既能吃到管道收益,也不会把内存顶上去。
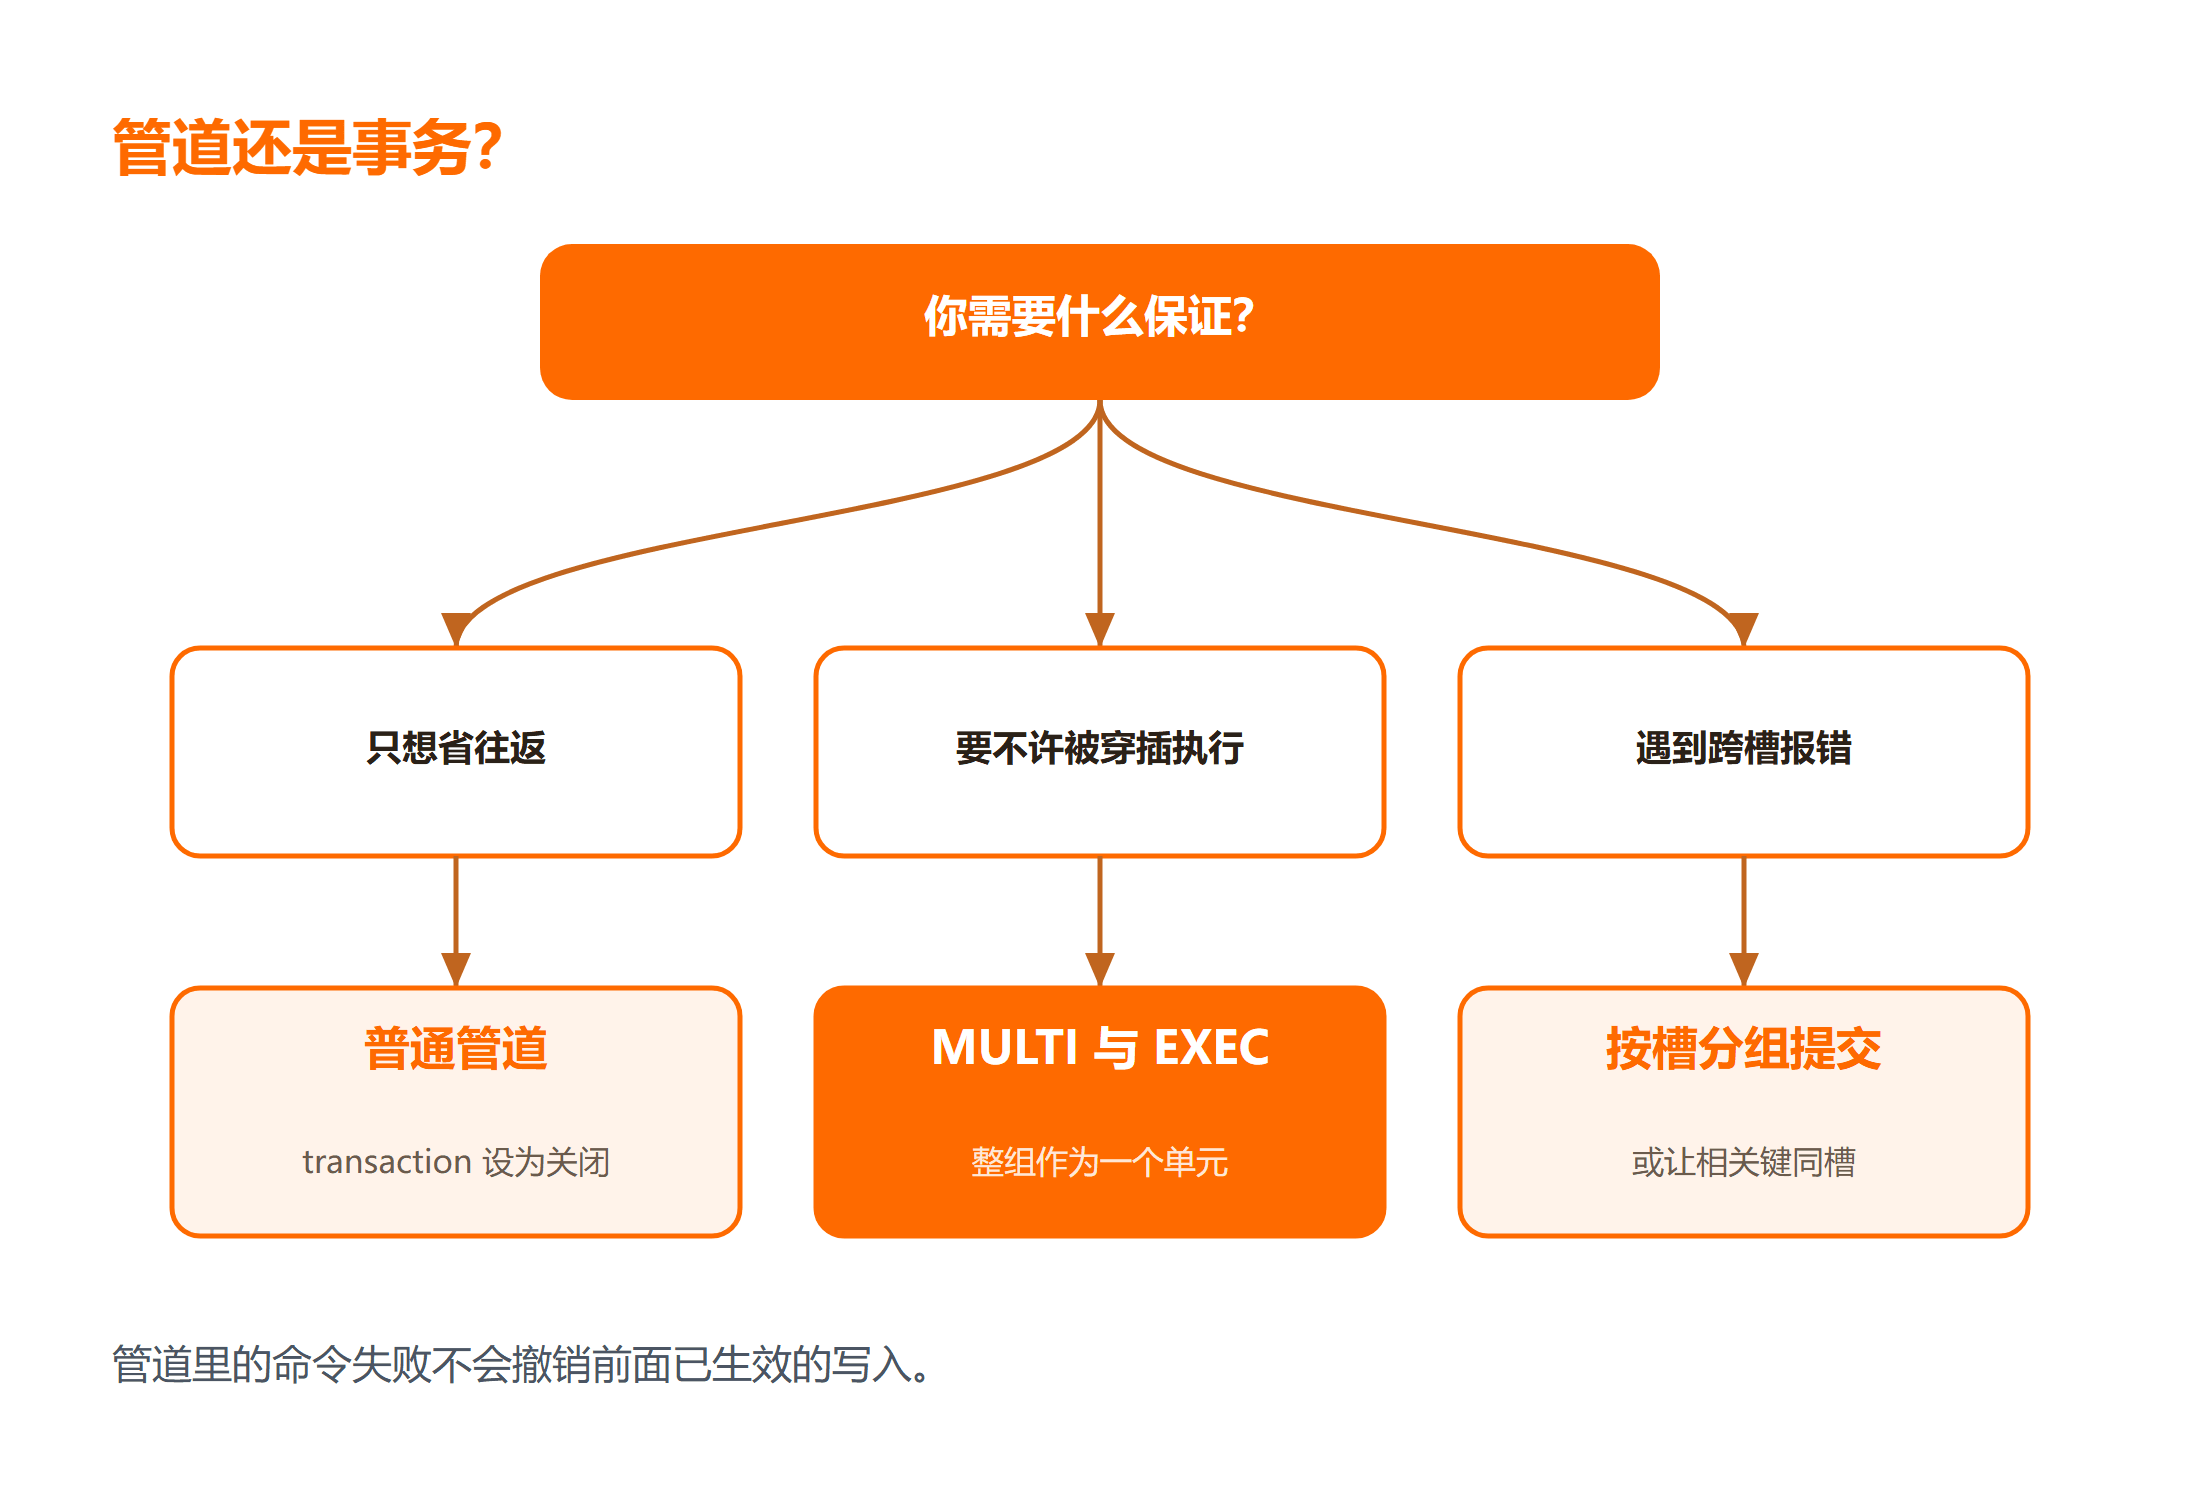
坑二:跨槽。 集群模式下不同键落在不同槽位,一个管道里混了多个槽的命令会被拒绝。处理方式有两种:按槽位分组后再分批发送;或者给相关键设计相同的大括号标签,让它们落在同一个槽位里。
坑三:返回值要按序解析。 execute() 返回的结果顺序与命令入队顺序严格一致,每一项的形态由对应命令决定。如果中间某条命令报错,通常会在对应位置抛出异常或返回错误对象,而不是整体失败。
坑四:没有回滚。 管道里前几条成功、后几条失败是完全可能的,Redis 不会因为后面出错就撤销前面已经生效的写入。需要"要么全成功要么全不做"时,用 MULTI 和 EXEC 明确表达,而不是靠管道。
四、排查顺序与验证清单
把使用管道前的检查固化下来(预期结果,未在本机执行):
- 配置:确认是否需要原子性,不需要就用普通管道,需要显式开启事务;
- 检查:统计一次提交的命令条数,超过数千条就拆成多个批次;
- 运行:分别用逐条和管道两种方式各跑一次写入,记录耗时;
- 预期:管道方式的耗时明显低于逐条,且结果数据与逐条写入完全一致;
- 失败:出现跨槽错误,按槽位分组提交,或调整键名让相关键同槽;
- 失败:内存占用持续上涨,减小单批条数并改为分批提交;
- 修复:涉及"读结果再决定下一步"的逻辑一律从管道里挪出去;
- 验证:用同一种方式读回全部写入的键,逐项比对数量与值。
还有一条经验值是连接数:单个连接串行提交管道已经能打满不少场景,不要为了追求吞吐在客户端并发几十个连接,反而会给服务端带来更大的瞬时压力。
总结
Redis 管道解决的是往返次数的问题,不是原子性,也不是服务端执行速度。
四条带走:
- 收益来自把 N 次往返压成一次,时延越高越明显;
- 管道不保证原子性,要原子性就用 MULTI 与 EXEC;
- 单批别太大,按千条级别分批提交更稳;
- 集群下注意同槽要求,跨槽命令要分组。
下一步建议给批量写入的工具函数加一个批次参数,让调用方能按数据量调整单批大小。
常见问题
Q:管道和事务是一回事吗?
A:不是。管道只负责把命令打包发送以节省往返;事务通过 MULTI 与 EXEC 保证一组命令不被穿插执行,两者可以叠加使用。
Q:一次应该提交多少条?
A:取决于命令体积与网络状况,通常按千条级别分批。关键指标是客户端内存占用与单次响应时间,涨得明显就再拆小。
Q:集群模式下报跨槽错误怎么办?
A:把命令按槽位分组后分批提交,或者给相关的键设计相同的大括号标签让它们落在同一槽位。
Q:管道里的命令失败了会回滚吗?
A:不会。已经执行的写入保持生效。需要全成功或全不做就必须显式使用事务来表达。
Q:为什么用了管道还是很慢?
A:先看瓶颈是不是在服务端执行。每条命令本身很重时,管道省下的往返占比很小,需要从命令与数据结构上优化。
延伸学习
想把批量写入这块做扎实,可以按这个顺序来:
- 想从入门到上手练一遍常用命令,Redis快速入门课程 可以跟一遍;
- 读一篇相关笔记 Redis 缓存怎么加速,看缓存在应用里的位置;
- 想按主题把命令梳理全,翻 Redis 详解 最快。