
 TRAE-AI编程

在 TensorFlow 里处理数据时,经常需要把张量转成 NumPy 数组,好交给 Matplotlib 画图或用 NumPy 的函数做统计。先给结论:张量转 NumPy 最常用的是直接调用张量的 .numpy() 方法;在急切执行(Eager)下它就能拿到数组,在图模式下则要用 Session.run 取值。本文用能运行的最小例子讲清三种方法的用法、什么场景选哪种,以及最常见的报错怎么修。根据文档整理,适用于 TensorFlow 2.x 主流版本,老项目请用兼容接口。三种方法各有适用边界,选错容易踩坑。
一、先理解为什么需要转换
TensorFlow 的张量(Tensor)和 NumPy 的数组(ndarray)是两套东西。张量能参与 GPU 计算和自动求导,NumPy 数组则是科学计算生态的通用格式。两者各有专长,所以经常要互相转换。
转的核心时机是"要把数据拿出计算图、交给别的库用"。比如训练完要画损失曲线,Matplotlib 认的是 NumPy 数组;要统计某个张量的分布,NumPy 的函数更顺手。反过来,把已有的 NumPy 数据喂给模型,用 tf.convert_to_tensor。
要注意内存共享这个细节:.numpy() 返回的数组和原张量共享底层内存,改一个可能影响另一个。需要独立副本时用 .copy()。想补 AI 基础概念,可以翻 AI 人工智能教程 先建立整体认知。
二、方法一:.numpy() 直接转换
这是最简单也是最常用的方式,在默认的急切执行模式下直接调用即可。
import tensorflow as tf
import numpy as np

t = tf.constant([[1, 2], [3, 4]])
arr = t.numpy()
print(type(arr), arr.shape)
# 预期结果(未在本机执行):<class 'numpy.ndarray'> (2, 2)
预期结果(未在本机执行):打印出 numpy.ndarray 类型和 (2, 2) 形状,说明转换成功。这是最推荐的做法,代码最短、语义最清楚。
需要独立副本时加 .copy():
arr_copy = t.numpy().copy()这里有个容易忽略的细节:为什么强调副本?因为 .numpy() 返回的是视图,和原张量指向同一块内存。如果你拿到数组后做了归一化、缩放之类的原地修改,原张量的值也跟着变了,后续再参与计算时结果就偏离预期。养成分副本再改的习惯,能避开一类很难定位的数值 bug。判断是否需要副本很简单——只读不写就不用,要改数据就一定要 copy。
再补充一个常见疑问:字符串张量能转吗?数值类型的张量都能转,但字符串张量的 .numpy() 返回的是字节串数组(dtype 为 object 或 bytes),不是普通的 Python 字符串。要拿到可读文本,得再解码一次。做文本处理时先确认 dtype,别拿到 bytes 数组当字符串用。
运行前检查:确认 TensorFlow 是 2.x 且处于急切模式(默认开启)。如果被关掉了急切执行,.numpy() 会报错,这是最常见的失败。命令与参数记不全时可用 Python 在线运行 边改边看。
三、方法二与方法三:图模式与 Keras 场景
除了 .numpy(),还有两种常见路径,适用于不同场景。下面用一张表先做对比。
| 方法 | 适用场景 | 优点 | 代价 |
|---|---|---|---|
| .numpy() | 急切模式、日常使用 | 最短最直观 | 图模式下不可用 |
| Session.run | 关闭急切执行、TF1 风格 | 图模式可用 | 写法啰嗦 |
| keras 输出直接取 | 模型推理结果 | 通常是 NumPy 或易转 | 依赖具体层 |
方法二:Session.run(图模式)。当急切执行被关闭,张量没有 .numpy() 可用,要通过会话取值:
tf.compat.v1.disable_eager_execution()
t = tf.constant([1, 2, 3])
with tf.compat.v1.Session() as sess:
    arr = sess.run(t)
print(arr) # 预期结果(未在本机执行):[1 2 3]方法三:模型输出直接用。很多 Keras 层的输出本身就是张量,在急切模式下 .numpy() 即可;有些场景下 DataLoader 或 predict 已经返回数组,不必再转。先打印 type 确认类型,别盲目转换。
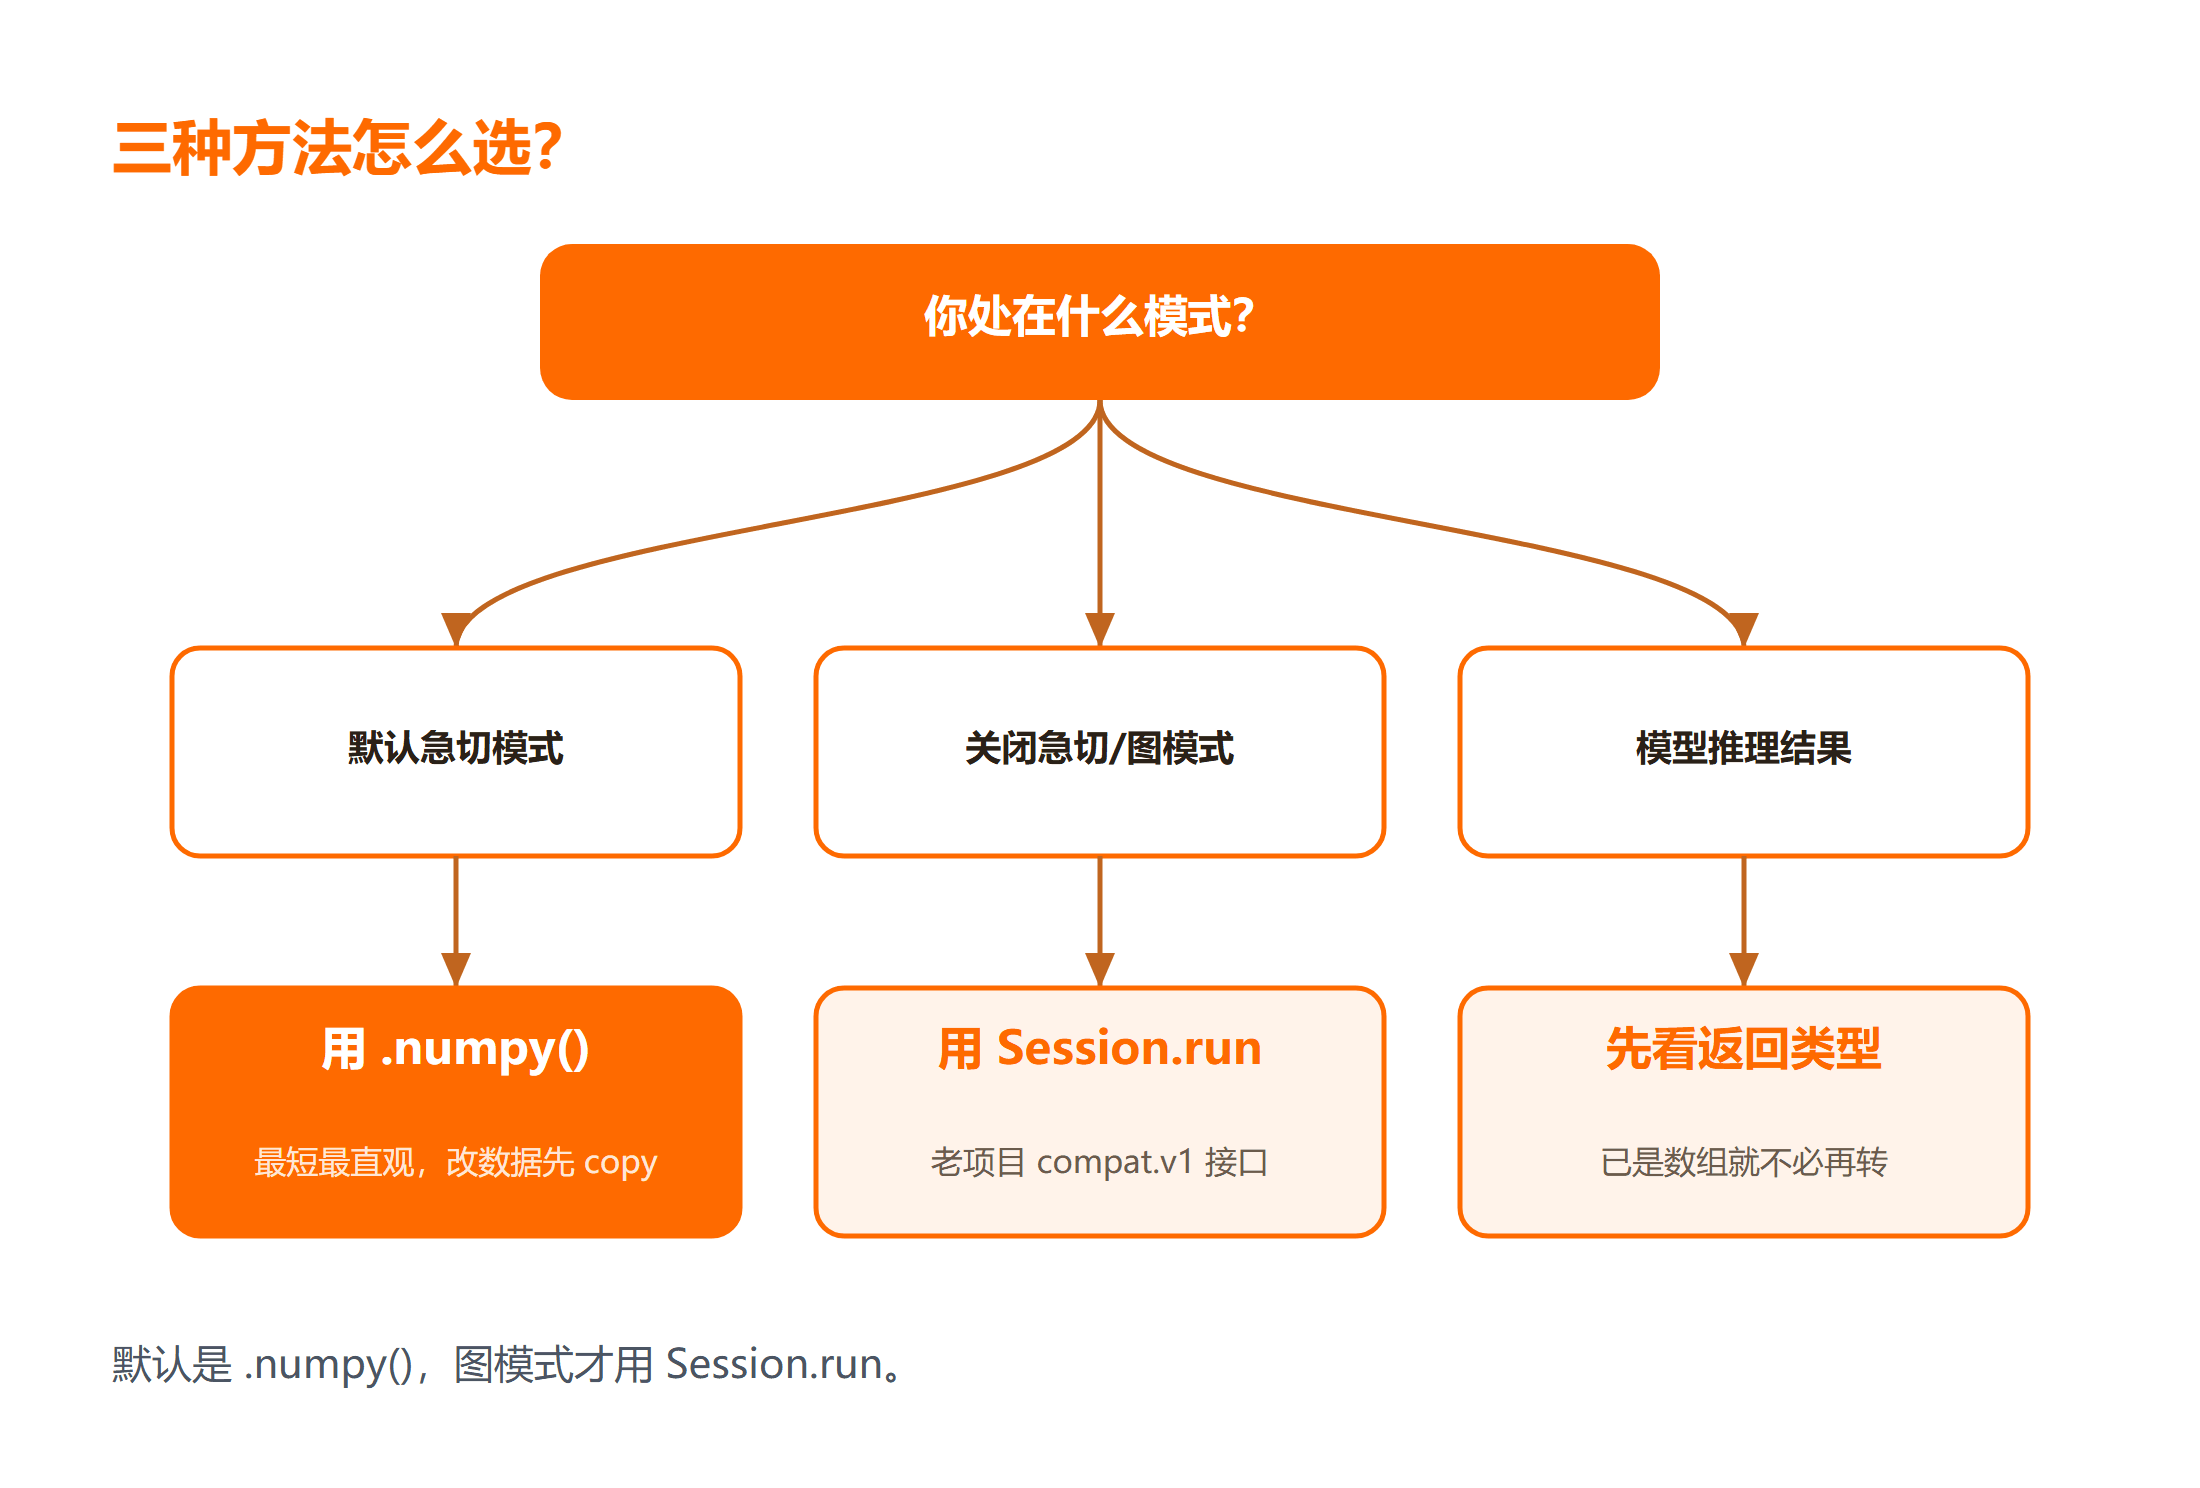
选择建议:默认用 .numpy();维护老项目、图模式下用 Session.run;模型推理先看返回类型再决定。三种方法涉及的 Python 基础语法可查 Python 速查手册 对照。
四、常见报错与适用边界
把转换环节的高频问题集中排查。
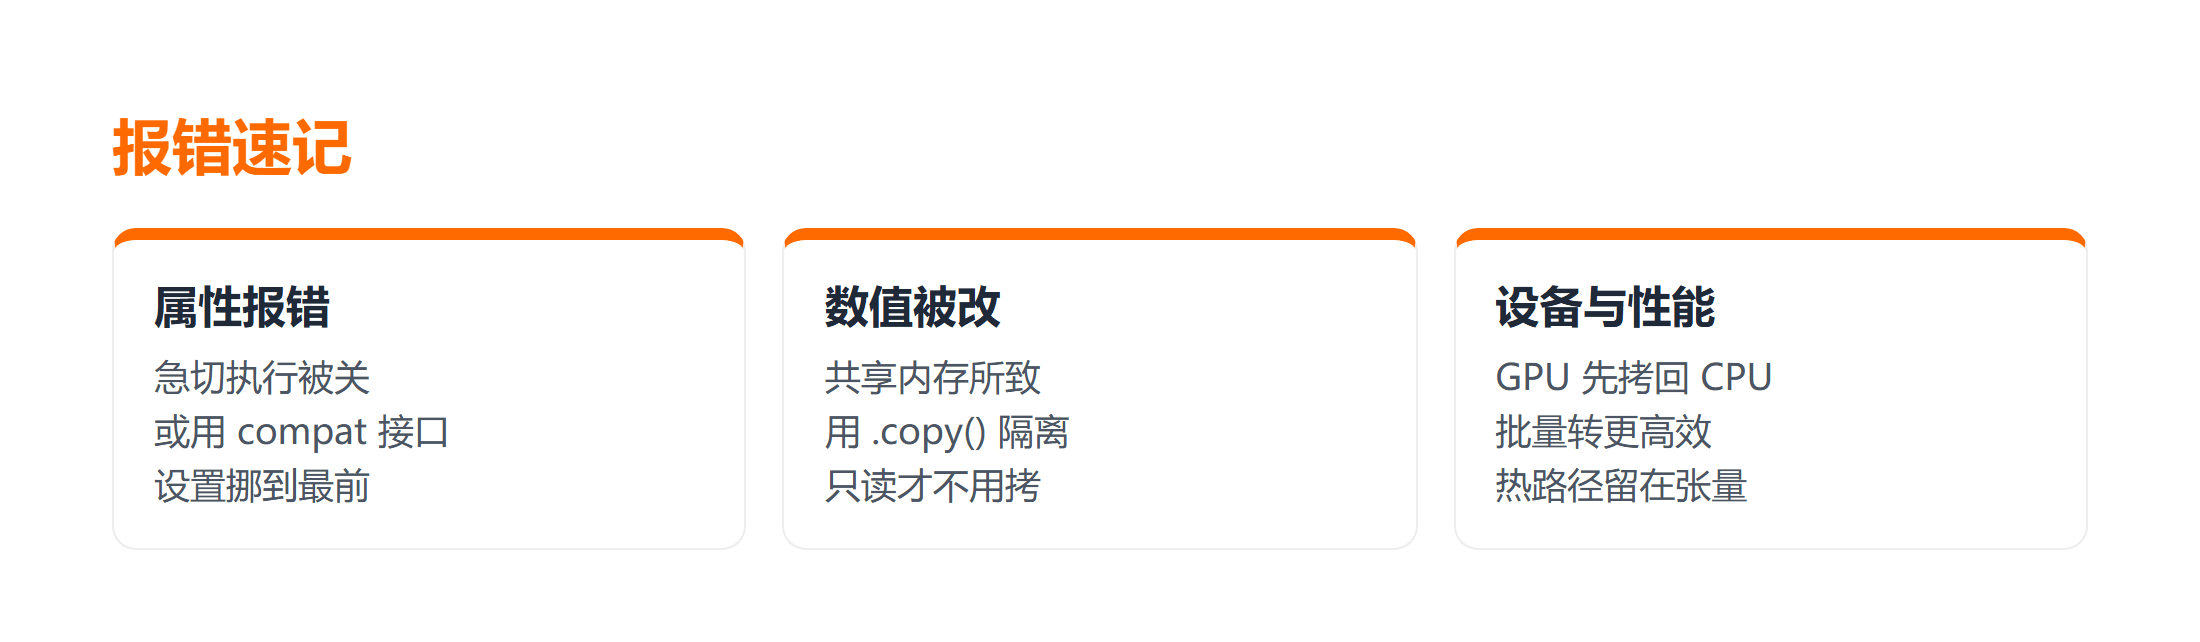
- AttributeError: 张量没有 numpy 属性:急切执行被关掉了。要么重新开启急切执行,要么改用 Session.run 取值。
- GPU 张量转不了:某些情况下 GPU 上的张量要先拷回 CPU。用tf.cpu() 或 .cpu().numpy() 处理,别直接对 GPU 张量调 .numpy() 失败就以为不支持。
- 改了数组张量也变了:这是内存共享的正常现象。要独立副本就用 .copy(),这是容易被忽略的边界。
- dtype 不一致:转换不会改变数值类型,float32 的张量转成数组还是 float32。要 float64 得显式 astype。
- 性能与适用边界:转换会在 CPU 和 GPU 之间搬数据,大张量频繁转换开销不小。训练热路径里尽量留在张量计算,只在必要时转出。批量转换比逐个转更高效——把多个小结果拼成一个大批次再一次性 .numpy(),比在循环里逐个转换快得多,也更省显存调度开销。
- 版本与适用边界:TensorFlow 1.x 默认图模式,2.x 默认急切模式,跨版本写法不同。本文以 2.x 为主,老项目用 compat.v1 兼容接口。想看更多 AI 概念可翻 人工智能 Overview Of AI And Artificial Intelligence。
⚠️ 注意:转换不是无损万能操作——急切模式限制、内存共享、设备位置都会影响结果。转之前先想清楚"数据要去哪、要不要独立副本",比盲目 .numpy() 更靠谱。
总结
把 TensorFlow 张量转成 NumPy 数组,默认用 .numpy() 最简单;图模式下要用 Session.run;模型推理先确认返回类型再决定要不要转。三个边界要记牢:急切模式关掉会报没有 numpy 属性、数组与张量共享内存要用 copy 隔离、GPU 张量要先拷回 CPU。大张量频繁转换有开销,尽量只在必要时转出。
要点带走:
- 默认急切模式用 .numpy();
- 图模式用 Session.run;
- 共享内存用 copy 拿独立副本;
- 大张量少转换,训练热路径留在张量里。
常见问题
Q:调用 .numpy() 报 AttributeError 怎么办?
A:多半是急切执行被关掉了,常见于 TF1 风格代码。要么重新开启急切执行,要么改用 tf.compat.v1.Session().run() 取值。
Q:改了 NumPy 数组,原张量也跟着变了?
A:因为它们共享底层内存。需要互不影响的独立副本时,用 .numpy().copy() 再操作。
Q:GPU 上的张量能直接 .numpy() 吗?
A:通常要先拷回 CPU,用 .cpu().numpy() 更稳。直接对 GPU 张量调用失败时,先确认设备位置再处理。
延伸学习
- 想系统补 Python 基础,可以了解 Python 零基础到高薪就业;
- 想看 NumPy 与机器学习配合的经验,翻 人工智能和机器学习系列(八) NumPy、TensorFlow 和 scikit-learn 这篇笔记;
- 想动手试不同写法,可以用 Python代码格式化 工具整理代码。



