 TRAE-AI编程

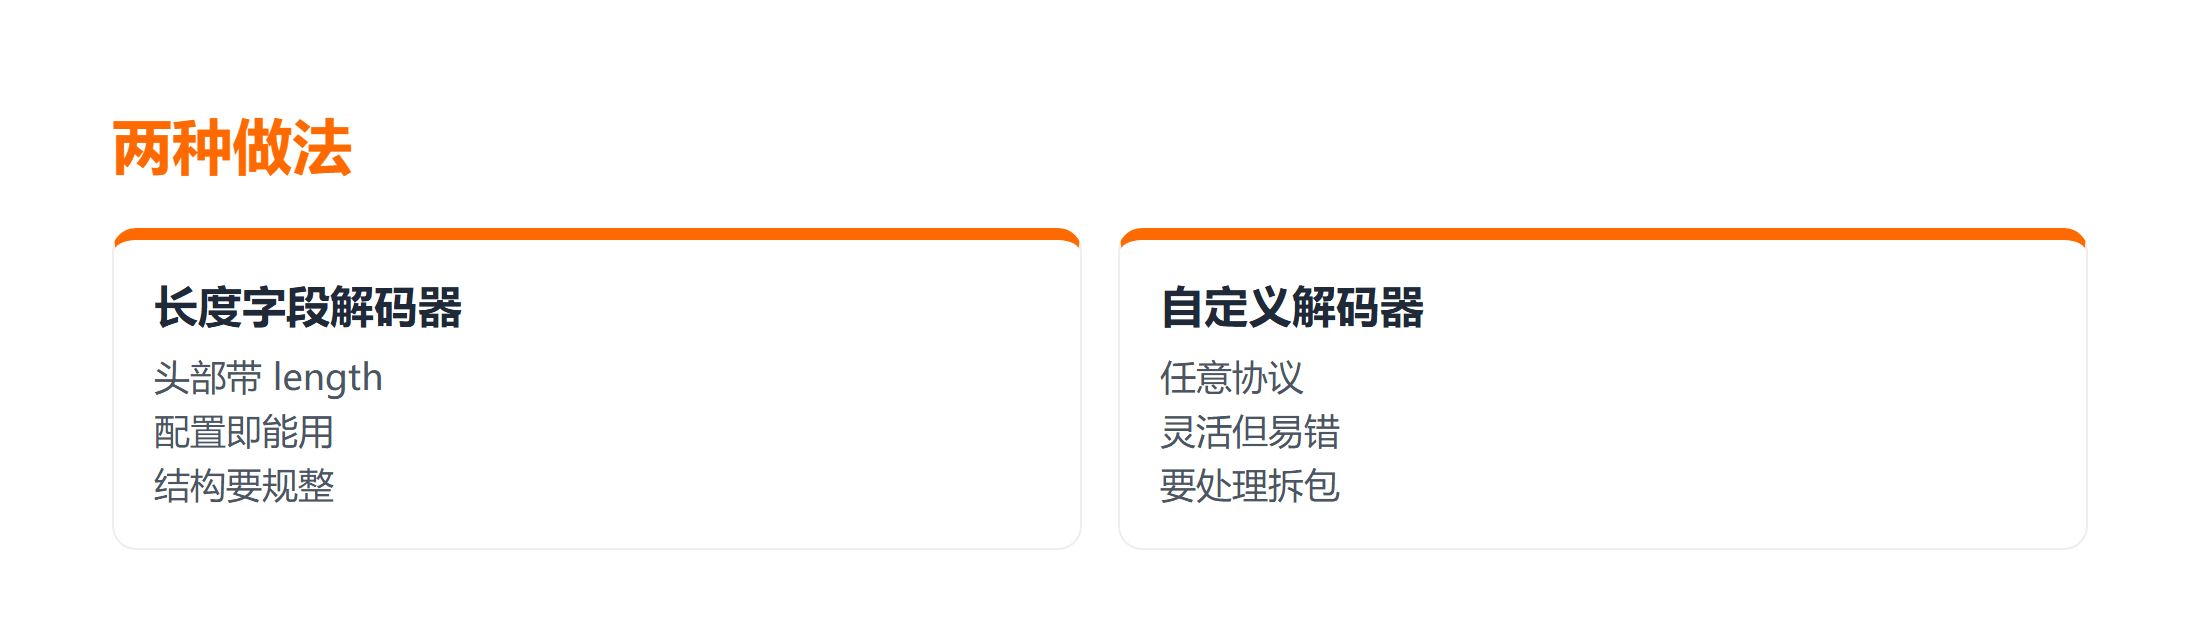
直接回答:所谓「动态编解码」不是换一套 API,而是在运行时根据消息类型、长度或协议状态,挑出正确的解码器来用。常见做法是长度字段定帧、自定义 ByteToMessageDecoder 按首字节分发,以及在 ChannelPipeline 里热插拔解码器。选哪种,取决于你的报文是不是同一种布局。
很多人一上来就把所有协议细节塞进一个解码器,结果越写越像一团 if-else。其实 Netty 已经把「粘包拆包」和「按帧切分」这两件最麻烦的事拆成了可复用的组件,你只需要把「怎么判断这一帧该用什么规则」这件事讲清楚。Netty 自带的 LengthFieldBasedFrameDecoder 负责按长度把字节流切成整帧,ByteToMessageDecoder 则允许你自定义切帧逻辑,两者配合就能覆盖绝大多数动态编解码需求。
先看结论
- 报文布局固定、只在头部带长度,用
LengthFieldBasedFrameDecoder最省心,几乎不用写代码。 - 报文类型混杂、首字节决定含义,写自定义
ByteToMessageDecoder按类型分发最清晰。 - 连接会在不同协议状态间切换,靠
ChannelPipeline动态增删解码器处理器更合适。 - 无论哪种做法,半包都要留到下次累积,不能因为「差几个字节」就抛异常中断连接。
回到 Netty 编解码本身,三者的取舍核心就是「复杂度」与「灵活度」的权衡:越简单的布局越该用现成组件,越混杂的语义才值得自己写解码器。
一、先搞清楚「动态」到底动态在哪
Netty 编解码的难点从来不是把一个对象转成字节,而是 TCP 是流式传输,你收到的 ByteBuf 可能半个包、一个半包、甚至好几包粘在一起。这就是常说的「粘包拆包」。解码器的本职工作是把这串字节流,稳定地切成一条条完整的应用消息。
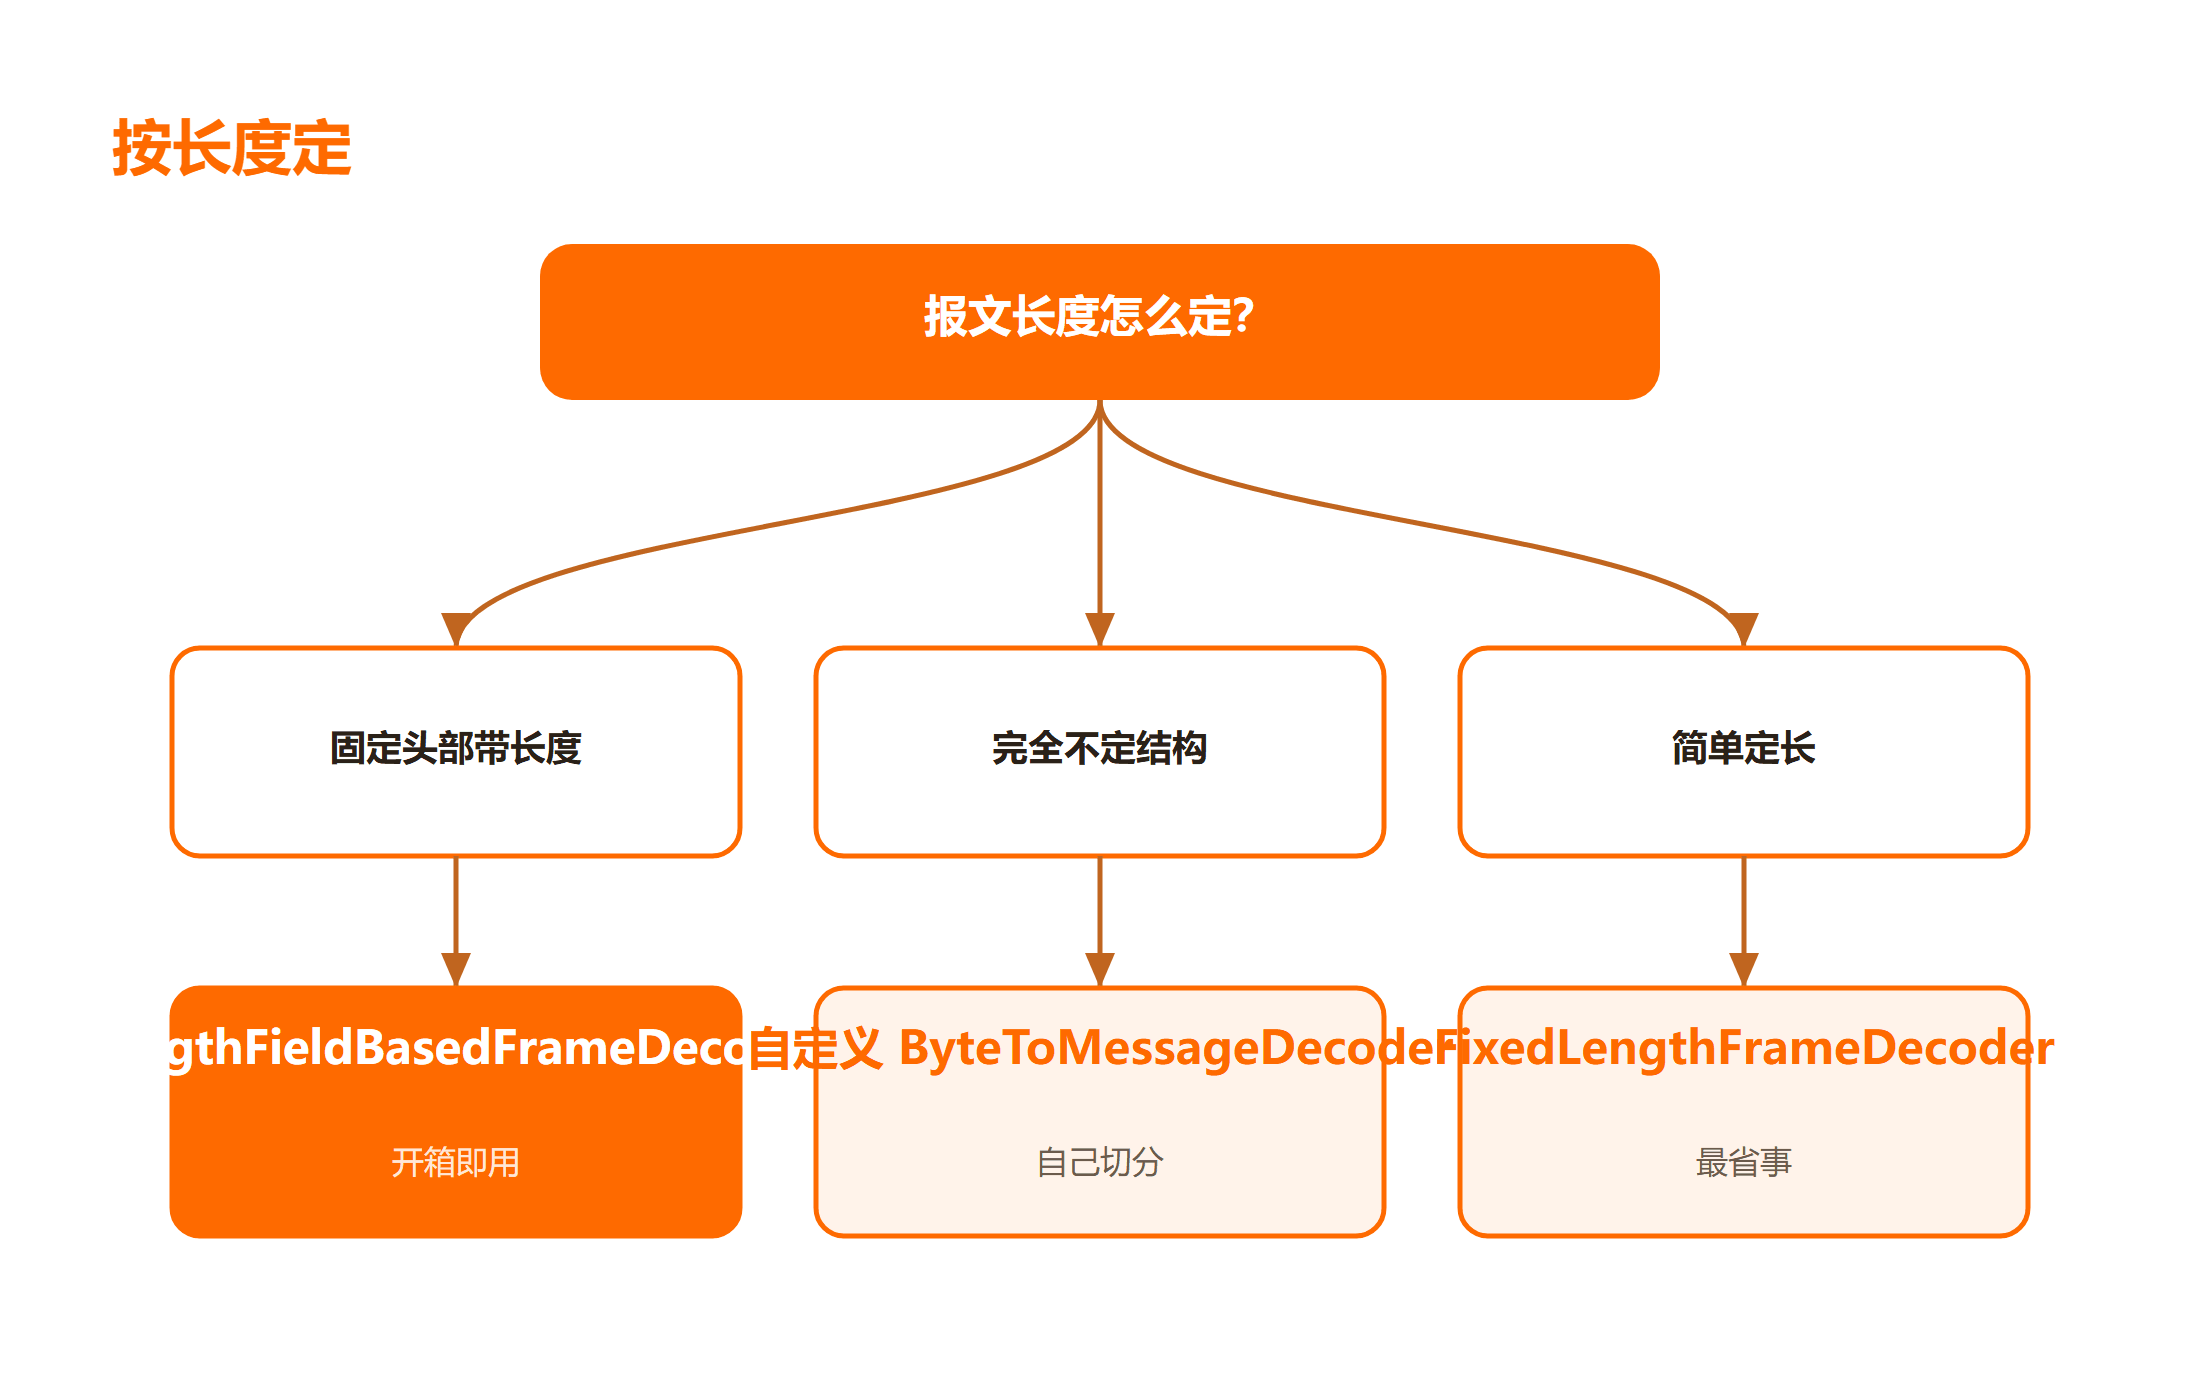
「动态」指的是:同一条连接上,不同消息要用不同规则解读。比如登录帧是定长,业务帧是「类型 + 长度 + 体」,推送帧又是另一种头部。下面这张决策图帮你先判断该走哪条路。
如果你的报文全部是同一种布局,先读 Netty 4 用户指南 里关于 ChannelHandler 的章节,理解入站事件是怎么一层层流过来的,再往下看会顺很多。
1.1 固定布局:长度字段定帧
最简单也最稳妥的场景:每条消息前面固定放几个字节表示后续 body 长度。在做 Netty 编解码时,内置的 LengthFieldBasedFrameDecoder 就是干这个的,你只要声明长度字段的偏移和字节数,它自动帮你把一帧切出来,后面的业务解码器拿到的永远是一帧完整数据。
1.2 混杂布局:首字节决定类型
当消息头部第一个字节是「消息类型」时,长度字段的位置、体结构都随类型变化。这时固定长度字段不够用,需要在解码器里先读出类型,再按类型决定怎么读剩下的字节。
1.3 状态切换:Pipeline 热插拔
更极端的场景:连接建立后先走握手协议,握手成功才切换到业务协议。这种「先 A 后 B」的状态切换,适合在握手完成后动态替换 ChannelPipeline 里的处理器,而不是在一个解码器里硬塞两套逻辑。
二、做法一:LengthFieldBasedFrameDecoder 定帧
这是动态长度场景下性价比最高的选择。它只负责「切帧」,把切好的整帧交给下游解码器,你自己写的业务解码器就永远拿到完整的一帧。
import io.netty.buffer.ByteBuf;
import io.netty.channel.ChannelInitializer;
import io.netty.channel.socket.SocketChannel;
import io.netty.handler.codec.LengthFieldBasedFrameDecoder;

public class DynamicLengthInitializer extends ChannelInitializer<SocketChannel> {
    @Override
    protected void initChannel(SocketChannel ch) {
        // 参数:最大帧长、长度字段偏移、长度字段字节数、长度修正、剥离字节数
        ch.pipeline().addLast(new LengthFieldBasedFrameDecoder(
                1024 * 1024,  // maxFrameLength
                1,            // lengthFieldOffset:跳过首字节类型
                4,            // lengthFieldLength:长度占 4 字节
                0,            // lengthAdjustment
                5));          // initialBytesToStrip:剥离类型和长度字段
        ch.pipeline().addLast(new BusinessDecoder());
    }
}
上面这段做的是声明一个基于长度字段的定帧解码器,并在初始化时把它接在流水线最前面。它会在读够「1 字节类型 + 4 字节长度 + 对应 body」之后,才把一帧交给后面的 BusinessDecoder。
正常输出描述:客户端连续发送两条消息时,即使 TCP 把它们粘成一个 ByteBuf,LengthFieldBasedFrameDecoder 也会各自切出两帧,下游 BusinessDecoder 被调用两次,每次拿到的都是一条完整消息,不会出现半包误判。
失败分支及处理:如果把 lengthFieldLength 写成了 2,但发送方实际发的是 4 字节长度,解码器读到的长度会错得离谱,进而触发 TooLongFrameException(超过 maxFrameLength)。处理方式是先核对收发双方的长度字段字节数约定,必要时在 BusinessDecoder 里加一道「长度上限 + 黑名单类型」的校验,而不是放任异常一路冒泡把连接断开。
想补齐 TCP 层为什么会出现粘包的基础认知,可以翻 TCP/IP 协议栈 的传输层部分,理解字节流的本质。
落地时先配置好长度字段参数,再写一段最小用例运行它,检查粘包是否被正确切成两帧;预期下游解码器被调用两次且每次都是整帧。若仍出现半包误判,回到 1.1 核对长度字段偏移与字节数来修复。
三、做法二:自定义 ByteToMessageDecoder 按类型分发
当首字节就是消息类型、每种类型的体结构都不一样时,LengthFieldBasedFrameDecoder 不够用了,因为它假定「长度字段位置固定」。这时要自己写一个 ByteToMessageDecoder,先读 1 字节类型,再按类型读长度与体。
import io.netty.buffer.ByteBuf;
import io.netty.channel.ChannelHandlerContext;
import io.netty.handler.codec.ByteToMessageDecoder;
import java.util.List;

public class TypeDispatchDecoder extends ByteToMessageDecoder {
    @Override
    protected void decode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) {
        if (in.readableBytes() < 5) {
            return; // 半包:等下次累积,不抛异常
        }
        in.markReaderIndex();
        byte type = in.readByte();
        int len = in.readInt();
        if (in.readableBytes() < len) {
            in.resetReaderIndex(); // 体还没到齐,退回等下一次
            return;
        }
        byte[] body = new byte[len];
        in.readBytes(body);
        out.add(new Message(type, body));
    }
}
上面这段做的是先确认缓冲区至少有「1 字节类型 + 4 字节长度」,读出类型后按长度判断体是否到齐;没到齐就 resetReaderIndex 退回、留到下次 decode 再处理。这正是处理动态长度时最关键的一步:宁可多等一次,也不能在半包上强行解码。
正常输出描述:收到类型 0x01、长度 8、体 8 字节的一帧时,decode 产出一条 Message(0x01, [...]),交给下游业务处理器;再收到 0x02 类型的一帧,同样整帧产出,类型不同走不同业务逻辑。
失败分支及处理:如果读到的 type 是协议里未定义的取值(比如 0xFF),继续往下解析会产生错乱的数据对象。正确做法是 in.resetReaderIndex() 后直接 ctx.close() 或抛出明确协议异常并记录日志,避免用一个无法识别的类型污染后续整条流。
Socket 编程里「读多少才算够」的坑在 Socket 编程基础 里也有类似的讨论,思路是相通的。
四、做法三:ChannelPipeline 动态热插拔
当协议是「先握手、后业务」这种有状态切换时,把两套解码逻辑硬塞进一个 ByteToMessageDecoder 会让代码迅速腐化。更干净的做法是:先在 ChannelPipeline 里只放握手解码器,握手成功后再 pipeline.addLast(...) 业务解码器、pipeline.remove(...) 握手解码器。
// 握手处理器里,校验通过后切换协议
public class HandshakeDecoder extends ByteToMessageDecoder {
    @Override
    protected void decode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) {
        if (in.readableBytes() < 4) return;
        int magic = in.readInt();
        if (magic != 0xCAFEBABE) {
            ctx.close(); // 握手失败,直接关连接
            return;
        }
        // 握手成功:热插拔到业务协议
        ctx.pipeline().addLast(new BusinessDecoder());
        ctx.pipeline().remove(this);
    }
}
上面这段做的是握手通过后用 addLast 挂上业务解码器,并用 remove(this) 把自己从流水线摘掉,后续字节就由业务解码器接管。这种「按状态换解码器」的方式实现了真正的动态编解码,且每种解码器职责单一。
总结
Netty 编解码的核心不是魔法,而是「把判断权交给运行时」:先用内置组件解决最通用的定帧问题,再用自定义解码器处理混杂类型,最后用 Pipeline 热插拔应对协议状态切换。
要点带走:
- 报文布局统一带长度,优先用
LengthFieldBasedFrameDecoder,别重复造轮子; - 类型混杂时,
ByteToMessageDecoder里先读类型、按长度等整帧到齐,半包必须退回; - 协议有握手/业务的状态切换,用
ChannelPipeline动态增删处理器比硬写 if 更清爽; - 任何解码器遇到识别不了的数据都要显式处理,不能让异常悄悄断掉连接。
常见问题
Q:LengthFieldBasedFrameDecoder 和自定义解码器怎么选?
A:只要长度字段位置固定、体结构一致,就直接用前者,零代码维护成本。只有首字节决定类型、体结构随类型变化时,才需要自定义 ByteToMessageDecoder。
Q:decode 里发现半包为什么不能直接抛异常?
A:TCP 流式传输天然会把消息切碎重组,半包是常态而非错误。正确做法是 return 或 resetReaderIndex 等下一次累积,抛异常会误杀正常连接。
Q:动态长度字段如果长度写错了会怎样?
A:解码器读出的长度会偏离真实值,轻则读出垃圾数据,重则触发 TooLongFrameException 关闭连接。务必在收发双方把长度字段的字节数和字节序约定死,并加上上限校验。
Q:Pipeline 热插拔会有线程安全问题吗?
A:Netty 保证同一个 Channel 的事件在同一个 EventLoop 线程串行执行,所以在 decode 里直接 addLast/remove 是安全的,但要注意别在别的线程里并发改同一条 pipeline。
Q:粘包拆包一定要自己处理吗?
A:不必。Netty 提供了 LengthFieldBasedFrameDecoder、LineBasedFrameDecoder、DelimiterBasedFrameDecoder 等现成方案,绝大多数场景直接用它们即可,自定义只作为补充。
延伸学习
想沿着这条线继续深入,可以按这个顺序:
- 系统过一遍框架,Netty 实战教程 从引导到处理器生命周期讲得很完整;
- 概念想再落地,读一篇相关笔记 Base64 编解码笔记;
- 写报文前先验证编码,可以用 在线编解码工具 比对字节是否正确。