 TRAE-AI编程

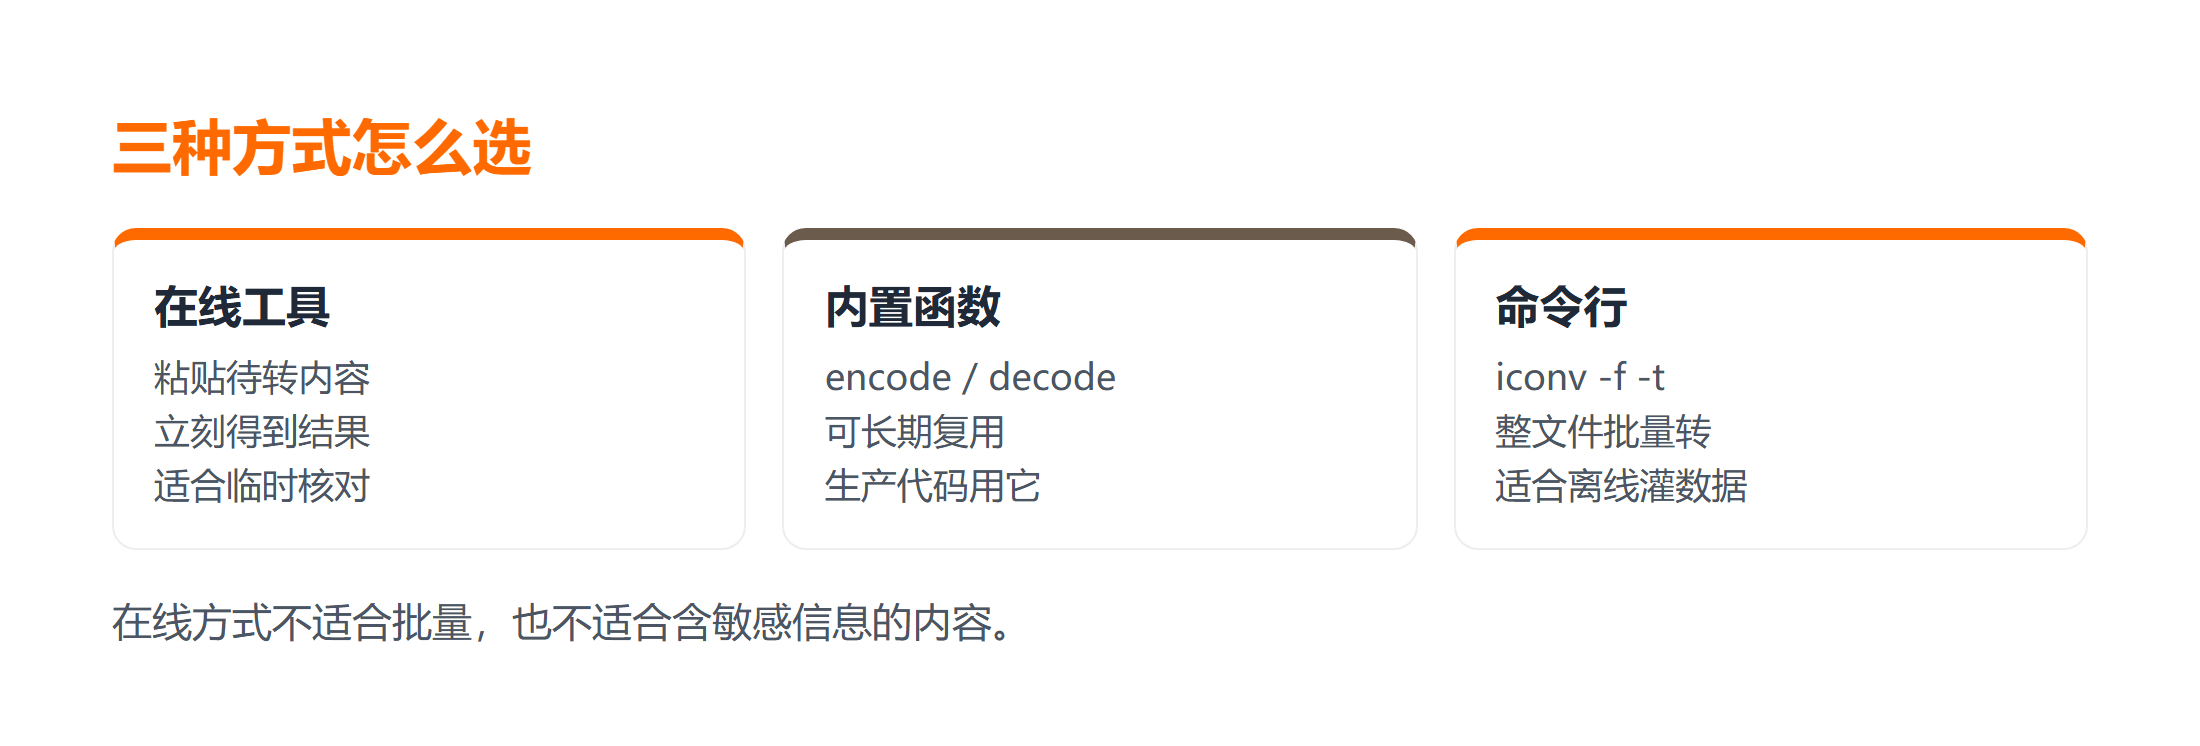
先给结论:想知道 \u4e2d\u6587 到底是哪几个字,用在线工具最快;要嵌进脚本或接口里长期用,用语言内置的编解码函数;只有当你需要搞清楚原理时才动手写转换逻辑。三种方式对应三种场景,混用会让你在调试时多花一倍时间。
为什么值得专门讲:编码转换的报错几乎从不说"我编码错了",它只会给你一堆看不懂的字符。接口返回一串反斜杠加 u 的组合、日志文件打开全是问号、URL 里出现百分号加两位十六进制——这些是同一件事的三个不同面。
本文基于 UTF-8 作为默认编码的现代环境,覆盖中文与 Unicode 互转、UTF-8 字节序列、以及它们与 Base64 的区别。文中的所有输出均为预期结果(未在本机执行),读者需要自己跑一遍核对。
先看结论
做编码转换之前先明确目标:你要的是转义文本、字节序列,还是另一种字符集。三者做法完全不同。
- 临时看一眼:在线转换工具,粘贴即出结果,不用装任何东西。
- 写进代码里:用语言内置的编码与解码函数,不要自己拼字符串。
- 排查乱码:先确认"写入时用的一套编码"和"读取时用的另一套"分别是谁,再针对性转换。
- Base64 不等于编码转换:它解决的是二进制在文本通道里传输的问题,不改变字符集含义。
语言内置的编码接口细节,可以对着 Python3 教程 里的字符串与字节序列章节过一遍。
一、先分清三个容易混的概念
字符集与编码规则。 Unicode 是一张给每个字符编号的大表,中文的"中"编号是 U+4E2D。UTF-8 是这套编号在存储时的一种编码方式,它把 U+4E2D 编成三个字节。日常说"Unicode 编码"时,多数人指的是 \u4e2d 这种转义写法,而不是 UTF-8 字节。
转义字符串。 接口里常见的 \u4e2d\u6587 是把编号写成文本形式,方便在只支持 ASCII 的通道里传输。它本身仍是普通文本,只是被写成了一串反斜杠和数字。
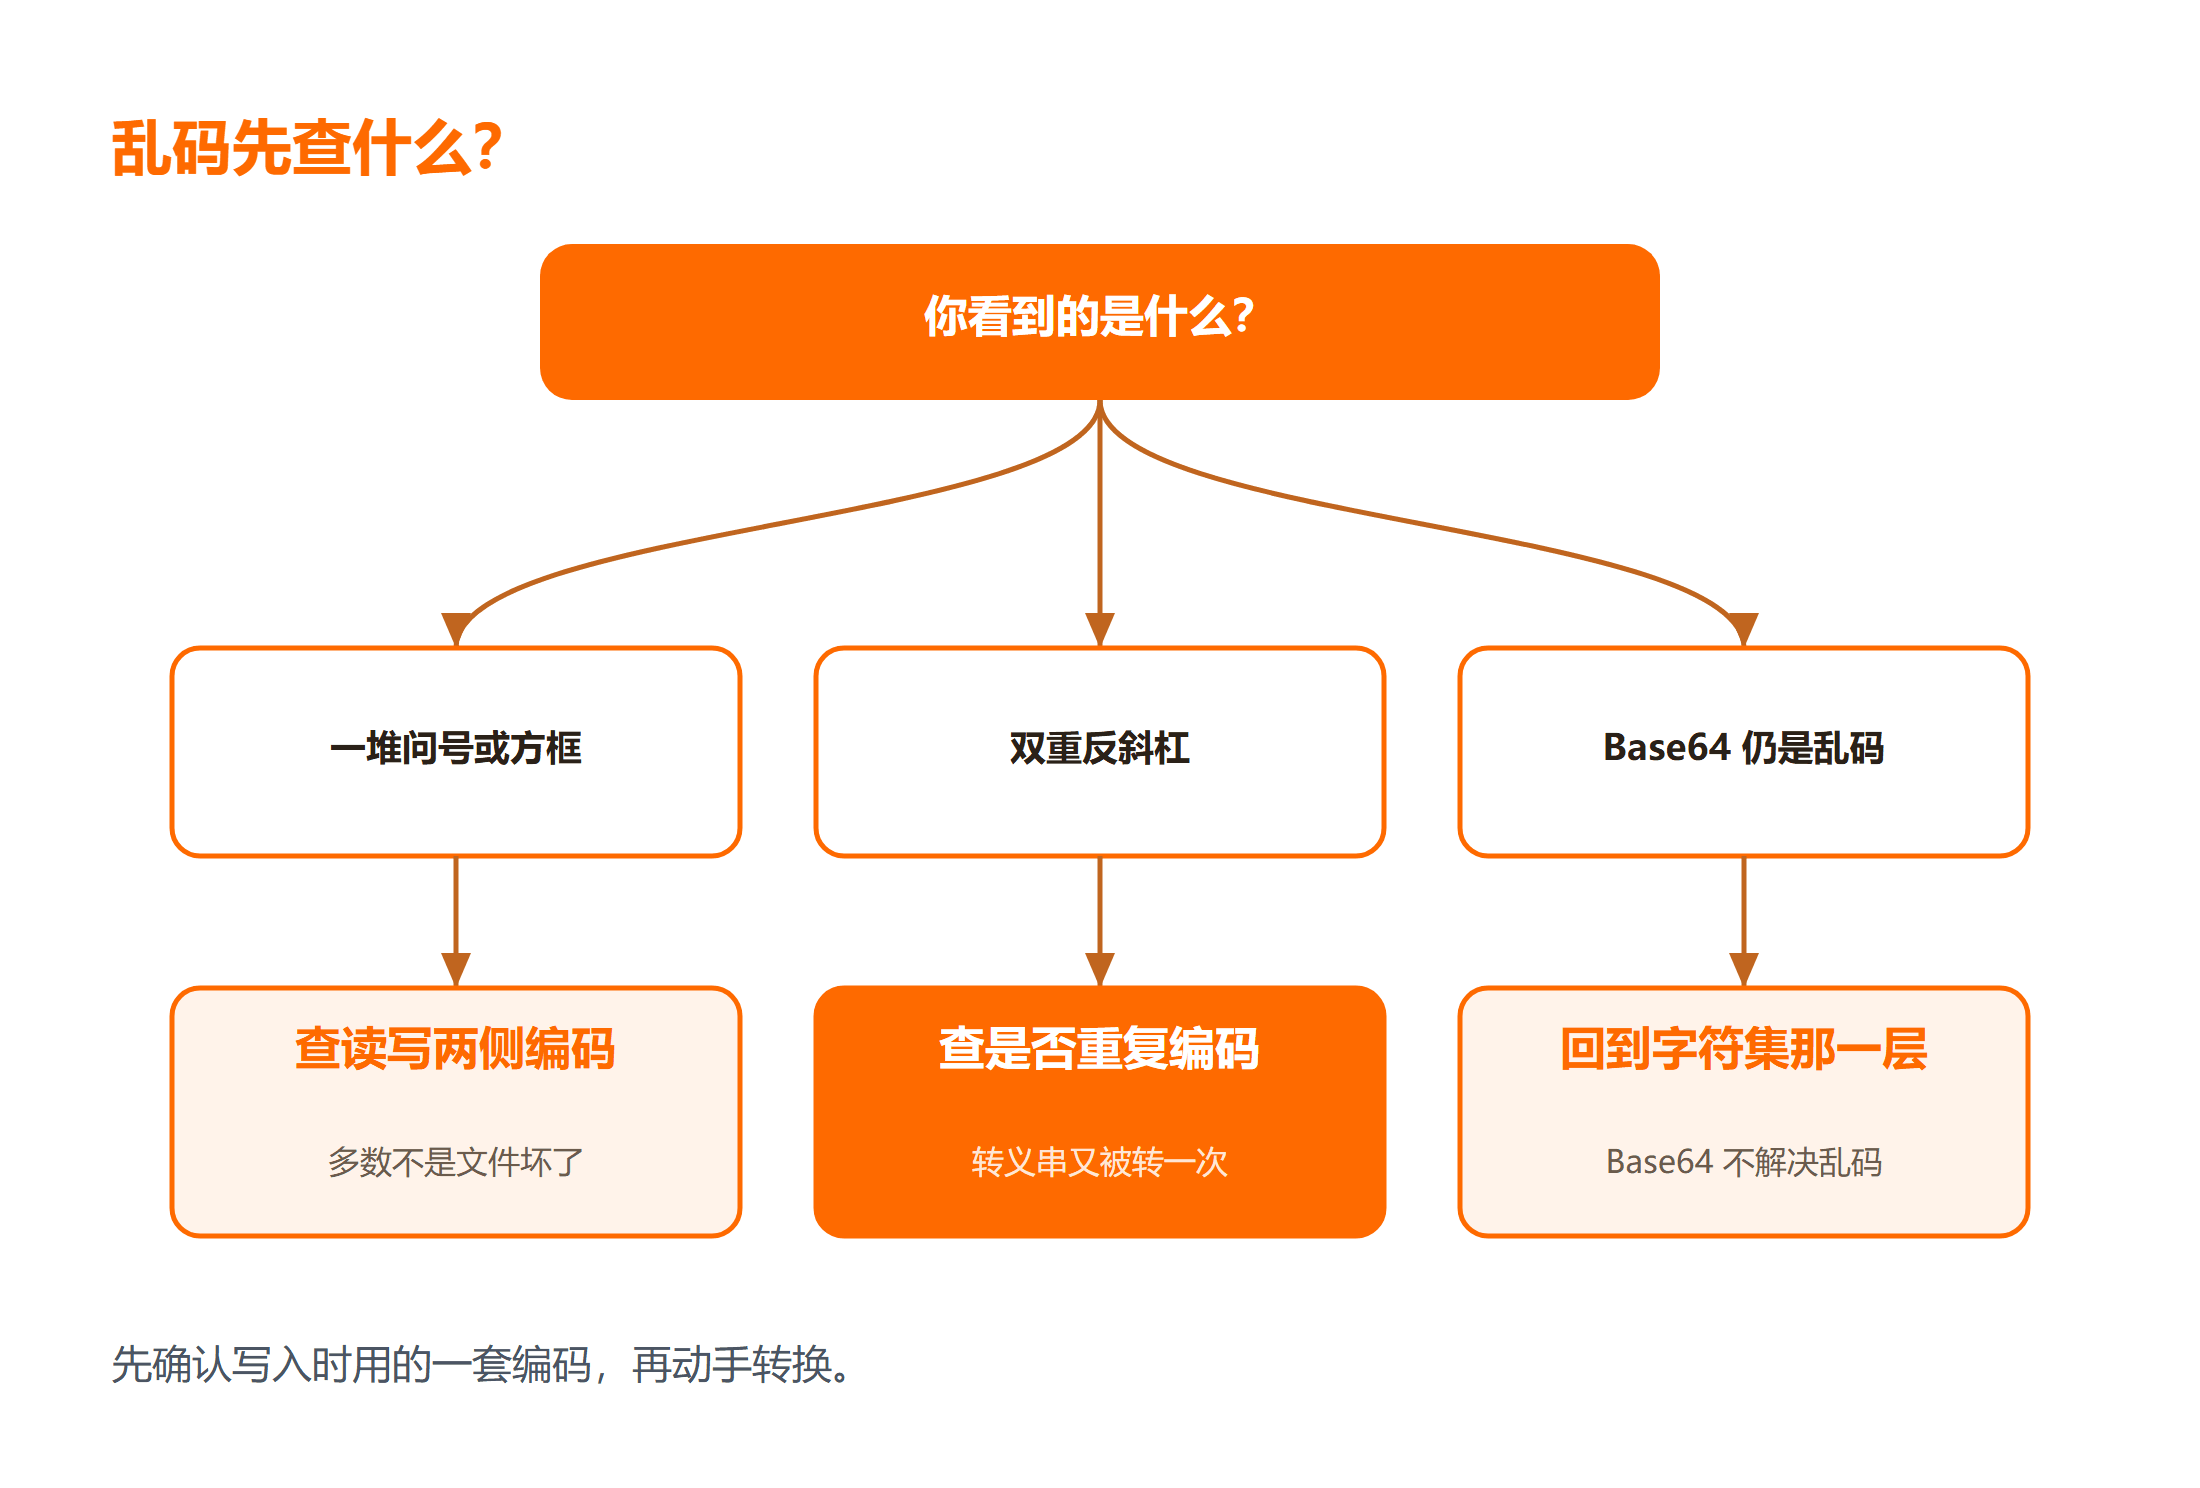
Base64。 把任意字节序列映射成可打印字符,用来在只接受文本的通道里搬运二进制。它不关心里面是中文还是图片,因此不要指望用 Base64 来解决乱码。
把这三件事分清之后,"为什么我转了 Base64 还是乱码"这种问题自然就消失了——因为乱码的成因在字符集那一层,不在传输编码这一层。
二、第一种:在线工具,适合临时核对
临时核对是编码转换里最常见的一类需求。,把待转换的内容粘进去,立刻得到原文或转义串。适合两类场景:接口日志里出现一串转义需要确认内容;或者要给少量文案生成转义形式。
这类工具的操作通常是粘贴、点转换、复制结果三步。上手前要区分它提供的方向:中文转 Unicode 与 Unicode 转中文是两个方向,别把结果粘错框。
在线方式的边界也很清楚:不适合批量、不适合放进自动化流程、不适合处理含敏感信息的内容。这些场景请走第二种。
三、第二种:用语言内置函数,适合写进代码
要长期复用的编码转换应该落在代码里,而不是每次手点。
s = "中文"
print(s.encode("utf-8"))
# 预期输出:b'\xe4\xb8\xad\xe6\x96\x87'

print(s.encode("unicode_escape"))
# 预期输出:b'\\u4e2d\\u6587'

print(b'\\u4e2d\\u6587'.decode("unicode_escape"))
# 预期输出:中文
这三行分别对应"得到 UTF-8 字节"、"得到转义形式"、"把转义还原成原文"。第三个方向就是从接口日志反查内容的标准动作。
浏览器与 Node 里的等价写法:
const bytes = new TextEncoder().encode('中文')
console.log(Array.from(bytes))
// 预期输出:[228, 184, 173, 230, 150, 135]

console.log('中'.charCodeAt(0).toString(16))
// 预期输出:4e2d
这里要先说清一件事:charCodeAt 取到的是 UTF-16 的码元,对绝大多数常用汉字来说与 Unicode 编号一致,但对超出基本平面的字符(比如部分 emoji)会返回一对代理项,需要按码点处理。
命令行批量转码时可以直接用转换工具:
iconv -f GBK -t UTF-8 input.txt > output.txt这条命令把按 GBK 编码的文件转成 UTF-8。预期结果(未在本机执行)是新文件用 UTF-8 打开不再乱码。
浏览器端的写法细节记不清时,翻 JavaScript 速查手册 核对一遍最省事。
四、乱码的排查路径与三个坑
坑一:读写两侧用的不是同一套编码。 文件以 GBK 写入、用 UTF-8 打开,就会得到一堆无法识别的字符。修复方式不是"再转一次",而是先确认写入侧的编码,再用 iconv 之类工具按真实编码做一次转换。
坑二:重复编码。 已经转成转义串的内容又被转一次,会出现双重反斜杠。判断方法是看字符串里有没有成对出现的连续反斜杠。
坑三:把代理对当成一个字符处理。 部分字符由两个码元组成,按字符数截断会把它们切开,得到两个无法显示的半个字符。处理这类字符时要按码点遍历,而不是按下标遍历。
排查顺序(预期结果,未在本机执行):
- 检查:确认内容里的是 UTF-8 字节、转义串,还是 Base64,三者处理方式不同;
- 运行:按第三种的写法跑一次解码,看能否还原;
- 预期:还原后是可读的中文,且长度符合字符数而不是字节数;
- 失败:出现问号或方框,说明读写编码不一致,回到坑一;
- 修复:按真实来源编码做一次转换,不要反复尝试各种编码组合;
- 验证:把结果写回文件再用 UTF-8 打开,确认不再出现替代字符。
总结
编码转换不需要背规则,只需要分清三件事:字符集、存储编码、传输编码各自解决什么问题,然后选对工具。
四条带走:
- 临时核对用在线工具,长期用内置函数,别手写转换;
- Unicode 转义、UTF-8 字节、Base64 是三件不同的事;
- 乱码先找读写两侧各用了哪套编码,再动手转;
- 超出基本平面的字符按码点处理,别按字符下标截断。
下一步建议给项目里所有读写文件的调用点统一显式指定编码,不要依赖运行环境的默认值。
常见问题
Q:接口返回的 \u4e2d\u6587 怎么变成中文?
A:这是一串 Unicode 转义文本,用语言内置的转义解码即可,Python 里是 unicode_escape,JavaScript 里可以用 JSON 解析直接还原。
Q:文件打开全是问号,是文件坏了吗?
A:多数不是。文件只是用另一套编码写的,用读取侧没指定的那套编码打开就会这样。确认写入侧编码后用转换工具转一次即可。
Q:Base64 能解决乱码吗?
A:不能。Base64 只负责把二进制变成可打印文本,它不参与字符集的转换,乱码问题要在编码那一层解决。
Q:为什么一个 emoji 的长度算出来是 2?
A:因为它由一对代理项组成。按码点遍历才能得到正确的字符数,按下标取会把它们看成两个字符。
Q:中文在 UTF-8 里占几个字节?
A:常用汉字是三个字节,部分扩展区的字符会占四个。用字节长度做截断时务必留意这个差异。
延伸学习
想把编码这块弄清楚,可以按这个顺序来:
- 想补一遍前端里的字符处理,Web前端入门扫盲课程 可以跟一遍;
- 读一篇相关笔记 字符编码是什么,看字符集与编码规则的关系;
- 想随手验证一段转义,用 中文与Unicode互转 最快。