
 TRAE-AI编程

Go 字符编码校验要不要做,取决于数据有没有离开过 Go 的 UTF-8 约定:内存内生成的字符串不用管,外部字节流必须先用 utf8.ValidString 校验,再用 golang.org/x/text 做字符集转换统一成 UTF-8。用 Go 读取外部文件、接口返回或用户上传的内容时,经常会遇到乱码:明明写进去是中文,读出来却是一串问号。本文附 3 种实用的校验与转换方法,并讲清什么时候该管、什么时候可以不管。Go 字符编码这个话题看似底层,却直接影响字符串的 len()、下标切分和正则匹配是否正确,忽略它迟早会在生产环境爆出乱码故障。
先看结论
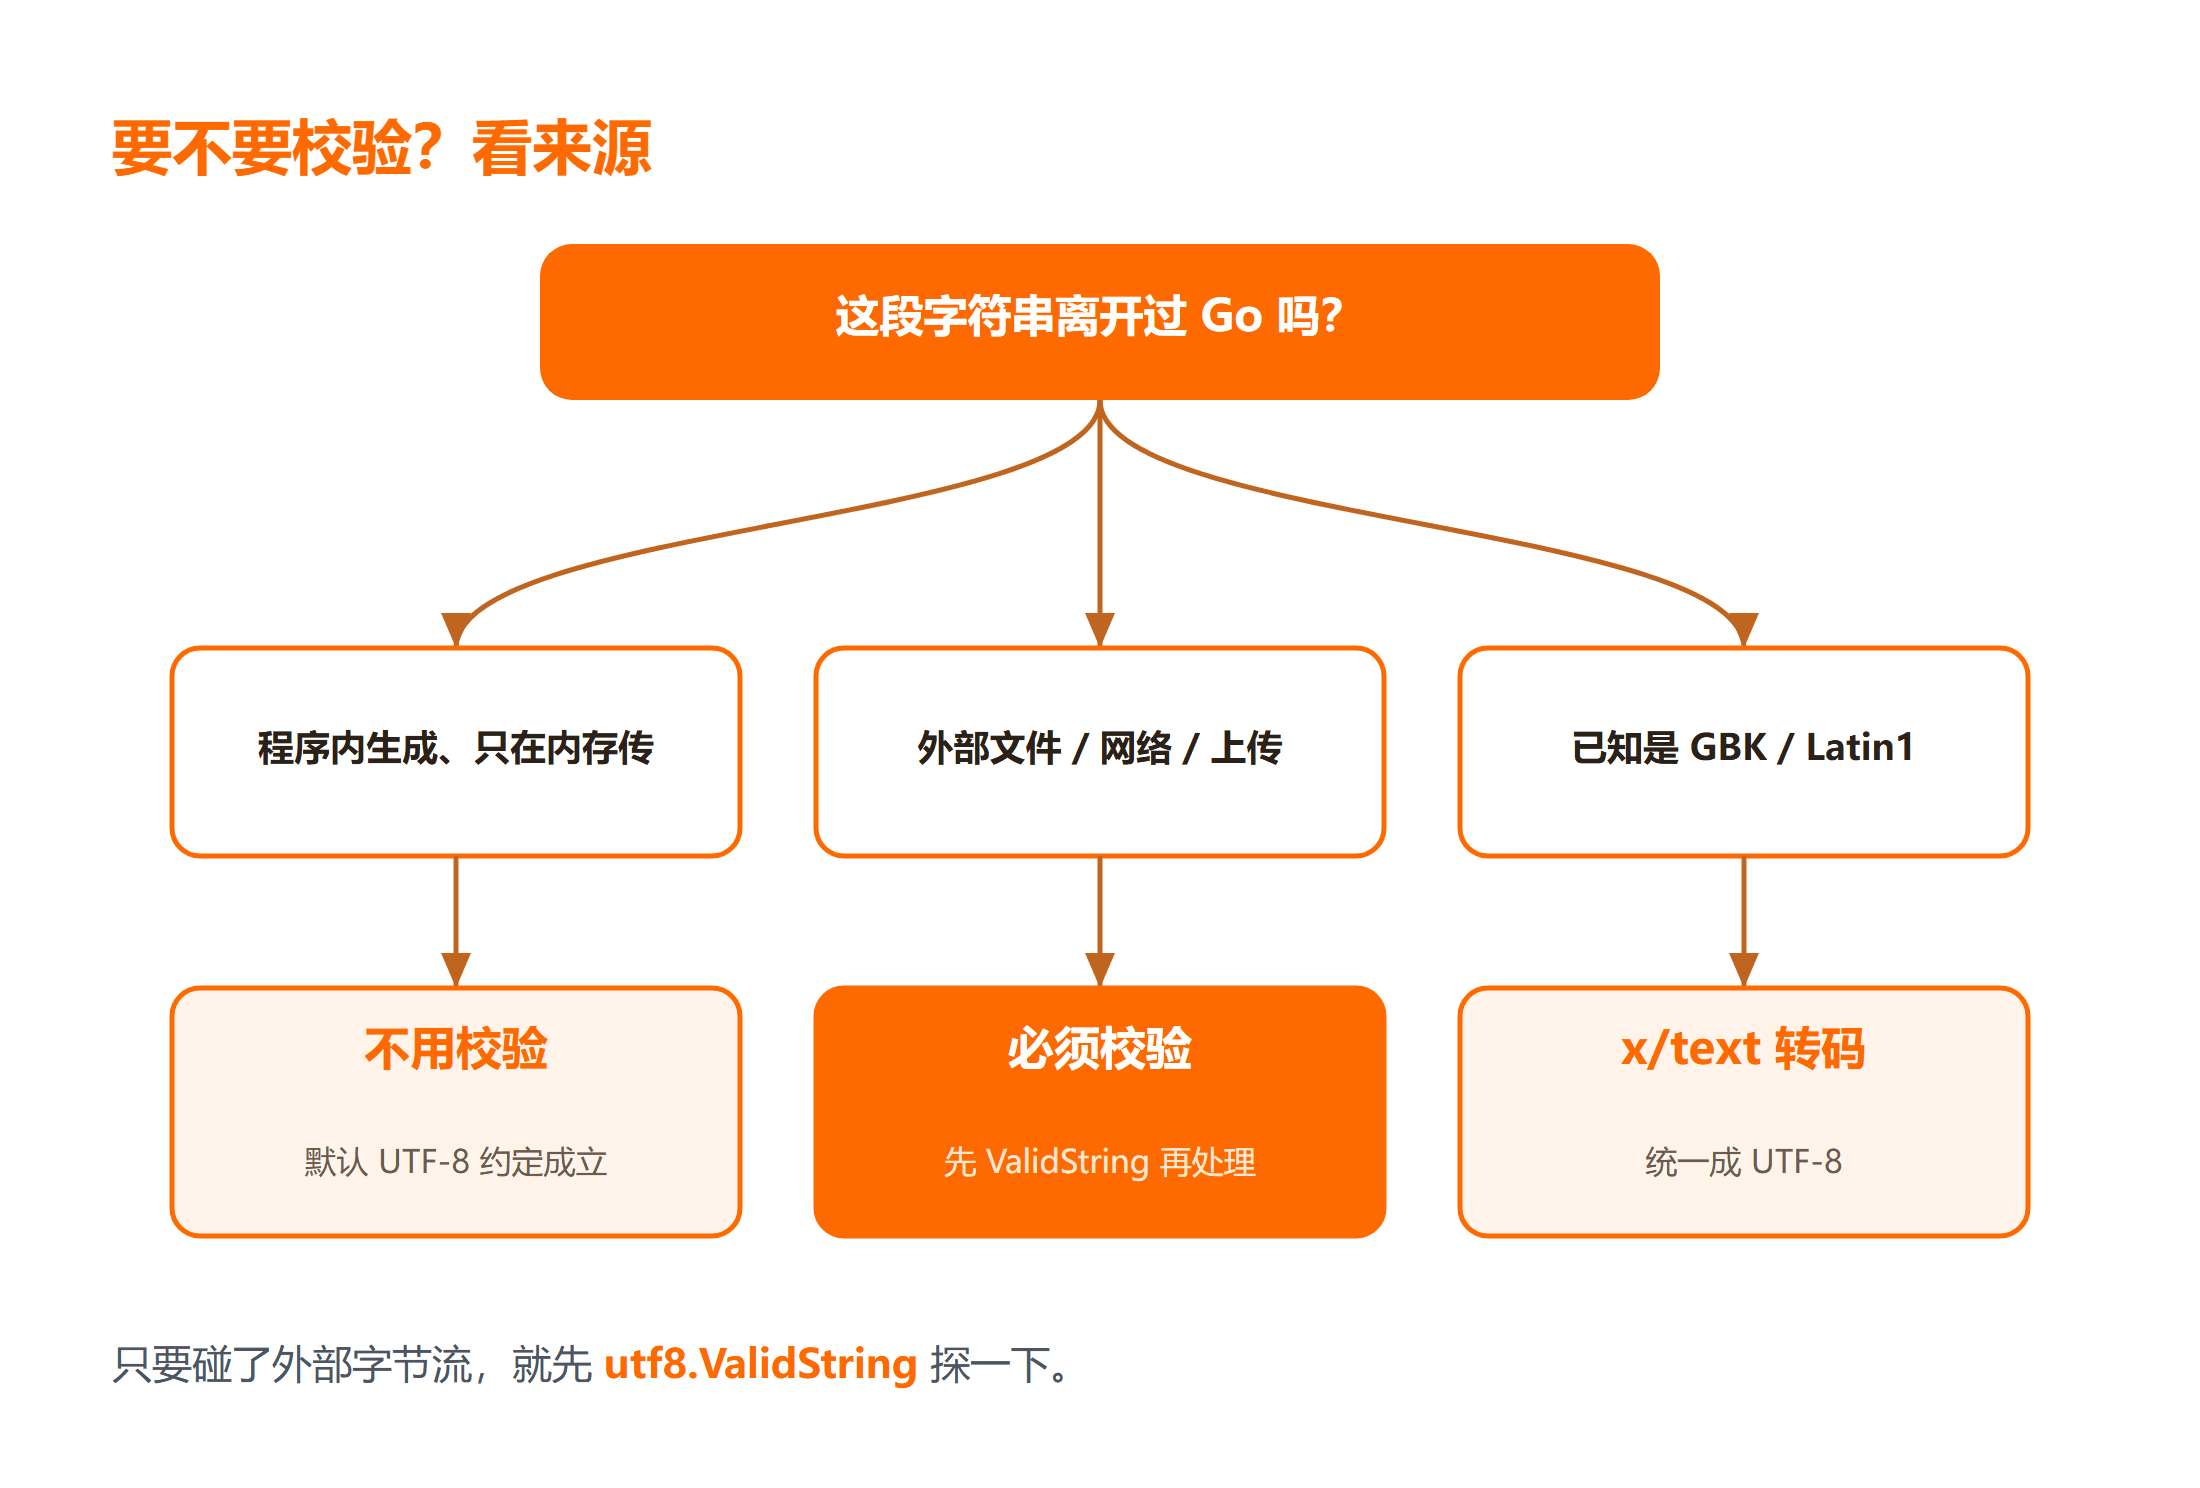
Go 的字符串在语言层面默认按 UTF-8 解读,但这只是「约定」,不是「保证」。数据来自外部字节流时,UTF-8 校验不能省:先用 utf8.ValidString 判断是不是合法 UTF-8,不是就用 golang.org/x/text 做字符集转换,从源头把编码统一成 UTF-8。纯内存里拼出来的字符串,不必额外校验。这套 Go 字符编码处理链路,核心是在边界处一次性处理干净。
一、Go 字符串的编码约定
Go 源码文件本身是 UTF-8,字符串类型存的是「字节序列」,标准库也都按 UTF-8 解读。问题在于:从文件、网络、数据库拿到的 []byte 未必是 UTF-8。直接当字符串用,遇到 GBK 字节就显示成乱码,更严重的是 len() 按字节算、下标切分可能切断一个中文的编码,产生非法 UTF-8 片段。关于更底层的运行机制,可以先看 Go 底层原理 里对字符串存储的讲解。
Go 字符编码的边界就在「外部字节流」四个字上。凡是从程序外部进来的数据,都应该假设它可能不是 UTF-8,先校验再使用。这个前置检查极轻量,却能在故障发生前拦掉大部分乱码。配置阶段建议把编码校验封装成一个统一入口,所有外部输入都从入口过一遍,而不是散落在业务代码里各自处理。
二、3 种校验与转换方法
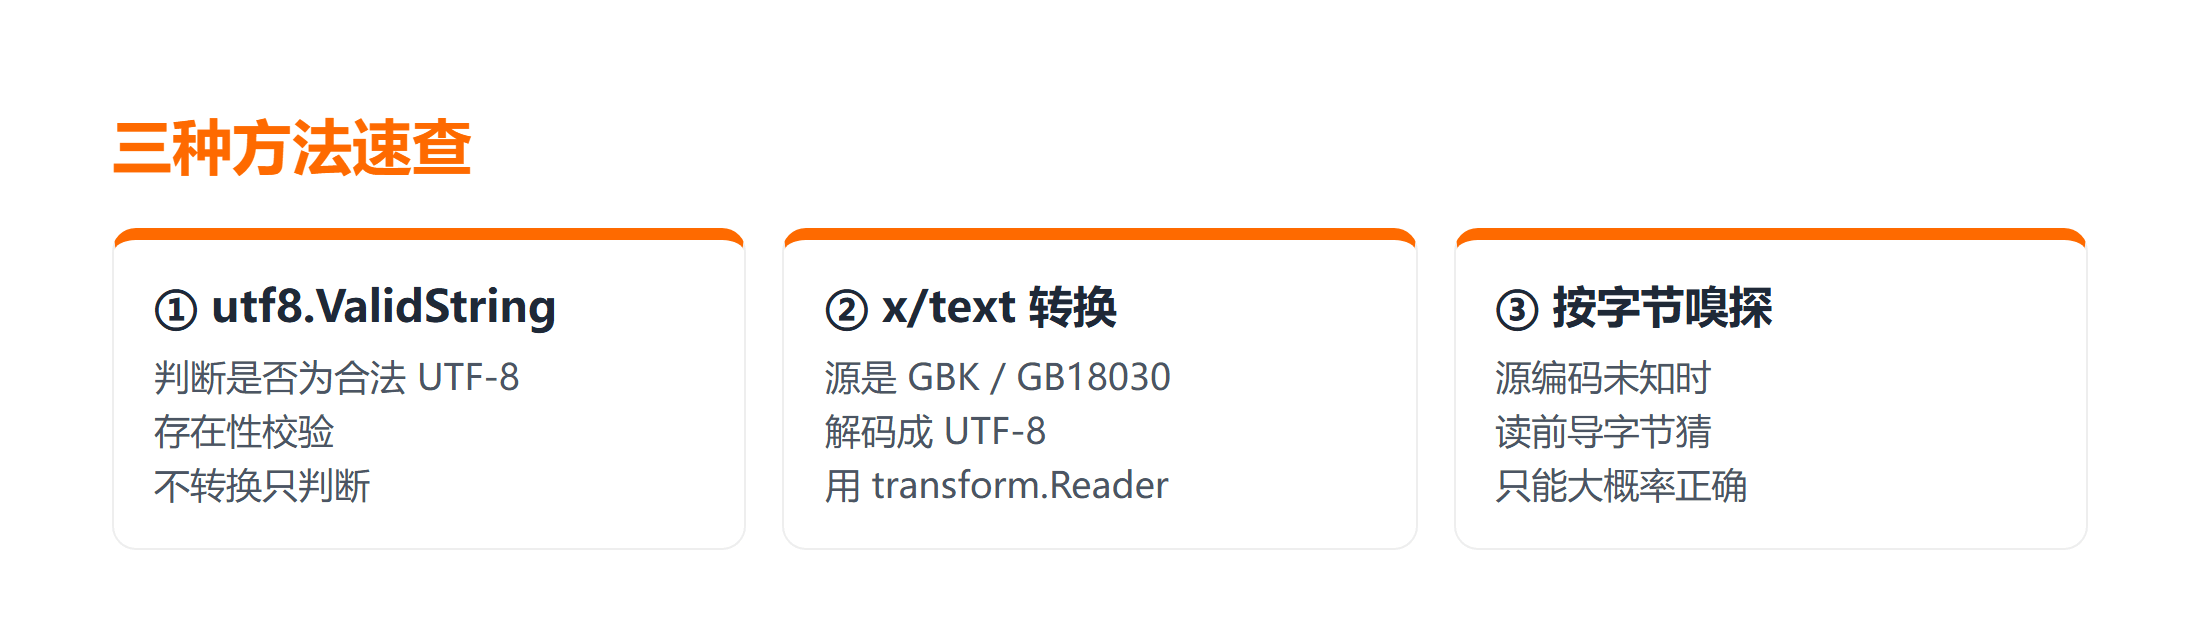
| 方法 | 用途 | 适用场景 |
|---|---|---|
utf8.ValidString |
判断是否为合法 UTF-8 | 快速存在性校验 |
golang.org/x/text |
做字符集转换 | 已知源是 GBK / GB18030 |
| 按字节嗅探 | 读取时探测编码 | 源编码未知 |
2.1 utf8.ValidString 做存在性校验
最轻量的做法,先确认字节是不是合法 UTF-8,再决定后续动作:
package main

import (
    "fmt"
    "unicode/utf8"
)

func main() {
    s := "中文"
    if utf8.ValidString(s) {
        fmt.Println("是合法 UTF-8,可直接处理")
    } else {
        fmt.Println("不是 UTF-8,需要先转码")
    }
}
这就是 Go 字符编码校验的第一道闸:utf8.ValidString 只判断、不转换,开销极低,适合在入口处批量使用。
2.2 golang.org/x/text 做字符集转换
当确认源是 GBK 时,用 golang.org/x/text 包的 simplifiedchinese 解码器把字节转成 UTF-8 字符串:
import (
    "io"
    "bytes"
    "golang.org/x/text/encoding/simplifiedchinese"
    "golang.org/x/text/transform"
)

func toUTF8(gbk []byte) (string, error) {
    r := transform.NewReader(bytes.NewReader(gbk), simplifiedchinese.GBK.NewDecoder())
    out, err := io.ReadAll(r)
    return string(out), err
}
这一步是真正的字符集转换,把非 UTF-8 字节流变成 Go 能安全处理的 UTF-8 字符串。不同系统的编码差异也可以对照 Windows 编码 里对字符集的说明。UTF-8 校验通过后再做转换,链路才完整。
2.3 读取时按字节嗅探
源编码未知时,可以先读前几个字节判断:有 BOM 大概率是 UTF-8 或 UTF-16,没有再结合内容特征猜。嗅探只能「大概率正确」,生产环境更推荐让上游明确告知编码,而不是靠猜。适用边界是:内部系统、编码可控,可以用嗅探快速兜底;对外接口、用户上传,一定要显式声明编码。
三、什么时候才需要校验(适用边界)
下面这些情况可以放心不做编码校验:字符串由 Go 代码字面量生成、只在本进程内传递、不接触任何外部字节流。下面这些情况必须校验:读取老系统导出的 .csv/.txt、对接只给 Latin1 的欧洲接口、解析用户上传的任意文件。边界就在「数据有没有离开过 Go 的 UTF-8 约定」。性能上,校验成本远低于出故障后的排查,属于典型的低成本高收益防护。
四、3 个常见错误
4.1 假设外部文件一定是 UTF-8
最典型的翻车:读 Windows 老文件直接 string(bytes),中文全变乱码。正确做法是先 utf8.ValidString 探一下,非法就走转换分支,不要默认源是 UTF-8。失败排查时先看原始字节,而不是盯着字符串变量发呆。
4.2 用 string 强转非 UTF-8 字节
string(gbkBytes) 只是把字节原样塞进字符串,并不会解码,后续按 rune 遍历会拿到错误字符。字节不是 UTF-8 时,必须走 transform.Reader 之类的真实解码,而不是类型强转。这个坑的修复方法是统一走字符集转换入口,禁止随手 string() 强转。
4.3 转换后忘记统一写回 UTF-8
解码成 UTF-8 字符串后,如果又按原编码写回文件,下游照样乱码。整个处理链路应当「进来的非 UTF-8 统一转成 UTF-8,出去也保持 UTF-8」,不要半路混用两种编码。预期结果是全链路只有 UTF-8 一种编码,后续所有字符串操作都安全。
⚠️ 注意:
golang.org/x/text需要额外go get引入,生产环境建议把它和项目依赖一起锁定版本,避免解码行为随小版本漂移。
总结
Go 字符编码校验要不要做,看数据是否离开过 UTF-8 约定:内存内生成的字符串不用管,外部字节流必须先用 utf8.ValidString 校验,再用 golang.org/x/text 做字符集转换统一成 UTF-8。三个坑记住——别默认外部文件是 UTF-8、别用 string() 强转非 UTF-8 字节、转换后全程保持 UTF-8。把编码在边界处一次性处理干净,后面的字符串操作才安全。
要点带走:
- 外部字节流必做 UTF-8 校验;
- 解码用
x/text,别用string()强转; - 整条链路统一成 UTF-8 再存储。
下一步可以了解 html/index 或 norm 包,处理更复杂的 Unicode 归一化需求。
常见问题
Q:Go 的 string 为什么不直接存 Unicode 码点?
A:Go 选择把字符串存成 UTF-8 字节序列,既省内存又兼容大量 C 生态接口;代价是需要 utf8 包来正确按字符而非字节操作。
Q:怎么判断一段字节到底是 GBK 还是 UTF-8?
A:先用 utf8.ValidString 试,能过基本就是 UTF-8;不过 GBK 有概率恰好也合法,关键数据应让上游显式声明编码,别只靠嗅探。
Q:x/text 转换失败会怎样?
A:解码器遇到无法映射的字节默认会替换成替换字符,不会直接 panic;若需要严格失败,可以用带 Discard 策略的 transform 来自行控制。
延伸学习
想继续把编码与工程化这块补齐,可以按这个顺序:
- 用 AI 辅助搭一个完整后台时,TRAE AI 开发 Python Django 后台管理系统 能边学边写;
- 关于「有没有必要」这类判断,程序员有没有必要成为业务领域专家?别走偏了! 的思路也值得一读;
- 手头有现成编码要互转,直接用 UTF-8编码转换 工具先验证结果。



