
 TRAE-AI编程

你搭了一个基于 Embedding 的检索,明明两句话意思差不多,余弦相似度算出来却偏低,把阈值调低又涌进一堆无关结果。先说结论:相似度阈值没有放之四海皆准的固定值,常见的写法有固定阈值、动态阈值和排序截断三种,选哪种取决于你的数据分布和召回目标。本文用可运行的 Python 示例讲清三种写法的实现、各自的适用边界,以及最容易被忽略的三个坑——向量未归一化、跨模型阈值不可比、阈值与召回率脱节。文中的数值为说明性示例,标注为预期结果(未在本机执行)。
先看结论
处理 Embedding 的相似度阈值,先分清两件事:你在算什么距离,以及你要达到什么召回目标。余弦相似度、点积、欧氏距离的数值范围不同,同一个阈值套上去含义完全不一样。
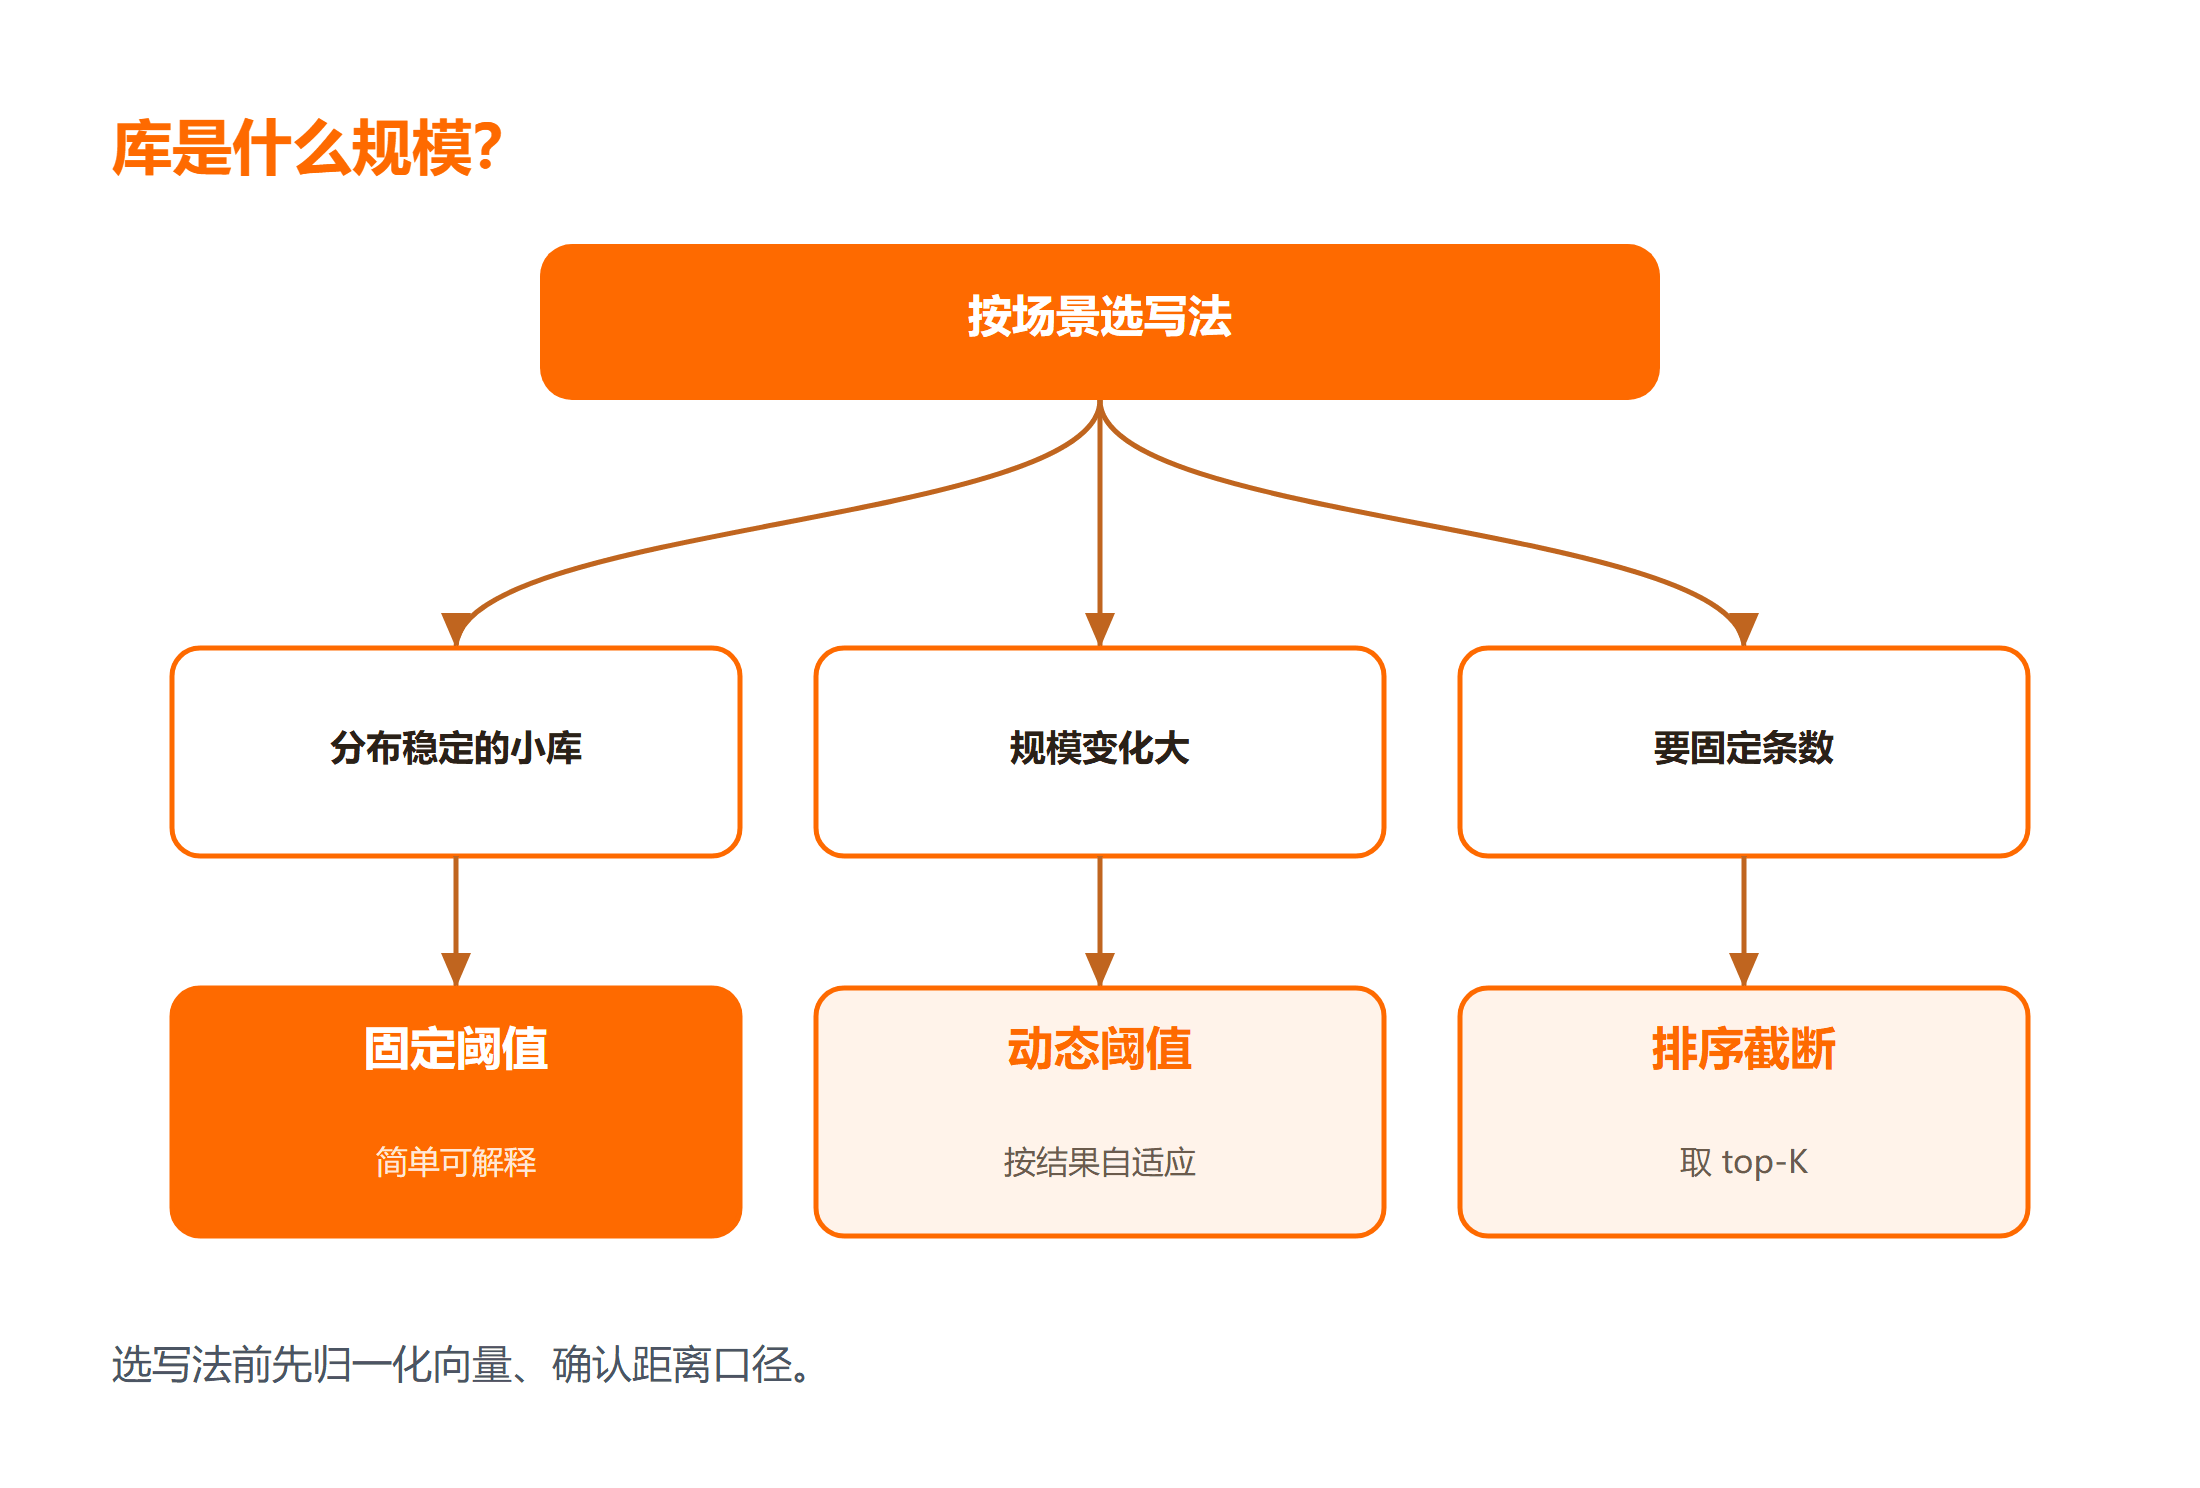
三种主流写法各有定位。固定阈值最简单,适合数据分布稳定的小库;动态阈值按查询结果分布自适应,适合规模变化大的场景;排序截断不设绝对阈值,只取最相似的 K 条,适合"永远返回固定条数"的产品逻辑。这些写法在检索增强类应用里很常见,配合 AI 编程技能教程 理解整体流程会更容易。
一、先确认三件事再动手
调阈值之前,先把基础打牢,否则后面所有调参都是空中楼阁。这一步的前置检查、后续配置和失败处理,决定了最终结果能不能复现。
第一,确认向量已归一化。余弦相似度要求向量归一化,否则算出来的数值没有一致的尺度。多数 Embedding 接口返回的是归一化向量,但自己后处理过就要重新确认。
第二,确认距离口径。搞清楚你的检索用的是余弦相似度、点积还是欧氏距离。数值越大越相似的(余弦、点积)和越大越不相似的(距离)阈值方向相反。
第三,确认评价标准。先准备几十条标注好的查询与期望结果,用它们来衡量阈值好坏,而不是靠肉眼感觉。没有评测集,调阈值就是凭运气。把这一步做好,后面无论用哪种工具或框架,判定标准都是一致的,可参考 Claude Code 编程技能教程 里对可验证输出的强调。
# Python 3.10+,示意:归一化后计算余弦相似度
import numpy as np

def normalize(v):
    return v / np.linalg.norm(v)

a = normalize(np.array([1.0, 2.0, 3.0]))
b = normalize(np.array([1.0, 2.0, 3.1]))
score = float(np.dot(a, b))  # 归一化后点积即余弦相似度
print("cosine:", round(score, 4))
预期结果(未在本机执行):输出接近 1 的数,表示两句高度相似。向量越长,点积越容易超过 1,这正是必须归一化的原因。
二、三种写法逐一实现
确认基础后,看三种写法怎么落地。下面给出可直接运行的配置片段,每段后面都附上预期输出与失败分支的处理方式。
写法一:固定阈值。 设一个常量,相似度超过它就认为匹配。实现最简单,可解释性最好。缺点是数据分布一变就失效。
写法二:动态阈值。 先取 top-K 结果,用其中最高分或均值乘以系数作为阈值。比如保留"不低于最高分 85%"的结果。好处是随查询自适应,坏处是结果条数不稳定。
写法三:排序截断。 完全不设相似度门槛,只返回最相似的前 K 条。产品上最常见,因为你永远想给用户几条结果。但它无法过滤"全部都不相关"的情况。
# 三种写法的核心片段(示意,score 已按降序排列)
def fixed(results, t=0.82):
    return [r for r in results if r["score"] >= t]

def dynamic(results, ratio=0.85):
    if not results:
        return []
    top = results[0]["score"] * ratio
    return [r for r in results if r["score"] >= top]

def top_k(results, k=5):
    return results[:k]
预期结果(未在本机执行):同一组结果在三种策略下返回条数不同。固定阈值可能返回 0 条,排序截断恒返回 5 条。
2.1 坑一:向量没归一化
这是最隐蔽的坑。非归一化向量的点积会随向量长度放大,同一个"相似度 0.85"在不同长度的向量上含义完全不同。表现是短文本相似度虚高、长文本虚低。解决办法是在入库和查询两端都做归一化,并把这一步写进数据处理流程。
三、把阈值和召回率挂钩
阈值好不好,最终要看业务指标,不是看数值本身。这里引入两个经常一起出现的概念:精确率关心"返回的是不是都对",召回率关心"该返回的有没有漏"。阈值调高,精确率上升、召回率下降;调低则相反。
所以调阈值的正确姿势是:先在标注集上画出阈值与精确率、召回率的关系,再按业务偏好选点。搜索联想宁可多返回几条让用户挑,阈值就偏低;自动合并重复内容宁可漏合也不能错合,阈值就偏高。
⚠️ 注意:不同模型输出的向量不在同一个空间里,阈值绝对不能跨模型直接复用。换 Embedding 模型必须重新标定阈值。
3.1 坑二与坑三
- 坑二:跨模型阈值不可比。 A 模型里 0.8 算相似,B 模型里可能 0.6 就算高。换模型后照搬旧阈值,结果会整体偏移。必须在新模型上重新跑一遍标注集。
- 坑三:只看相似度不看业务。 相似度是手段不是目的。两个文本语义接近但不该合并(比如同一问题的正反两问),再高的相似度也要靠业务规则挡住。
总结
Embedding 的相似度阈值有三种常见写法:固定阈值适合稳定小库,动态阈值适合规模多变的场景,排序截断适合固定条数的产品逻辑。无论选哪种,都要先归一化向量、确认距离口径、建立标注集。
要点带走:
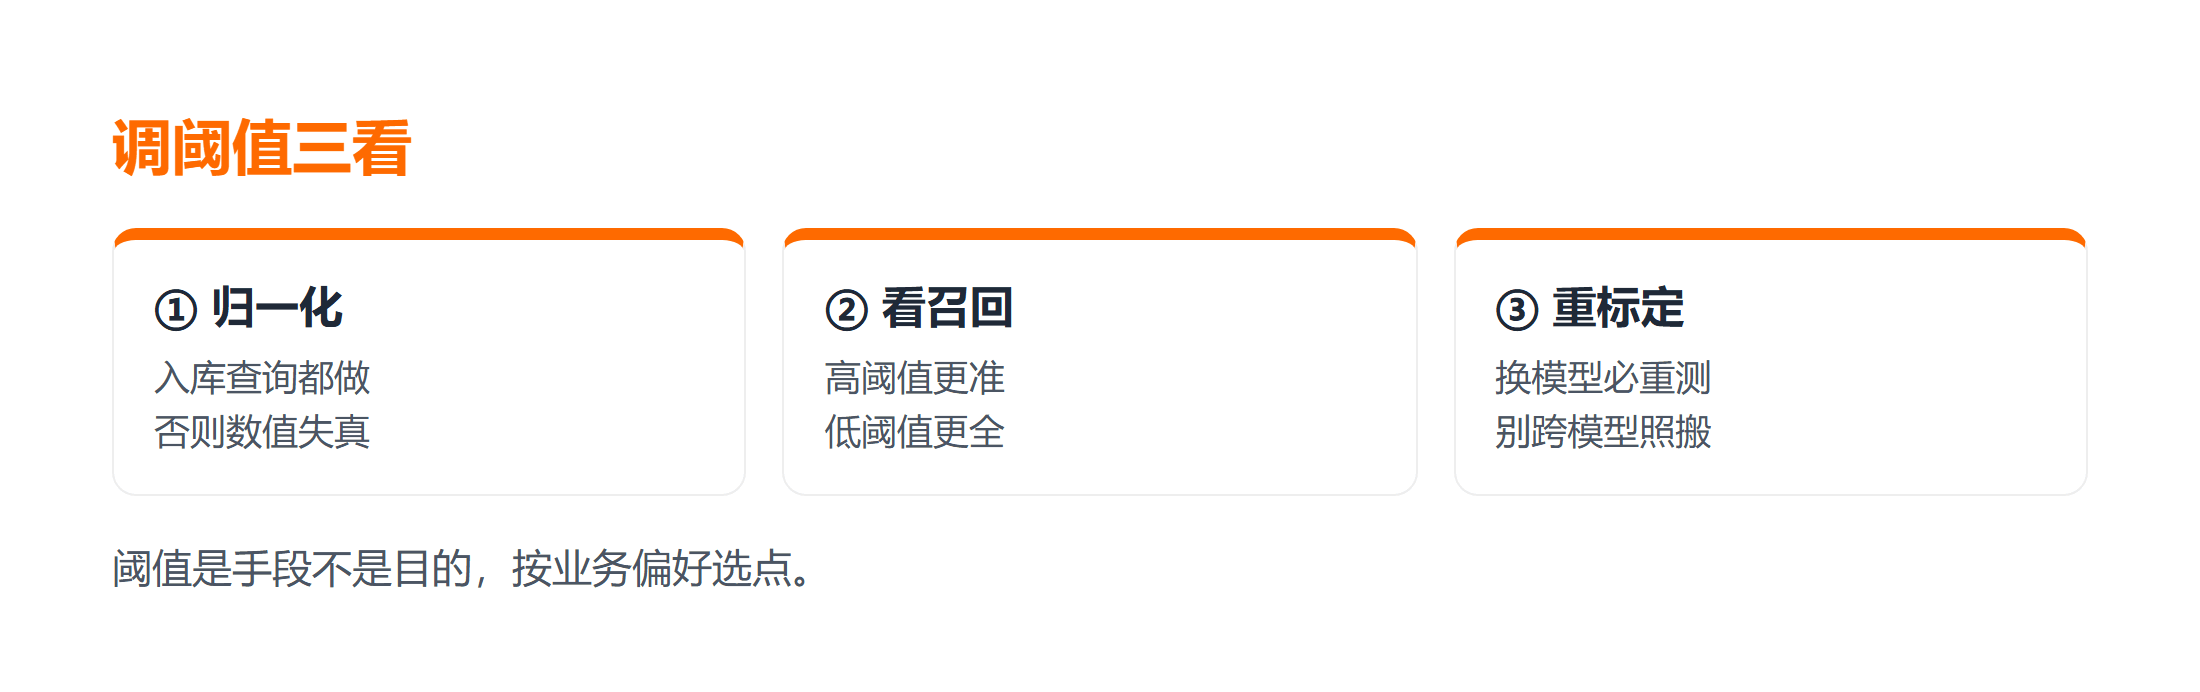
- 归一化是前提,否则相似度数值没有一致含义;
- 阈值和召回率是权衡关系,按业务偏好在标注集上选点;
- 换模型必须重新标定阈值,别跨模型照搬。
常见问题
Q:阈值设多少合适?
A:没有通用值。先在标注集上测出阈值与精确率、召回率的关系,再按业务偏好选点。固定阈值常从 0.8 附近起步试,但一定要用自己的数据验证。
Q:为什么短文本相似度总是虚高?
A:多半是向量没归一化,点积被长度放大。在入库和查询两端都做 L2 归一化,短文本虚高的问题通常就消失了。
Q:换了个 Embedding 模型,阈值还能用原来的吗?
A:不能。不同模型的向量空间不同,相似度分布也不同。必须在模型上重新标定阈值,否则结果会整体偏移。
延伸学习
想把这个知识点系统补齐,可以按这个顺序来:
- 先读 什么是 RAG?一文讲透 AI 检索增强生成的工作原理,理解相似度在检索里的位置;
- 想看同类"三种写法"的归纳思路,翻 Git 合并分支到底有哪几种写法?三种方式从用法到避坑一次讲清;
- 需要看 Embedding 服务的实际接口字段时,读 Xfyun Maas Embedding 对照向量输出格式。



